Convex Agent centraliza memória, threads e RAG para agentes de IA no mesmo backend serverless
O componente oficial @convex-dev/agent empacota threads, histórico persistente e busca híbrida de contexto dentro do mesmo banco serverless que o Convex já oferece, dispensando um vector DB separado para dar memória a agentes de IA.

O componente oficial @convex-dev/agent empacota threads, histórico persistente e busca híbrida de contexto dentro do mesmo banco serverless que o Convex já oferece, dispensando um vector DB separado para dar memória a agentes de IA↳Agentes de IA42 conteúdosOpera passa a integrar ChatGPT, Claude e outros agentes de IADev (Back & Front) · mar 2026Operações mais inteligentes, decisões mais rápidas: o impacto da IA agêntica na rotina de TIAI · abr 2026Adobe aposta em orquestração de agentes de IA: o que muda para devsDev (Back & Front) · abr 2026Ver tudo em AI →.
Quem constrói agentes de IA de forma convencional costuma acabar com o histórico de conversa, o contexto relevante e a lógica de negócio espalhados entre um banco relacional, um vector DB à parte e algum serviço de fila para workflows longos. O @convex-dev/agent é a resposta do Convex para isso: um componente que vive dentro do próprio banco serverless e trata threads, mensagens e busca de contexto como parte do mesmo sistema que já guarda os dados da aplicação.
Para quem já usa Convex como BaaS (o mesmo nicho de Supabase no fluxo de vibe coding), isso significa não precisar subir um Pinecone, um Redis para rate limit ou uma tabela paralela só para auditar o que o agente disse. A proposta é que tudo isso seja código Convex normal, rodando em actions, com reatividade no cliente herdada de graça.
Como o componente organiza threads e mensagens
No centro do Agent Component está a classe Agent, instanciada com um modelo de linguagem e instruções de sistema. O exemplo da documentação usa o convexGateway do pacote @convex-dev/ai-sdk-provider, que roteia chamadas para provedores como a OpenAI através do Convex AI Gateway:
import { Agent } from "@convex-dev/agent";
import { convexGateway } from "@convex-dev/ai-sdk-provider";
import { v } from "convex/values";
import { components } from "./_generated/api";
import { action } from "./_generated/server";

const supportAgent = new Agent(components.agent, {
 name: "Support Agent",
 languageModel: convexGateway("openai/gpt-5-mini"),
 instructions: "You are a helpful assistant.",
});

export const createThread = action({
 args: { prompt: v.string() },
 handler: async (ctx, { prompt }) => {
 const { threadId, thread } = await supportAgent.createThread(ctx);
 const result = await thread.generateText({ prompt });
 return { threadId, text: result.text };
 },
});
O ponto central é o createThread: ele devolve um threadId que o cliente guarda e reenvia depois. Numa chamada seguinte, continueThread(ctx, { threadId }) recupera a mesma conversa, com o histórico de mensagens anteriores injetado automaticamente no prompt, sem o desenvolvedor montar esse array manualmente.
Segundo a documentação, threads persistem mensagens e podem ser compartilhadas por múltiplos usuários e agentes, inclusive agentes humanos, o que reforça que o objeto central de persistência é a própria thread, não uma tabela paralela montada à mão.
Isso é o que a documentação chama de contexto automático: cada chamada ao modelo já inclui busca híbrida (vetorial e textual) nas mensagens da thread, decidindo o que é relevante trazer de volta sem que o código da aplicação precise implementar essa lógica de recuperação.
RAG, arquivos e workflows multi-etapa
Threads resolvem memória de curto prazo dentro de uma conversa, mas a documentação também cobre casos em que o agente precisa buscar informação de fora dela. Para isso existe integração com o RAG Component do próprio Convex, usado tanto para aumentar o prompt de antemão quanto como uma tool que o agente decide chamar durante a geração.
Arquivos entram na mesma mecânica de persistência: quando um agente recebe um PDF ou uma imagem como parte da conversa, o componente salva o arquivo no file storage do Convex e o referencia no histórico, então ele continua disponível se a thread for retomada dias depois.
Para fluxos que não cabem numa única chamada, o Workflows do Convex permite orquestrar etapas que podem envolver múltiplos agentes e múltiplos usuários, de forma durável e confiável, segundo a documentação. Na prática, isso sugere que, se o processo for interrompido, ele não precisa recomeçar do zero, embora a documentação não detalhe esse comportamento explicitamente.
Debugging, custo e limites de uso
Três recursos da documentação miram diretamente em operar o agente em produção, não só em prototipar:
- Agent Playground: interface para inspecionar metadados de cada chamada e iterar em prompts e configurações de contexto sem reescrever código.
- Usage tracking: contabiliza uso por usuário ou por time, viabilizando cobrança baseada em consumo real de tokens.
- Rate limiting: controla quantas interações um usuário pode fazer num período, tanto para proteger a aplicação quanto para não estourar o limite do provedor de LLM.
Esse conjunto é o que diferencia um componente de memória de uma simples wrapper de API: ele assume que o agente vai rodar com usuários reais, gastando dinheiro de verdade em tokens, e dá ferramentas para isso desde o início em vez de deixar para depois.
O que isso substitui, e quando não compensa
A comparação mais direta é com o que normalmente se monta à mão para dar memória a um agente: um vector DB separado, tabelas de histórico de conversa, uma fila para workflows longos e algum sistema próprio de rate limit.
| Necessidade do agente | Stack montada à mão | Convex Agent |
|---|---|---|
| Histórico de conversa persistente | Tabela própria + lógica de paginação | thread.generateText / continueThread nativos |
| Busca de contexto relevante | Vector DB externo (Pinecone, Weaviate) | Busca híbrida embutida na thread |
| Workflows multi-etapa duráveis | Fila (SQS, BullMQ) + orquestração manual | Workflows do Convex |
| Debug de prompts em produção | Logging customizado | Agent Playground |
A contrapartida é o lock-in: tudo isso só existe dentro do Convex. Se a aplicação já roda num stack com Postgres↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → e um orquestrador próprio, trocar de banco só para ganhar memória de agente é um custo de migração que a documentação não discute e que cada equipe precisa pesar.
Também vale notar que o exemplo oficial usa o Convex AI Gateway como intermediário de modelo, o que acopla a escolha do provedor de LLM a mais uma camada do Convex. Para quem já tem uma integração direta com OpenAI, Anthropic ou um provedor local funcionando, trocar essa camada é outro ponto de atrito a considerar antes de adotar o componente só pelo ganho de memória persistente.
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
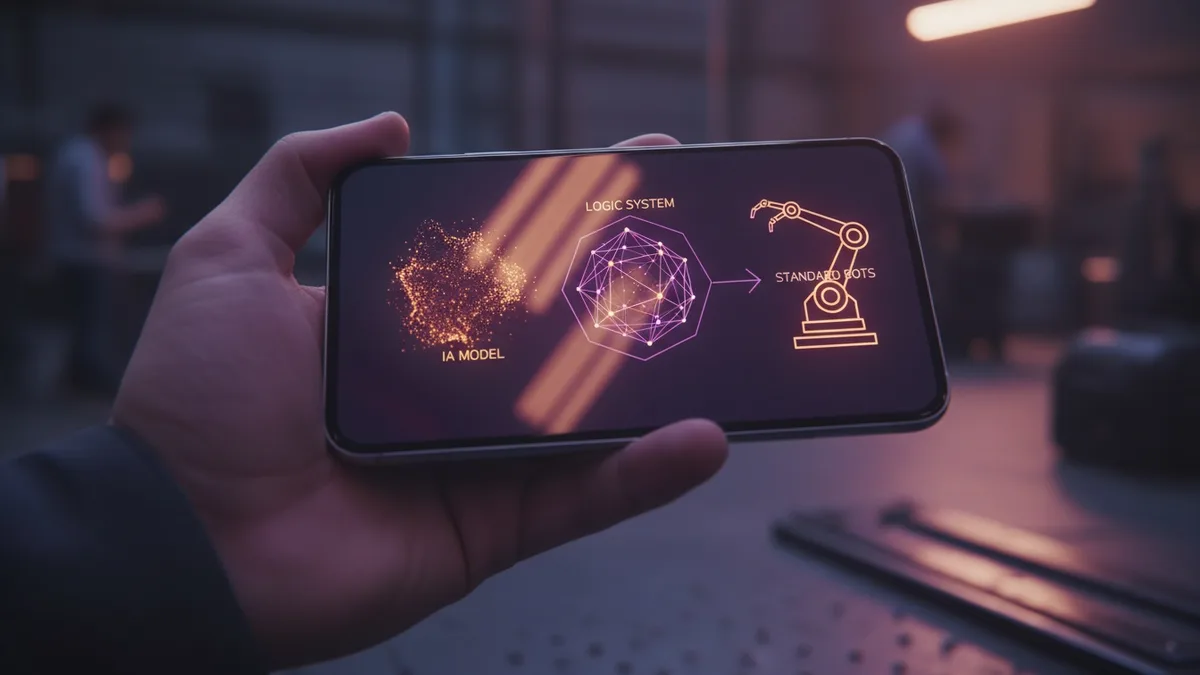
Standard Bots separa IA de lógica determinística para ganhar confiabilidade
A fabricante de robôs industriais Standard Bots trata o modelo de IA como uma peça do sistema, não como o sistema inteiro. Para quem constrói agentes de software, a lição de arquitetura vale tanto quanto a de dados.