- Leitura
- 5 min
- Tabelas
- 1
- Código
- 2
- Fontes
- 1
Correção no plugin llm-gemini revela que o Gemini 4 Hydrogen tem um nível de raciocínio extra, o xhigh, que multiplica o custo por token mas aproxima a qualidade da resposta do modelo topo de linha da família.
O llm, ferramenta de linha de comando criada por Simon Willison para rodar prompts contra dezenas de modelos sem sair do terminal, recebeu em 20 de novembro de 2026 a versão 0.38.1 do seu plugin llm-gemini. É um dot release, desses que normalmente passam batido, mas ele expõe um detalhe que muda a conta de quem usa a família Gemini 4 pela CLI: existe um nível de raciocínio chamado xhigh que nem todos os modelos da linha suportam, e o plugin estava ignorando ele.
O que o dot release corrige
Segundo Willison, o Gemini 4 Carbon aceita apenas os níveis low, medium e high de reasoning. Já o Gemini 4 Hydrogen e o Gemini 4 Neon têm um quarto nível, o xhigh, que ficou de fora quando esses modelos foram adicionados ao llm-gemini. A versão 0.38.1 fecha essa lacuna: quem atualizar o plugin passa a conseguir pedir explicitamente o nível mais alto de raciocínio nesses dois modelos.
A atualização é direta para quem já usa o llm:
llm install -U llm-geminiO comando atualiza o plugin para a 0.38.1 e destrava o xhigh como valor válido onde antes o parâmetro era silenciosamente limitado a high. Não é uma mudança de modelo, é uma correção de superfície: o Google já expunha o nível na API, o plugin que não repassava a opção corretamente.
Por que existem Carbon, Hydrogen e Neon com níveis diferentes
A fonte não detalha a hierarquia completa da família Gemini 4, mas o próprio comportamento dos modelos dá uma pista: o Carbon limita o reasoning a três degraus, enquanto Hydrogen e Neon vão a quatro. Isso sugere que Carbon é a variante mais enxuta da geração, pensada para respostas rápidas e baratas, e que Hydrogen e Neon reservam o xhigh como modo de raciocínio estendido para quando a tarefa realmente exige.
Isso importa para quem escolhe modelo via llm: a lista de reasoning_effort disponível não é igual entre modelos da mesma geração, e o plugin (ou o código que chama a API diretamente) precisa refletir isso. Um script que assume xhigh universal para "qualquer modelo Gemini 4" quebra ou é ignorado silenciosamente no Carbon.
O ajuste xhigh para o Hydrogen faz uma diferença significativa.
No original: The xhigh setting for Hydrogen makes a significant difference.
 Fonte: Simon Willison
O preço do xhigh, em números
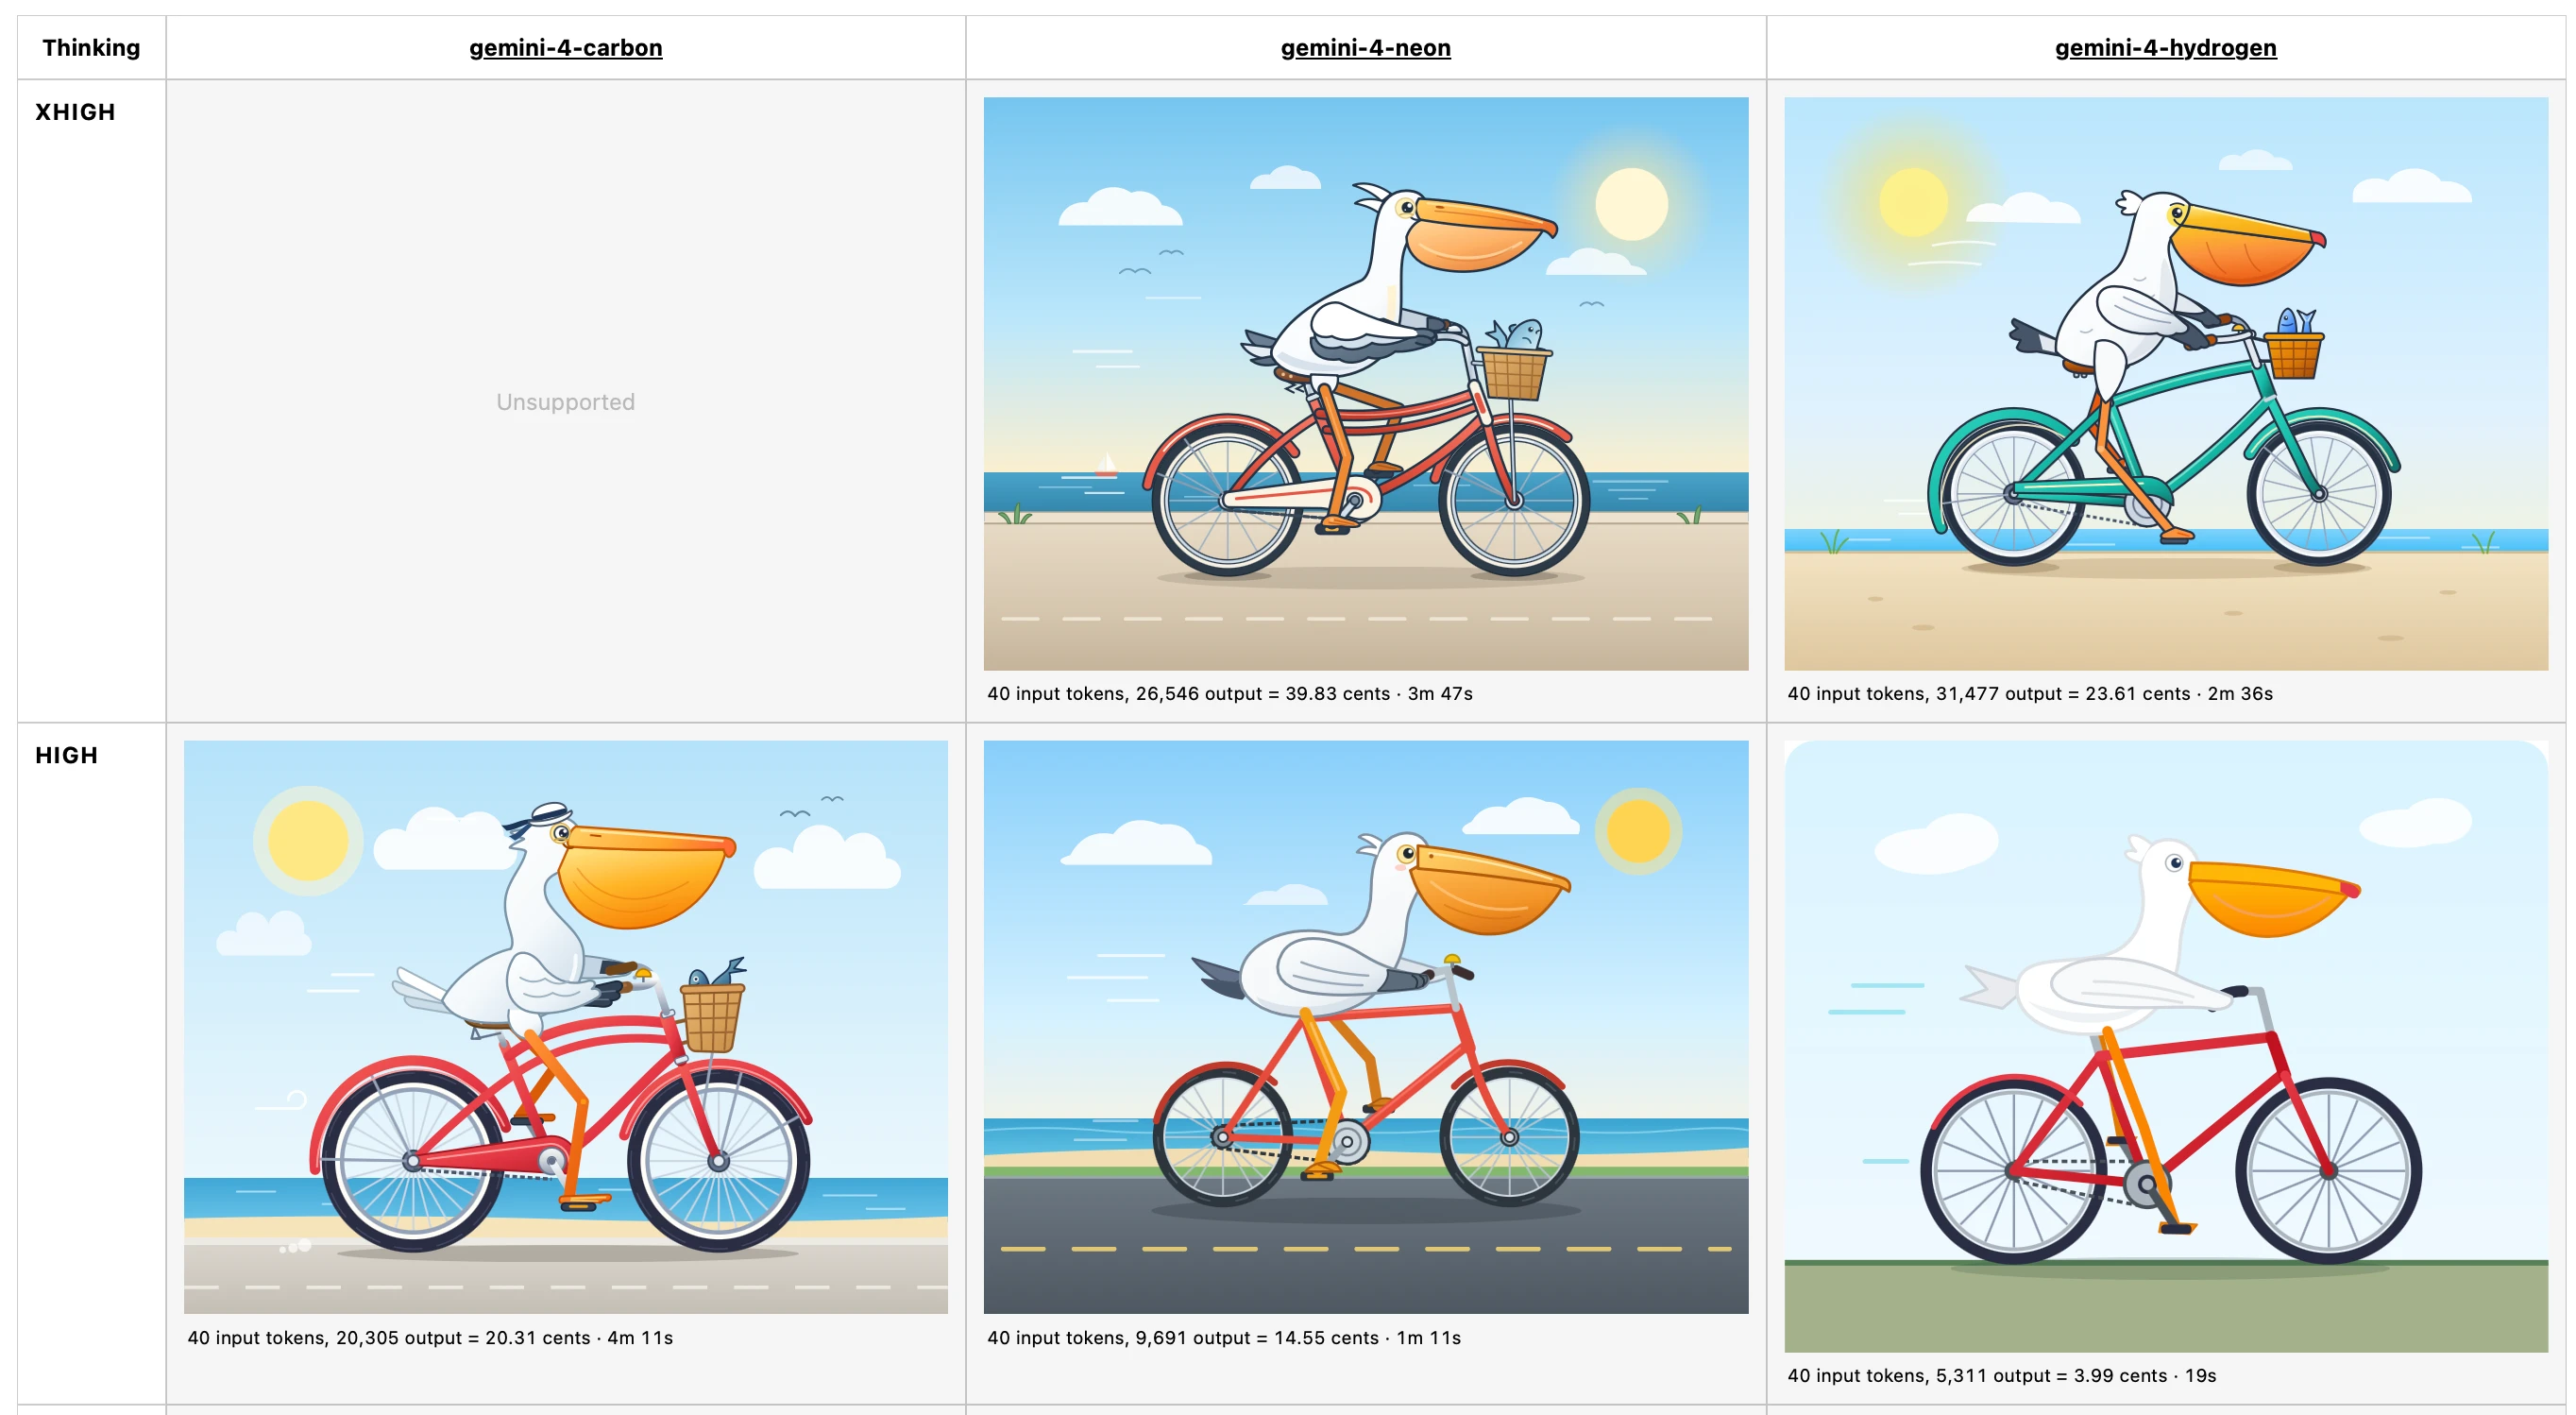
Willison atualizou sua grade de comparação de modelos Gemini 4 rodando o mesmo prompt no Hydrogen em high e em xhigh. A diferença é grande:
| Nível | Tokens de saída | Custo |
|---|---|---|
| high | 5.311 | 3,99 centavos |
| xhigh | 31.477 | 23,61 centavos |
São quase seis vezes mais tokens gerados e um custo cerca de seis vezes maior para a mesma pergunta. O ganho, segundo ele, apareceu na qualidade do resultado: o Hydrogen em xhigh produziu algo competitivo com o Gemini 4 Neon, modelo que custa mais por padrão.
O ajuste xhigh para o Hydrogen faz uma diferença significativa.
O benchmark do pelicano de bicicleta
O teste usado por Willison para comparar os modelos é o mesmo que ele roda há anos em toda release relevante de LLM↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI →: pedir que o modelo desenhe, em SVG, um pelicano andando de bicicleta. Não é um benchmark acadêmico, mas funciona bem como termômetro informal de raciocínio espacial e capacidade de gerar código visual coerente, porque o resultado é fácil de olhar e comparar a olho nu.
No caso do Hydrogen em xhigh, o pelicano resultante ficou, nas palavras de Willison, competitivo com o do Neon. Isso é um dado qualitativo, não uma métrica formal, mas é consistente com a lógica de reasoning: mais tokens de raciocínio antes da resposta final tendem a produzir SVGs com proporções e composição mais corretas, ao custo de gerar muito mais texto intermediário (que também é cobrado).
Como usar o xhigh na prática
O plugin llm-gemini já expõe o reasoning effort como opção de execução, seguindo o padrão que a ferramenta llm usa para parâmetros específicos de modelo. Quem já tinha o hábito de passar -o reasoning_effort high em chamadas ao Hydrogen ou ao Neon pode simplesmente trocar o valor:
llm -m gemini-4-hydrogen -o reasoning_effort xhigh "seu prompt aqui"O ponto de atenção é que essa troca de valor só funciona de fato depois do update para a 0.38.1: antes dela, o plugin não reconhecia xhigh como opção válida para esses dois modelos, mesmo que a API do Google já aceitasse o parâmetro.
Quando vale pagar o xhigh (e quando não vale)
Em resumo: o xhigh é uma troca explícita de custo por qualidade, não um upgrade gratuito. Vale considerar em cenários específicos:
- Tarefas de raciocínio em múltiplas etapas onde o
highjá erra com frequência e o custo por chamada é absorvível (geração de código complexo, análise de um documento longo, planejamento de agentes). - Pipelines de avaliação e comparação de modelos, onde entender o teto de qualidade do Hydrogen importa mais do que o custo de uma rodada de teste.
- Casos em que o
xhighdo Hydrogen evita migrar a chamada toda para o Neon, que normalmente já custa mais por token desde a entrada.
Em contrapartida, para volumes altos de chamadas simples, classificação, extração de dados estruturados ou qualquer tarefa onde o high já resolve, o xhigh só infla a conta: o salto de 5.311 para 31.477 tokens de saída em uma única resposta mostra como o custo escala rápido em produção, quando multiplicado por milhares de requisições diárias.
O caso também serve de lembrete para quem mantém integrações próprias com a API do Gemini sem passar pelo llm: níveis de reasoning variam por modelo dentro da mesma geração, e vale checar a documentação oficial do Google antes de assumir que todo parâmetro disponível num modelo está disponível nos demais.
Fonte: Simon Willison
Highlights
- Plugin llm-gemini 0.38.1 libera nível xhigh de reasoning para Gemini 4 Hydrogen e Neon
- xhigh multiplica saída para 31.477 tokens (vs 5.311 no high) e custo para 23,61 centavos (vs 3,99 centavos)
- Hydrogen em xhigh produz qualidade competitiva com Gemini 4 Neon por menos custo por padrão
- Diferentes modelos Gemini 4 suportam diferentes níveis: Carbon máximo high, Hydrogen e Neon têm xhigh
- xhigh compensa apenas em tarefas complexas de raciocínio; volume alto não justifica custo extra
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Fraude de tokens expõe como free trials de IA viram fazenda de conteúdo pirata
Claire Vo, criadora do ChatPRD, revela como grupos organizados exploram trials e cupons promocionais para sequestrar o agente de IA e usá-lo em negócios paralelos, como estúdios de mapas para Roblox e Fortnite.