Fine-tuning demora mais do que a conta de FLOPs promete, mostra estudo com 272 jobs reais


- Leitura
- 6 min
- Tabelas
- 2
- Fontes
- 1
Um estudo da Dharma-AI com 272 jobs reais de fine-tuning em GPUs H200 mostra que a fórmula clássica de FLOPs erra por horas, e propõe um modelo que acerta em minutos.
A conta que todo time de fine-tuning já fez
Quem treina modelo customizado conhece a fórmula: multiplique o número de parâmetros (P) pelo número de tokens de treino (D), multiplique por 6, divida pelo throughput das GPUs ajustado por um fator de aproveitamento chamado MFU (Model FLOPs Utilization). O resultado sai em horas e vira a estimativa que entra no cronograma do projeto.
O problema, segundo um estudo da Dharma-AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → publicado em 18 de novembro de 2026 no blog da Hugging Face, é que essa conta erra feio. Rodando a fórmula contra 272 jobs reais de fine-tuning supervisionado (SFT), os pesquisadores encontraram um R² de apenas 0,31 e um erro médio absoluto de 12,41 horas, mesmo usando o melhor valor de MFU testado (30%). Para jobs que duram em média 23 horas, é um erro do tamanho do próprio job.
272 jobs reais, 7.382 horas de GPU H200
A equipe da Dharma-AI (assinam o post Bruno Duarte, Gabriel Pimenta de Freitas Cardoso, Isis F Carvalho, Breno de Almeida Beleza e Felipe Lima) usou dados operacionais de um cluster de produção: entre 8 e 32 GPUs NVIDIA H200 distribuídas em 1 a 4 nós, rodando lado a lado com outras cargas de treino e inferência. Isso significa contenção real de rede e armazenamento, não um ambiente isolado de laboratório.
Os 272 runs cobrem famílias de modelo de até 15 bilhões de parâmetros, tanto LoRA quanto fine-tuning completo, com stacks de Hugging Face Transformers e Unsloth tratados como uma variável categórica, sem assumir ganho fixo de velocidade entre os dois. As durações variaram de 1,6 a 172,4 horas, com média de 23,43 horas e mediana de 15,29 horas.
O que a fórmula de FLOPs não enxerga
A equação que divide 6·P·D pelo produto entre número de GPUs, throughput de pico e MFU descreve bem o loop de otimização, mas um job de fine-tuning é muito mais que o loop. Antes do primeiro passo de treino, há setup de ambiente, download do modelo e tokenização. Durante o treino, há avaliações periódicas e upload de checkpoints. No fim, o modelo final vai para armazenamento de objetos, competindo por I/O com outros jobs do cluster.
Nada disso escala de forma previsível com o volume de computação. Dois jobs com o mesmo custo teórico em FLOPs podem terminar com horas de diferença, dependendo de quantas vezes avaliam o modelo, quantos checkpoints salvam e quanto tráfego de rede concorrente enfrentam.
Para não facilitar a comparação, o baseline de FLOPs usado no estudo já conta os tokens de avaliação programados além dos tokens de treino, e varia o MFU de 0,25 a 0,65 para dar à fórmula a melhor chance possível.
De R² 0,31 a R² 0,98
A alternativa proposta trata a duração como um problema de regressão supervisionada: dado um vetor de features extraído da configuração do job (hiperparâmetros, tamanho de dataset, identificadores de modelo, alocação de GPU), prever quanto tempo vai passar entre a GPU ser atribuída e o job terminar. Tudo isso é conhecido antes do job começar a rodar, o que é o que torna a previsão útil para quem agenda a fila do cluster.
Os pesquisadores testaram Linear Regression, Ridge, XGBoost e CatBoost, além de comparar contra o Calculon (Isaev et al., SC '23), um modelo analítico de desempenho de treino de LLM que os autores estenderam para cobrir LoRA, grouped-query attention, atenção fundida, bfloat16 e SwiGLU. Os resultados em validação cruzada de 5 folds:
| Modelo | R² | RMSE (h) | MAE (h) |
|---|---|---|---|
| FLOPs (MFU 30%) | 0,31 | 20,45 | 12,41 |
| FLOPs (MFU 45%) | 0,18 | 22,38 | 13,01 |
| FLOPs (MFU 60%) | 0,01 | 24,56 | 14,62 |
| Calculon | -0,51 | 30,40 | 20,36 |
| Linear Regression | 0,69 | 13,52 | 7,52 |
| Ridge | 0,73 | 12,72 | 7,23 |
| XGBoost | 0,97 | 4,18 | 1,95 |
| CatBoost | 0,98 | 3,52 | 1,71 |
O Calculon, mesmo sendo um modelo analítico bem mais detalhado que a conta de FLOPs, com grafo explícito de camadas, tráfego de memória e comunicação entre dispositivos, saiu pior: suas estimativas correspondem a uma mediana de apenas 11% do tempo real observado. Isso não invalida o Calculon como ferramenta de análise de passo de treino, que é para o que ele foi desenhado. Mas mostra quanto de um job de produção acontece fora do passo de otimização em si.
O CatBoost final usa 24 features, selecionadas entre 18 conjuntos candidatos por filtro de correlação, informação mútua e permutation importance, seguido de busca em grade com MAE como critério.
Os sinais que mais pesam
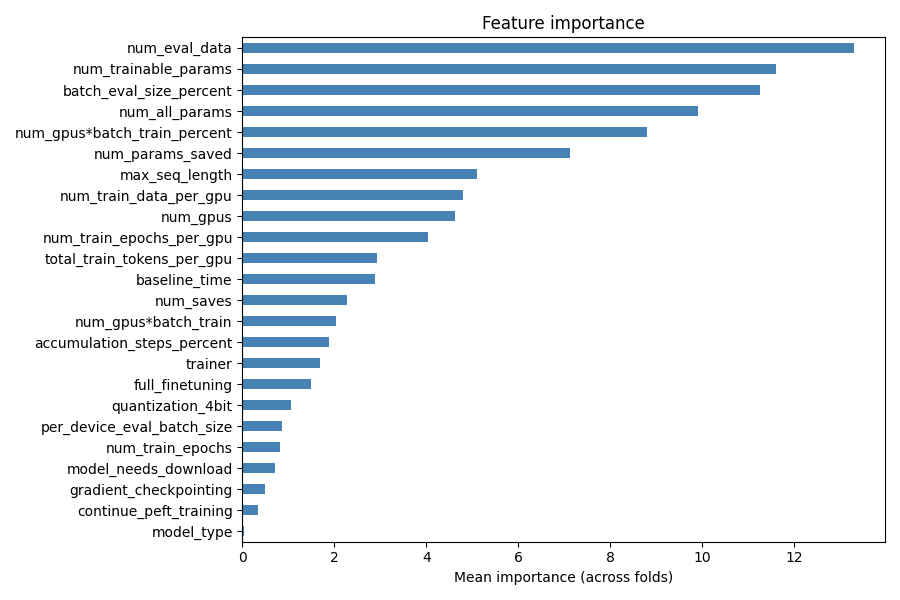
A importância de features do CatBoost se concentra em um punhado de variáveis, e nem todas são as óbvias. num_eval_data (total de amostras processadas em avaliação ao longo da vida do job) lidera, seguida por num_trainable_params, batch_eval_size_percent, num_all_params e a interação num_gpus*batch_train_percent, com num_params_saved logo atrás.
Em resumo: a frequência de avaliação, o tamanho do conjunto de avaliação e quantos checkpoints o job persiste pesam tanto quanto a escala do modelo e do dataset. São escolhas de configuração que times de ML costumam fazer por hábito, sem medir o impacto no tempo total.
Um ponto de atenção nos gráficos de SHAP: alocações maiores de GPU aparecem com contribuição positiva para o tempo previsto. Isso não significa que adicionar GPUs deixa o job mais lento. No dataset, jobs maiores tendem a usar mais GPUs, então num_gpus funciona em parte como proxy de escala do job.
Onde a previsão ainda erra
Olhando as 272 previsões fora da amostra, o erro absoluto mediano é de 0,51 hora; 80% das previsões ficam a até 2,20 horas do real, e 90% a até 4,31 horas. Mas o erro não é uniforme ao longo das faixas de duração:
| Duração do job (h) | Runs | Erro mediano (h) | P90 (h) |
|---|---|---|---|
| 1,56 a 5 | 60 | 0,30 | 1,55 |
| 5 a 10 | 63 | - | 1,27 |
| 10 a 30 | 69 | 0,73 | 4,17 |
| 30 a 60 | 67 | 1,06 | 5,50 |
| 60 a 175 | 13 | 5,19 | 18,51 |
Até 60 horas de duração, o erro mediano fica em torno de uma hora ou menos. Acima disso, a margem de erro cresce bastante, mas só há 13 runs nessa faixa no dataset, o que os próprios autores tratam como limitação de dados e não de método. Em um teste separado, aumentar a fração de dados de treino de 85% para 100% já reduziu o MAE de 1,63 para 1,50 hora, sem sinal de platô, sugerindo que mais dados históricos ainda ajudam.
O que fica de fora, e o que muda pra quem treina modelo aqui
O estudo tem recorte estreito por desenho: cobre só fine-tuning supervisionado, sem RLHF, DPO ou RLVR, só GPUs H200 (o modelo calibrado não deve ser esperado funcionar numericamente em outra geração sem retreino) e tem poucos runs muito longos. Os próprios autores já sinalizam a continuação: descritores de hardware para pools mistos, transfer learning para configurações com poucas observações e mais dados de runs longos.
Para quem monta ou opera cluster de GPU no Brasil, o achado prático independe de reproduzir o paper inteiro. A lição é que a conta de FLOPs nunca vai capturar o custo de avaliação, checkpoint e I/O compartilhado, então qualquer estimativa de prazo baseada só nela carrega um viés sistemático para baixo. Times que registram configuração de avaliação, política de checkpoint e carga por GPU dos seus próprios jobs já têm a matéria-prima para treinar um regressor parecido, em vez de herdar a estimativa otimista de uma fórmula de livro-texto.
O artigo completo, "Predicting End-to-End Fine-Tuning Time for Generative Language Models", deve sair em breve no arXiv segundo a Dharma-AI, com as fórmulas de feature, o processo de seleção e os hiperparâmetros finais detalhados para quem quiser reconstruir o pipeline sobre os próprios logs de execução.
Fonte: Hugging Face Blog
Highlights
- Estudo da Dharma-AI com 272 jobs reais mostra fórmula de FLOPs atinge apenas R² 0,31 e erra por média de 12,41 horas
- CatBoost regressor reduz erro médio absoluto para 1,71 hora e R² para 0,98 ao considerar frequência de avaliação, checkpoints e I/O
- Frequência de avaliação e política de checkpoint pesam tanto quanto escala do modelo e dataset nas previsões de duração real
- Modelo proposto acerta em até 2,20 horas para 80% das previsões em jobs de até 60 horas de duração
- Dados operacionais cobrem 272 runs de SFT em cluster H200 com 7.382 horas GPU, modelando contenção real de rede e armazenamento
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Agentes de IA no GKE: por que sessão não é request e como isso corta o custo do cluster
Um estudo com traces do GitHub Copilot mostra que agentes esperam cerca de 80% do tempo de sessão. O Google propõe hibernar essas sessões ociosas em object storage com Agent Substrate e AX, cortando até 40% do bill de nós no GKE.