Agentes de IA no GKE: por que sessão não é request e como isso corta o custo do cluster

- Leitura
- 8 min
- Tabelas
- 1
- Código
- 1
- Fontes
- 1
Um estudo com traces do GitHub Copilot mostra que agentes esperam cerca de 80% do tempo de sessão. O Google propõe hibernar essas sessões ociosas em object storage com Agent Substrate e AX, cortando até 40% do bill de nós no GKE.
Se você já colocou um agente de coding para rodar em cluster compartilhado, sabe o incômodo: a sessão fica aberta o dia inteiro, mas o desenvolvedor só manda prompt de vez em quando. O resto do tempo, o Pod está ali, reservado, consumindo quota, sem fazer nada. É exatamente esse ponto que Drake Williams (Senior PM do Google Cloud↳Google Cloud13 conteúdosPrograma da Google Cloud no Brasil projeta formar de forma gratuita 30 mil universitáriosDev (Back & Front) · mar 2026Google Cloud OnBoard capacita estudantes e desenvolvedores de TIGestão Dev & TI · mai 2019Desenvolvedores poderão participar de treinamento gratuito do Google CloudGestão Dev & TI · mai 2019Ver tudo em DevSecOps →) e Ivan Nardini (AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → DevRel) atacam num post publicado em 16 de novembro de 2026 no Google Developers Blog, e que vale a leitura de quem roda GKE para cargas agenticas.
Sessão não é request: o problema que motivou isso tudo
Um request HTTP dura milissegundos: o servidor responde, esquece tudo e atende o próximo. Kubernetes escala isso pelo volume de tráfego. Uma sessão de agente é outro animal: ela fica aberta o dia inteiro, guarda memória e arquivos entre prompts, e só trabalha quando um prompt chega.
O post cita um estudo de Banruo Liu e colegas sobre traces do GitHub Copilot: numa sessão típica com vários prompts, o agente espera pelo usuário cerca de 80% do tempo, e um turno completo (um prompt mais a resposta inteira do agente) consome em média 396,3 segundos de trabalho efetivo. Jogando isso num dia de trabalho de 8 horas com 2 prompts por hora (a premissa do próprio modelo de custo), o agente trabalha 22% do dia e espera os outros 78%.
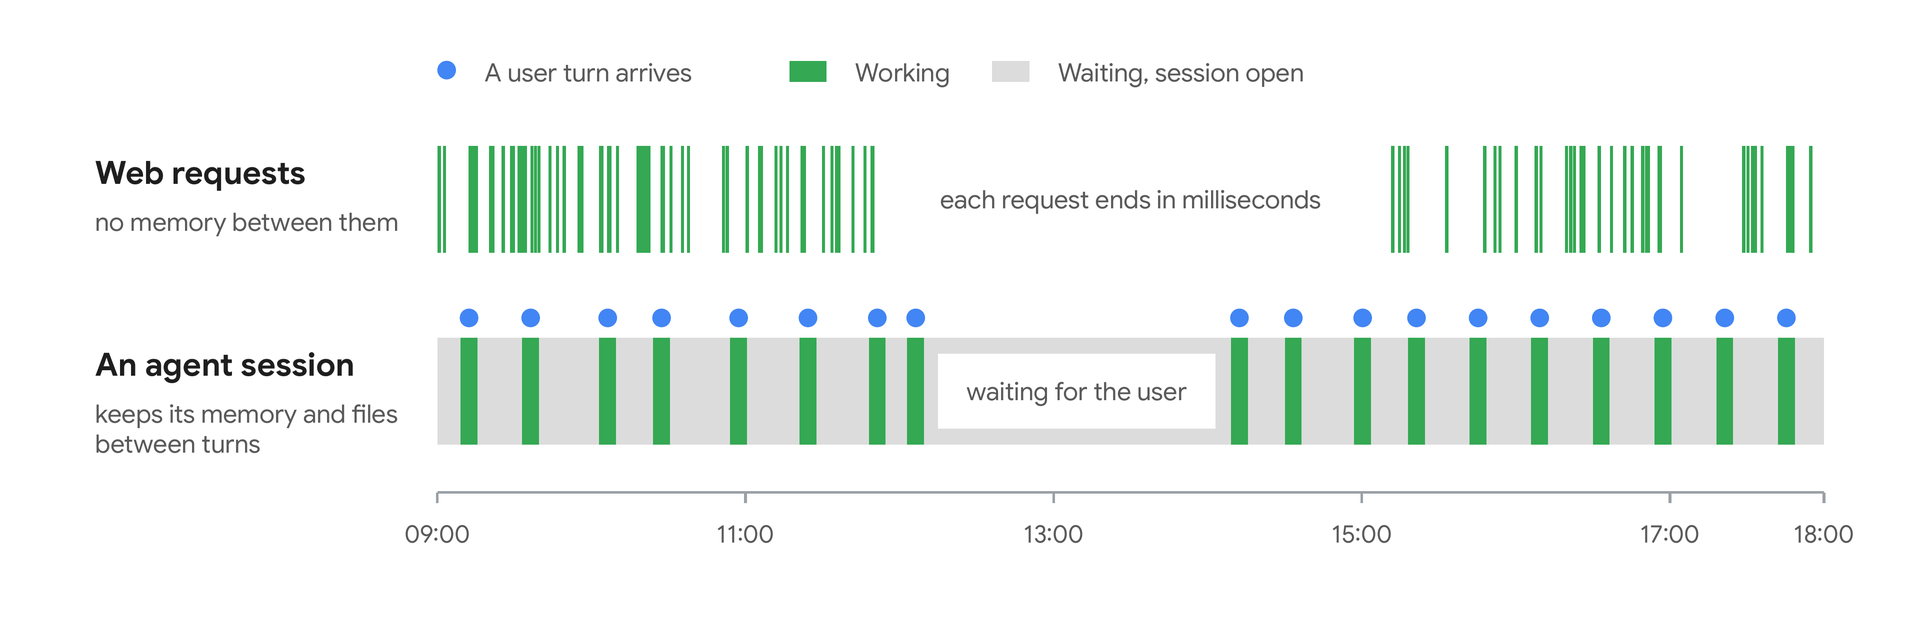
Se cada sessão prende uma máquina inteira, você paga por esses 78% parado.
As duas saídas óbvias, e por que nenhuma basta
Time que roda agente em GKE costuma escolher entre duas estratégias, as mesmas que funcionam bem para apps web:
- Um Pod por sessão: a sessão mantém estado, mas o Pod reserva
1 vCPUe1 GiBo dia inteiro. No modelo de custo do Google, um nóc3-standard-4cabe 3 desses Pods depois das reservas do GKE. Para 100 agentes de coding isso dá 34 nós e cerca de US$ 1.288 por mês, para agentes que só trabalham 22% do tempo. - Scale-to-zero entre prompts: o nó fica livre e os arquivos sobrevivem num volume persistente, mas o processo e sua memória não. O próximo prompt começa um agente do zero, perdendo o contexto em execução.
O terceiro caminho que o Google propõe é manter a sessão viva e devolver a máquina enquanto ela espera. É aqui que entram Agent Substrate e AX.
Actor, worker, Task: o vocabulário que você vai precisar
Agent Substrate e AX nasceram do projeto de código aberto↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) → que ganhou tração depois da doação do gVisor, do próprio Agent Substrate e do OpenRL para a CNCF em novembro de 2026. O Agent Substrate 1.0 está disponível em caráter geral (GA) no GKE desde então.
A separação de responsabilidades é clara: Agent Substrate responde onde e como um agente roda; AX responde o que o agente é. Um actor é o sandbox isolado de um agente, com seus processos, arquivos e identidade. Um worker é o Pod reutilizável tirado de um pool quente, e um único worker hospeda vários actors ao mesmo tempo. No vocabulário do AX, você declara uma Task (o que roda: imagem, comando, limites) e um Workspace (o que o agente conhece: repositórios e arquivos); AX executa cada Task como um actor do Agent Substrate.
numa sessão típica com vários prompts, o agente espera pelo usuário cerca de 80% do tempo
No original: in a typical session with several prompts, the agent waits for the user about 80% of the time
Vale notar o detalhe de segurança: como o agente executa código escrito por um modelo, qualquer coisa no ambiente pode vazar por prompt injection ou comando malicioso, chaves de API inclusive. Por isso gateways controlam o tráfego de entrada e saída do actor e injetam credenciais na saída com base na identidade do actor, de forma que o agente nunca segura a chave diretamente.
O parking: snapshot para object storage, não scale-to-zero
A peça que resolve o problema do custo chama-se SuspendActor. Ela tira um snapshot do actor ocioso e manda para object storage, liberando o worker para outro actor usar. Na próxima requisição, o actor é restaurado em qualquer worker quente disponível, diferente do scale-to-zero, que mata o processo de verdade.
No AX, o comando equivalente é ax suspend: ele estaciona a Task e preserva o /workspace. Hoje o AX pede um snapshot de volume, então os arquivos voltam no resume, mas os processos do agente começam frescos (isso está documentado no runner guide do projeto). O roadmap do AX promete adicionar orçamentos, políticas e gateways para controlar o que cada agente pode fazer, além de um registro do que cada task fez.
Dois detalhes que decidem a conta antes de você dimensionar o pool
Antes de sair redimensionando node pool, dois pontos do próprio post merecem atenção, porque mudam o resultado:
- O Agent Substrate não suspende sozinho (é a issue
#424em aberto no projeto). É o seu harness de agente, ou o serviço na frente dele, que precisa chamar a API de suspensão depois de um timeout de inatividade. Até lá, um actor ocioso segura seu worker normalmente. - Quando todos os workers estão ocupados, uma requisição por um novo actor espera até 5 segundos por padrão e depois falha com
HTTP 503, segundo a documentação do Agent Substrate.
Além disso, cada actor é dimensionado pelos seus limites de CPU e memória, e cada worker reserva esses limites contra a capacidade declarada para o pool. O modelo de custo do Google declara a capacidade igual à capacidade real do nó, então todo actor mantém seu limite integral. Nada impede declarar mais capacidade que o nó tem de verdade, só que aí o overcommit de CPU passa a acontecer no pool, não dentro de cada Pod.
Quanto dá para economizar (os números do modelo de custo do Google)
O modelo de custo do Google precifica tudo isso para os mesmos 100 agentes de coding, usando preço de lista do Google Cloud na região us-central1. Com timeout de 2 minutos de ociosidade, cada sessão segura um worker 29% do tempo em que está aberta. Um pool quente dimensionado para o percentil 99 de sessões segurando worker simultaneamente, mais 15% de folga, precisa de 15 nós, somados a 1 nó fixo para o control plane do Agent Substrate e seu banco PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data →, e a um job agendado que zera o pool fora do horário comercial.
você quer uma terceira opção: manter a sessão, e liberar a máquina enquanto a sessão espera
No original: you want a third option: keep the session, and free the machine while the session waits
 Fonte: Google Developers Blog
| Estratégia | Nós para 100 agentes | Custo aproximado | Observação |
|---|---|---|---|
| Pod por sessão | 34 | ~US$ 1.288/mês | CPU reservada o dia todo mesmo parado |
| Parking (2 prompts/hora) | 15 + 1 controle | ~40% menos, pelos números do post | Sessão sobrevive; worker é devolvido |
O pool fica cheio (gerando o 503) cerca de uma vez a cada 3.500 turnos, então o risco prático é baixo na taxa assumida. Mas a economia depende diretamente de quanto o agente trabalha: a 2 prompts por hora, a economia é de 40%; a 4 prompts por hora, o agente já trabalha 44% do tempo, o pool cresce para 27 nós, e a economia cai para 4%. Por volta de 4,5 prompts por hora, um Pod por sessão vira a opção mais barata. Antes de adotar parking, meça a taxa de prompts por hora dos seus usuários, não assuma a premissa do post.
O tamanho da frota também importa: o control plane do Agent Substrate custa o mesmo para 10 ou para 1.000 sessões, então o parking só compensa a partir de cerca de 37 sessões de coding agent, ou 13 sessões no caso de um assistente de chat que trabalha cerca de um minuto por hora.
Quando um Pod por sessão ainda vence
Existe uma variável que o cálculo acima ignora até aqui: overcommit. Se seus Pods pedem menos CPU do que o limite declarado, o Kubernetes agenda pelos requests, não pelos limites. Um Pod que pede 0.25 vCPU com limite de 1 vCPU empacota 12 por nó, então os mesmos 100 agentes cabem em 9 nós, menos do que o pool com parking. O próprio Agent Substrate também permite overcommit via capacidade declarada no worker pool, só que o modelo de custo do Google não precifica esse cenário.
O ponto cego do overcommit é o mesmo dos dois lados: agentes compartilham CPU e ficam lentos quando o vizinho está ocupado, tipicamente durante build e teste. A comparação honesta é sempre Pod contra actor com a mesma garantia de CPU, nunca Pod com request baixo contra actor com limite integral.
Como eu aplicaria isso no meu cluster
Se eu fosse testar isso num cluster real, o roteiro seria este:
- Puxar uma semana de prompts por hora dos logs do gateway de agentes e achar o horário de pico real, não o estimado.
- Comparar esse pico com os 4,5 prompts/hora citados no post como ponto de virada: abaixo disso, parking tende a compensar; acima, Pod por sessão fica mais barato.
- Instrumentar o harness do agente para chamar a API de suspensão depois de um timeout curto de ociosidade (o post usa 2 minutos como referência), já que o
#424confirma que isso não é automático. - Dimensionar o pool quente pelo percentil 99 de sessões simultâneas no horário de pico, com folga de 15%, e não pelo total de sessões abertas.
- Agendar um job que zera o pool fora do horário comercial, já que um pool quente rodando as 730 horas do mês custa cerca do dobro do modelo de Pod por sessão. Algo simples como:
gcloud container clusters resize agents-cluster \
  --node-pool=agent-substrate-pool \
  --num-nodes=0 \
  --zone=us-central1-a
Para quem quer seguir essa trilha, o ponto de partida é o guia de instalação do Agent Substrate 1.0 no GKE e a documentação oficial do projeto; quem acompanha o AX encontra o repositório no GitHub, ainda em desenvolvimento ativo antes da primeira versão estável, aceitando issues e feedback da comunidade.
Fonte: Google Developers Blog
Highlights
- Agent Substrate 1.0 está GA no GKE desde novembro de 2026 e economiza até 40% em 100 agentes a 2 prompts/hora
- Estudo de GitHub Copilot mostra agentes esperam 80% da sessão; Worker é devolvido enquanto sessão hibernada em object storage
- Decisão entre Pod por sessão (USD 1.288/mês para 100 agentes) ou parking (USD 772/mês estimado) depende taxa real de prompts/hora
- SuspendActor snapeia actor ocioso e libera worker; próximo acesso restaura em qualquer worker quente disponível
- Issue aberta #424 confirma suspensão não é automática; harness ou gateway deve chamar API após timeout de inatividade
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Cimed e Enter: quando o rosto do founder vira o canal de confiança da marca
No BRASA Summit Europa, Brunno Matias ouviu como Cimed e Enter usam a voz de quem faz o trabalho para construir confiança.