- Leitura
- 8 min
- Tabelas
- 1
- Código
- 1
- Fontes
- 1
O Google abriu nesta segunda-feira (16/11) o guia tpu-codesign, com oito princípios de arquitetura para alinhar LLMs e modelos MoE ao hardware das TPUs Ironwood e das próximas gerações, com ganhos medidos de até 57% em throughput de treino.
O que o Google publicou
O Google Developers Blog publicou nesta segunda-feira (16 de novembro de 2026) o repositório aberto AI-Hypercomputer/tpu-codesign, assinado por Gagik Amirkhanyan e Vaibhav Singh, engenheiros da equipe de TPU. O material não é mais um anúncio de hardware: é um guia de codesign, ou seja, de como desenhar a arquitetura do modelo (dimensões de camadas, roteamento de MoE, estratégia de paralelismo) já pensando no comportamento físico do chip, antes de escrever o primeiro passo de treino.
Isso importa porque o texto reconhece algo que todo time que já tentou portar um modelo de GPU para TPU sente na pele: decisão de forma de tensor tomada na definição do modelo vira teto permanente de MFU (Model FLOP Utilization), custo e latência de serving. Não dá para compensar depois com mais paralelismo ou mais chips.
Por que a arquitetura da TPU é diferente
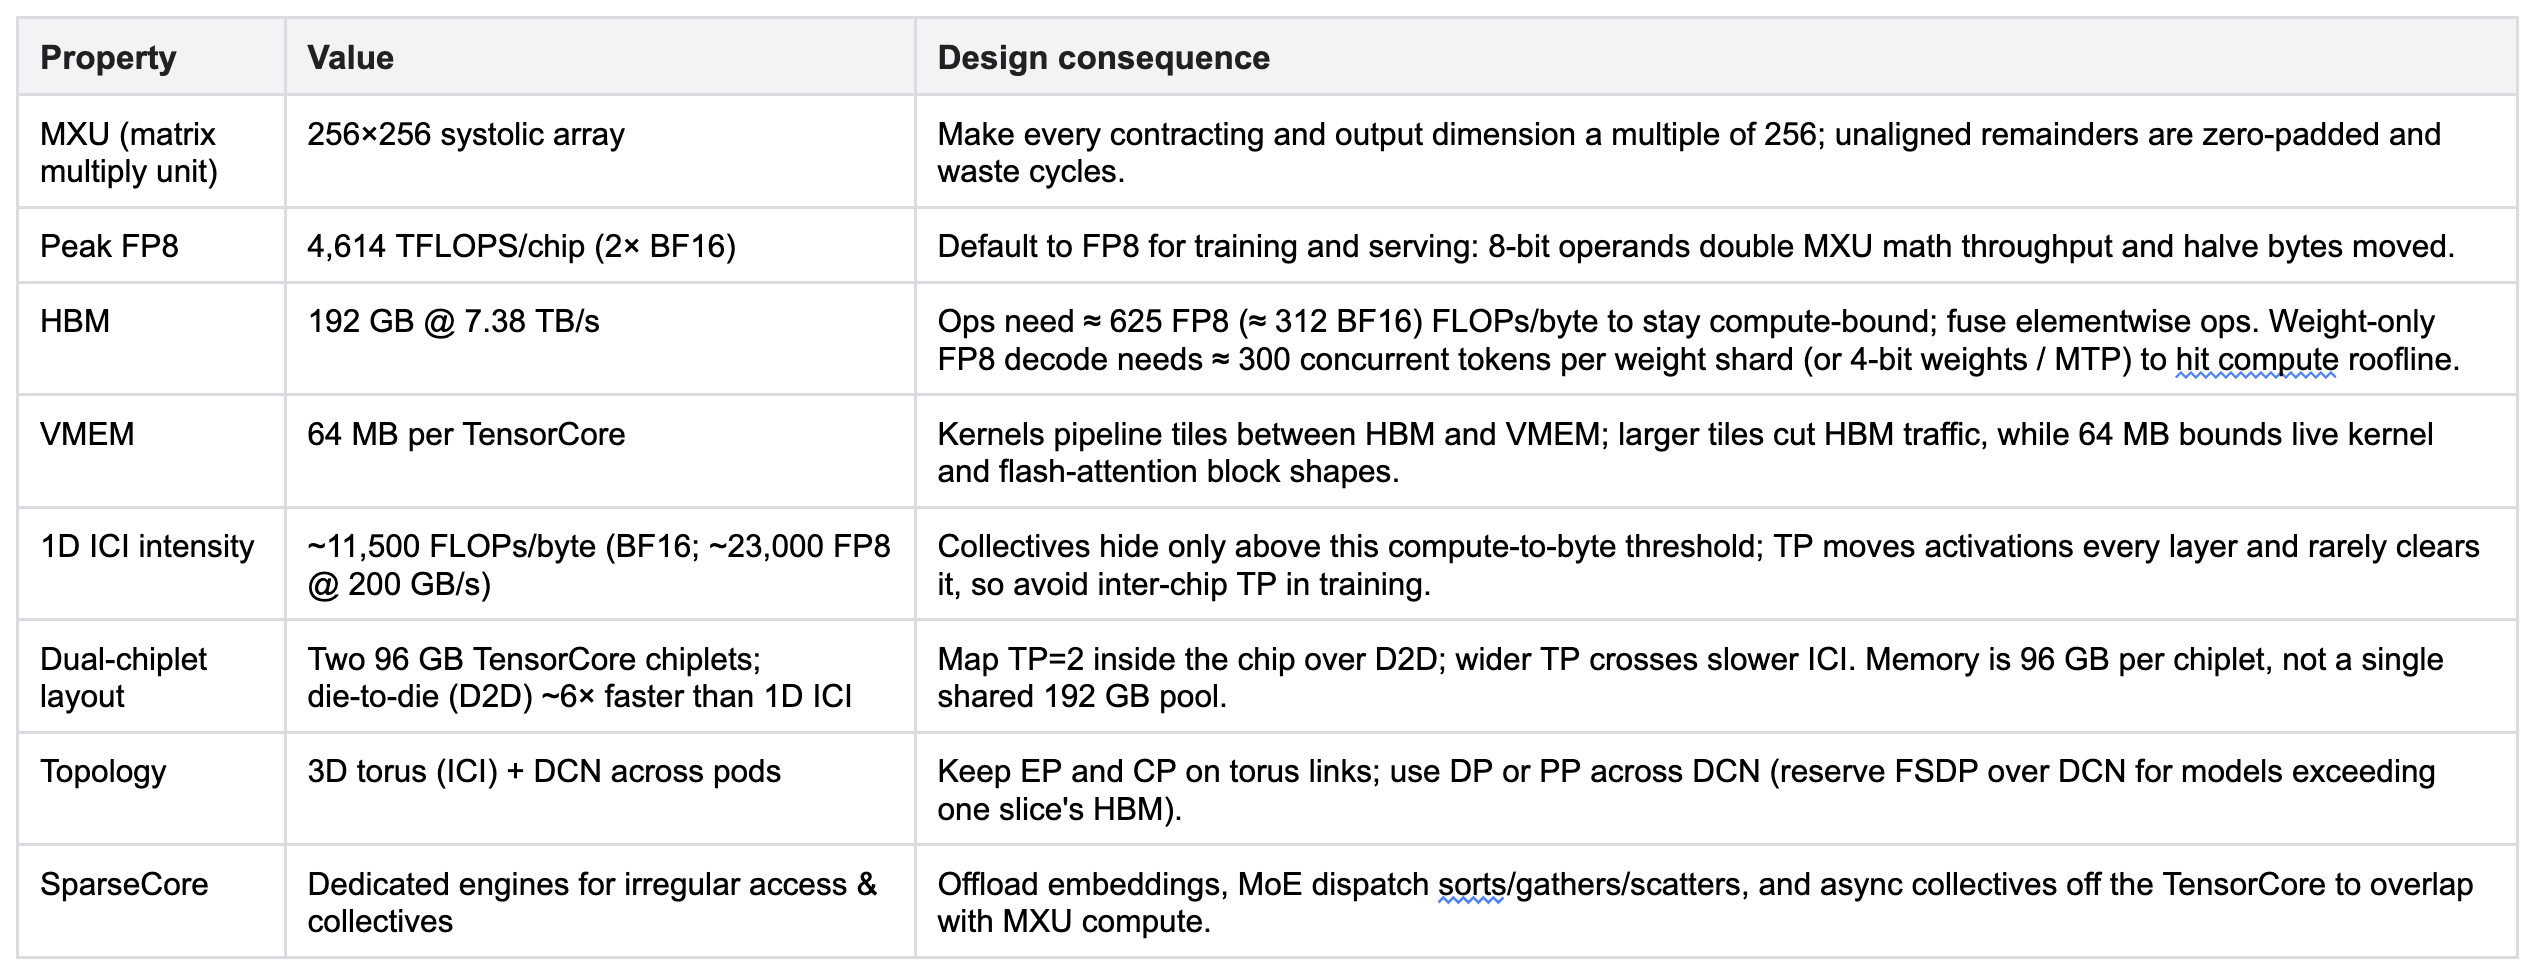
TPUs trocam o escalonamento genérico de uma GPU por um desenho bem mais rígido: arranjos sistólicos largos de 256×256 (a MXU), motores dedicados de SparseCore para operações esparsas e roteamento de MoE, e um tecido de interconexão (ICI) multidimensional fixo. Essa especialização é o motivo de a TPU entregar mais performance por custo total de propriedade (TCO), mas o preço é que ela pune qualquer desalinhamento de forma ou padrão de acesso que uma GPU simplesmente absorveria.
O guia organiza as recomendações em três blocos, por ordem de risco:
- Regras de forma (princípios 1-2): alinhamento de dimensões e shapes estáticos, risco de qualidade praticamente nulo, adotar sempre;
- Escolhas de arquitetura (princípios 3-7): mudanças estruturais que em geral trazem trade-off de qualidade e pedem ablação antes de ir para produção;
- Expressão de paralelismo (princípio 8): tuning de compilador e kernel que não exige tocar no checkpoint.
Se o time está desenhando um modelo novo, as regras de forma valem sempre. Se está adaptando um modelo já treinado, só a seção de paralelismo se aplica sem reabrir o checkpoint.
As regras de forma: alinhar a 256 sem custo de qualidade
A recomendação mais simples de aplicar, e a que o próprio guia chama de mais frequentemente ignorada, é fazer d_model, d_ff, larguras latentes e o vocabulário com padding serem múltiplos de 256, batendo com o tamanho da MXU sistólica. O erro mais comum é o head_dim: em 64 ou 128, os produtos QK da flash-attention deixam a MXU ociosa em 50% ou mais.
A correção reduz heads e aumenta head_dim, preservando o total de parâmetros e o tamanho do cache KV:
# antes: 32 heads x 128 de head_dim
num_heads, head_dim = 32, 128

# depois: 16 heads x 256, mesmos parâmetros e FLOPs totais
num_heads, head_dim = 16, 256
No profiling interno do Google com um MoE de 30B derivado do Qwen3-30B, essa única mudança acelerou o treino de ponta a ponta, com ganho crescente em contextos mais longos. O mesmo padrão aparece em ablações de atenção não quadrática (Gated DeltaNet), reforçando que não é peculiaridade de uma arquitetura só.
A segunda regra trata shapes dinâmicos, comuns em MoE com roteamento dropless e em paged attention. Em vez de preencher buffers até o maior grupo ou a sequência mais longa, o guia recomenda manter shapes fixos e descrever a estrutura irregular com arrays pequenos de inteiros (tamanhos de grupo, offsets, tabela de páginas), copiados para a memória escalar do TensorCore via PrefetchScalarGridSpec do Pallas antes do grid rodar. O MaxText já expõe isso como packing=True: a dependência de dados vira endereço e contador de loop, não mudança de shape, e o programa compilado roda igual para qualquer composição de lote.
LatentMoE: comprimir o tráfego de tokens roteados
O terceiro princípio é o mais estrutural do guia. Em MoE padrão, cada token roteado trafega na largura total de d_model entre dispatch e combine, o que, segundo o Google, torna a combinação de expert parallelism (EP) com FSDP mais lenta que FSDP puro nos benchmarks em Ironwood. A solução proposta, chamada LatentMoE (desenho já usado por Nemotron 3, MAI-Base-1 e Kimi K3), projeta o token para uma largura latente ℓ de 2 a 4 vezes menor antes do dispatch, roda os experts nesse espaço comprimido e só expande de volta depois do combine.
A regra de ouro para não perder qualidade na troca é manter K_new × ℓ ≤ K_old × d_model, reinvestindo a banda economizada em mais experts ativos por token. No profiling do Google sobre o MoE de 30B / 128 experts, um ℓ = 768 (compressão de 2,67×) cortou o tempo de permutação on-device em 2,8× e elevou o throughput de treino em 14% (de 270 para 322 TFLOP/s por chip), além de liberar cerca de 25 GB de HBM por dispositivo quando os checkpoints de recompute foram ancorados no espaço latente.
Vale o trade-off quando o lote por dispositivo é pequeno demais para esconder os all-gathers de peso do FSDP — é exatamente o cenário em que EP com LatentMoE e dispatch em FP8 se torna competitivo. O quarto princípio complementa essa ideia: entre dois layouts de MoE com qualidade equivalente, prefira o que concentra mais trabalho em GEMMs densos e sem comunicação (um shared expert mais largo) em vez de multiplicar experts pequenos.
Num MoE de 63B com ℓ = 768 e proporção K/N = 1/32, reduzir de (512, 16) para (256, 8) experts ativos, dobrando d_ff e o shared expert, elevou o throughput em 57% mantendo loss menor ao longo de 120,8 bilhões de tokens.
O muro de banda do decode
Servir um modelo grande em baixa concorrência significa ler o peso inteiro do modelo a cada token gerado. O guia estima que, em FP8 denso, é preciso algo como 300 tokens concorrentes por fragmento de peso para atingir o teto de compute. Três alavancas atacam isso: topologias de baixo diâmetro, decodificação especulativa por multi-token prediction (MTP) e dimensionamento explícito de concorrência.
Na prática, isso significa calcular o piso de latência pela razão entre bytes de peso por chip e banda de HBM (o exemplo citado é o Qwen3.5-397B em FP8 streamando ~100 GB por chip em 4 chips, um piso de ~13,5 ms antes mesmo de tocar no cache KV), e dimensionar o lote máximo pela HBM restante dividida pelo custo de KV por sequência. Para MoE, o tráfego de peso escala com a união de experts tocados no lote — se a concorrência real será baixa, a recomendação do Google é desenhar menos parâmetros ativos, não torcer para um lote que não vai existir.
VPU, precisão e onde FP8 não compensa
O sexto princípio ataca um gargalo menos óbvio: normas, ativações, máscaras e escalas de quantização rodam na VPU (Vector Processing Unit), cerca de duas ordens de magnitude mais lenta que a MXU, e executam em série com os matmuls a menos que o XLA consiga fundir esse trabalho num GEMM vizinho. A recomendação é padronizar em RMSNorm e SwiGLU fusionáveis e descarregar o sort/gather/scatter de MoE para o SparseCore.
O guia detalha a matemática do FP8 com escala em bloco: com blocos de tamanho B, o rescale da VPU só fica "escondido" dentro da janela da MXU quando B ≥ 1,5 × r_mxu/r_vpu. No TPU v7x essa razão fica perto de 240, o que empurra o limiar prático para blocos de cerca de 340 elementos — block 512 roda no tempo do tensor inteiro, enquanto block 128 fica 2,4× mais lento por ficar preso à VPU.
O sétimo princípio trata do caso oposto: para matmuls sensíveis a precisão, como atenção quadrática em contexto longo, BF16 multi-passo só compensa quando o ganho de throughput do formato de menor precisão supera o número de passes — no Ironwood, a razão FP8/BF16 é exatamente 2:1, então nenhum esquema multi-passo bate o BF16 nativo.
Mapear paralelismo para os links físicos
O oitavo princípio é o único que não exige reabrir o checkpoint: mapear eixos de paralelismo pesados em comunicação para os links físicos mais rápidos disponíveis. A regra prática para treino é TP = 2 no máximo (mapeado para os chiplets duplos), reservando TP maior só para decode, que é limitado por leitura de peso, não por compute. FSDP continua como padrão, com EP restrito a um eixo curto do torus 3D e DP/PP preferencialmente jogados para fora do pod, sobre a rede DCN.
A ativação do offload assíncrono de coletivos no SparseCore, segundo os benchmarks do tpu-recipes, corta de 15% a 22% do tempo de passo sem nenhuma mudança de modelo — vale medir antes de descartar.
O que muda na prática para quem treina fora do time do Google
A tabela abaixo resume onde cada geração de TPU citada no guia muda o cálculo:
| Geração | Diferencial |
|---|---|
| TPU v7x (Ironwood) | baseline do guia: MXU 256×256, 4 SparseCores, torus ICI 3D |
| TPU 8t | FP4 nativo, VPU mais balanceada para treino |
| TPU 8i | FP4 nativo, topologia Boardfly, Collectives Acceleration Engine, 3x mais SRAM |
| TPU 8i Max | dobra compute, SRAM e banda de HBM por pacote |
| TPU 8tx | adota a mesma topologia Boardfly |
Vale o alerta que o próprio Google faz: os números "Measured" vêm do programa interno de profiling da empresa, com MoEs abertos de 20-30B (uma variante LatentMoE derivada do Qwen3-30B e o GPT-OSS-20B) rodando em BF16 contra baselines já tunados — ou seja, são tendências transferíveis, não percentuais que qualquer time vai reproduzir igual.
Para quem trabalha com JAX e o stack MaxText no Google Cloud↳Google Cloud13 conteúdosPrograma da Google Cloud no Brasil projeta formar de forma gratuita 30 mil universitáriosDev (Back & Front) · mar 2026Google Cloud OnBoard capacita estudantes e desenvolvedores de TIGestão Dev & TI · mai 2019Desenvolvedores poderão participar de treinamento gratuito do Google CloudGestão Dev & TI · mai 2019Ver tudo em DevSecOps →, a régua prática é clara: comece pelas regras de forma (risco zero), rode a ablação de LatentMoE se o modelo for MoE com mais de 100 experts, e só depois mexa em paralelismo. Para quem está em GPU, os princípios de alinhamento de forma e LatentMoE ainda valem como leitura de arquitetura, mas a parte de topologia física (torus, Boardfly, SparseCore) é especificidade de TPU e não se transporta sem adaptação.
Fonte: Google Developers Blog
Highlights
- Google publica guia tpu-codesign com 8 princípios para alinhar LLMs e MoE ao hardware das TPUs Ironwood
- Regra crítica: alinhar head_dim a 256 em atenção (antes: 32 heads x 128; depois: 16 heads x 256) sem perda de qualidade
- LatentMoE reduz tráfego de tokens roteados em 2,8x e eleva throughput de treino em 14% (270 para 322 TFLOP/s)
- Layout MoE otimizado: reduzir de 512 para 256 experts ativos, dobrando shared expert, ganhou 57% em throughput em 63B
- Princípios valem para TPU v7x (Ironwood) e gerações futuras (TPU 8t, 8i, 8tx, 8i Max) com ajustes de threshold
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Cimed e Enter: quando o rosto do founder vira o canal de confiança da marca
No BRASA Summit Europa, Brunno Matias ouviu como Cimed e Enter usam a voz de quem faz o trabalho para construir confiança.