- Leitura
- 7 min
- Tabelas
- 2
- Código
- 1
- Fontes
- 1
O Google publicou em 19 de novembro os detalhes do Streaming DiLoCo no MaxText, técnica que permite treinar LLMs em TPUs espalhadas por datacenters diferentes sem que a rede vire o gargalo do treinamento.
O problema: um datacenter só não basta mais
Treinar um LLM↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI → de ponta tradicionalmente exige um cluster monolítico: todos os aceleradores no mesmo lugar, conectados por interconexões de altíssima banda, sincronizando gradientes a cada passo. O problema é que escalar um único cluster assim esbarra em limite físico e em custo. A saída óbvia, conectar várias fatias de computação (slices) espalhadas em datacenters diferentes, esbarra em outro limite: a rede de longa distância (WAN) entre esses datacenters é lenta e tem latência alta demais para o treinamento paralelo de dados (data parallelism) padrão, que depende de sincronizar gradientes globalmente a cada passo.
Num post publicado em 19 de novembro no Google Developers Blog, times do Google DeepMind e do Google Research detalharam como o MaxText, framework open source↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) → de treinamento de LLMs em JAX mantido pelo Google, implementa o Streaming DiLoCo para resolver exatamente esse gargalo. A proposta: treinar em múltiplos metrôs (cidades, regiões, datacenters) sem que a rede vire o fator limitante.
Como o DiLoCo evita sincronizar a cada passo
O DiLoCo (Distributed Low-Communication), descrito originalmente num paper do Google DeepMind, parte de uma ideia simples: em vez de sincronizar todos os dispositivos a cada passo, divide o treinamento em M grupos independentes, chamados learners. Cada learner roda um otimizador local (normalmente AdamW) por H passos sem trocar nada com os outros grupos.
O algoritmo opera em duas camadas:
- Loop interno (local): cada learner treina sozinho por H passos (no experimento do Google, H variou entre 37 e 65), usando a interconexão rápida interna do próprio slice.
- Loop externo (global): a cada H passos, os learners calculam a diferença entre os pesos atuais e os pesos no início do intervalo, fazem um all-reduce dessas diferenças pela rede e aplicam um otimizador externo (SGD com momentum de Nesterov) para atualizar os pesos globais.
Comunicando ordens de grandeza menos vezes que o treinamento síncrono tradicional, o DiLoCo já havia demonstrado convergência comparável em trabalhos anteriores. Mas a versão "vanilla" tem um problema prático: a cada H passos, todos os learners precisam transferir o delta do modelo inteiro de uma vez só, o que cria um pico enorme de tráfego e trava o pipeline numa rede estreita.
A sacada do Streaming: fatiar o modelo, não o tempo
O Streaming DiLoCo resolve esse pico fragmentando os parâmetros do modelo em P pedaços disjuntos. Ao longo dos H passos, cada fragmento é sincronizado exatamente uma vez, mantendo o mesmo volume total de comunicação do DiLoCo comum, mas distribuído de forma praticamente uniforme ao longo do tempo em vez de concentrado num único instante.
No MaxText, essa fragmentação segue três decisões de engenharia:
- P = número de camadas + 1: um fragmento para tudo que não é camada (embeddings de token, layer norm final, cabeça de saída) e um fragmento por camada do Transformer.
- Streaming escalonado: em vez de pausar a cada H passos para trocar o modelo inteiro, o MaxText sincroniza um fragmento a cada
Δh = max(1, round(H/P))passos. Com H = P, isso vira um fragmento por passo. - Balanceamento de embeddings: como o fragmento das camadas não escaneadas carrega as matrizes de embedding (que podem ser enormes por causa do vocabulário), o MaxText distribui pedaços dessas matrizes grandes entre os outros fragmentos, para que nenhum fragmento vire um pico isolado de tráfego.
A ordem de sincronização também é intercalada pela profundidade da rede (fragmento 0, depois camada k, depois camada 2k, e assim por diante) em vez de sequencial, o que evita deixar uma seção inteira do modelo desatualizada enquanto outra já foi sincronizada.
Os números: quanto isso economiza de rede de verdade
O Google ilustra o ganho com um exemplo de dimensionamento: treinar o Qwen3-32B em bfloat16, com tempo de passo de cerca de 6,2 segundos e P = H = 65.
| Regime de rede | Tráfego por passo | Banda mínima necessária |
|---|---|---|
| Data Parallel | ~65,5 GB | ~85 Gbps |
| DiLoCo vanilla (pico a cada 65 passos) | ~65,5 GB (todo de uma vez) | trava em links de 10 Gbps |
| Streaming DiLoCo | ~1,0 GB | ~1,3 Gbps |
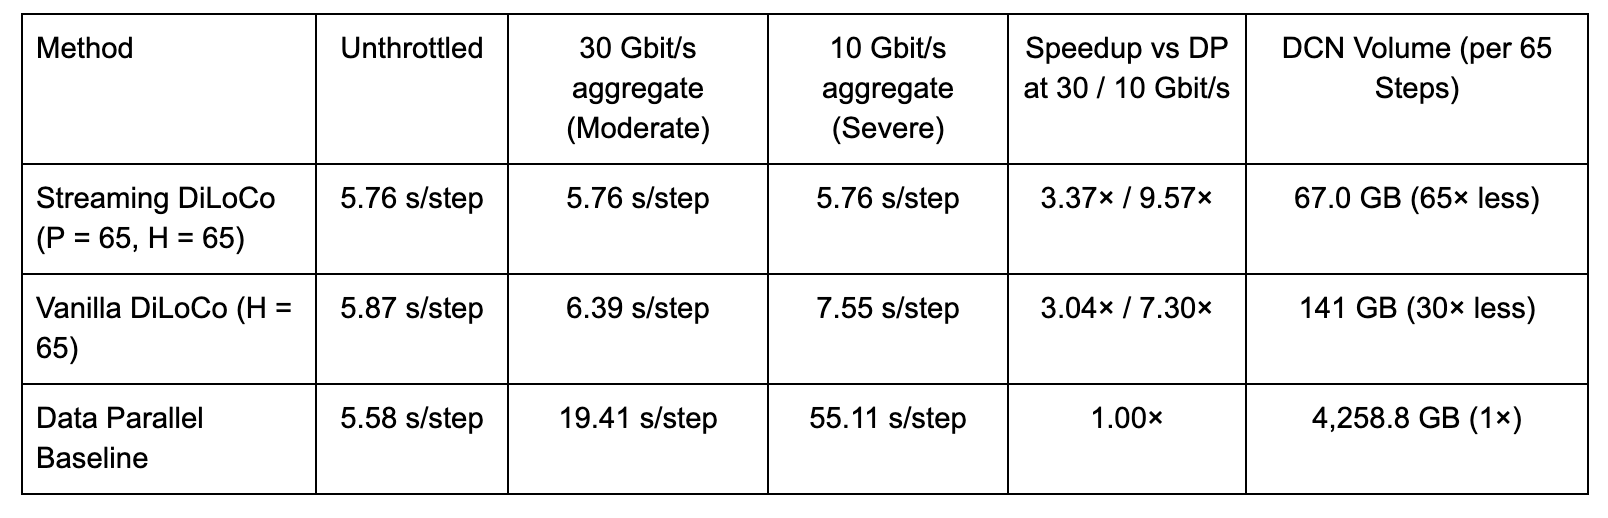
O benchmark real usou duas fatias de TPU v5p-32 e limitou a banda entre elas com o tc do Linux↳Linux34 conteúdosKali Linux em um Servidor VPS: como, quando e por que usar?DevSecOps · dez 2024Construindo um Windows Service ou Linux Daemon com Worker Service & .NET Core – Parte 2Dev (Back & Front) · jul 2020Criando uma WebApi utilizando .NET, Linux e VSCodeDev (Back & Front) · ago 2019Ver tudo em DevSecOps →, simulando três regimes de congestionamento. Os resultados batem com a conta teórica:
| Regime | Data Parallel | DiLoCo vanilla | Streaming DiLoCo |
|---|---|---|---|
| Sem limite de banda | ~5,6-5,9 s/passo | ~5,6-5,9 s/passo | ~5,6-5,9 s/passo |
| 30 Gbit/s agregados | 19,41 s/passo | 6,39 s/passo | 5,76 s/passo |
| 10 Gbit/s agregados | 55,11 s/passo | 7,55 s/passo | 5,76 s/passo |
No regime mais congestionado, o Streaming DiLoCo entrega um speedup de 9,57 vezes sobre o Data Parallel tradicional e ainda supera o DiLoCo vanilla, que continua sofrendo com a parada periódica de sincronização completa a cada H passos. O tráfego total medido na DCN caiu de 4.258,8 GB para 67,0 GB ao longo de 65 passos, uma redução de 64 a 65 vezes.
A pergunta óbvia: isso piora o modelo?
Deixar learners treinarem de forma independente por dezenas de passos antes de sincronizar levanta uma dúvida legítima, sobretudo em arquiteturas Mixture-of-Experts, onde os roteadores de especialistas poderiam divergir entre si. O Google testou o Streaming DiLoCo contra o Data Parallel síncrono em duas arquiteturas MoE, Qwen3-30B-A3B e Gemma4-26B-A4B, ao longo de 4.000 passos de treinamento.
O resultado: depois de um ajuste inicial nos primeiros ~800 passos, a curva de perda do Streaming DiLoCo acompanha e, segundo o post, chega a superar levemente a do Data Parallel. Dois detalhes de implementação explicam a estabilidade: o otimizador externo usa momentum de Nesterov (β = 0,9) em vez de simplesmente promediar os pesos, e a sincronização atualiza só os parâmetros do modelo, preservando os buffers de primeiro e segundo momento do AdamW local de cada learner, que nunca perde o próprio histórico de otimização.
Como ativar no MaxText
A configuração é feita via YAML ou flags de linha de comando:
# Habilita DiLoCo e Streaming DiLoCo
enable_diloco: true
enable_streaming_diloco: true

# Particiona em N_layers + 1 fragmentos (ex.: 64 + 1 = 65 para Qwen3-32B)
num_diloco_fragments: 65
diloco_sync_period: 65
use_sequential_layers: false # false = camadas intercaladas entre fragmentos

# Hiperparâmetros do otimizador externo (SGD com Nesterov)
diloco_outer_lr: 0.7
diloco_outer_momentum: 0.9

# Topologia: número de learners (slices) espalhados pela DCN/WAN
dcn_diloco_parallelism: 2
Por baixo do capô, o módulo diloco.py divide o batch global entre os M learners, cada um processando GBS / M tokens por passo. Para sobrepor comunicação e computação, os deltas do fragmento agendado são descarregados para workers de sincronização que rodam nas CPUs dos próprios hosts das TPUs, em arranjo sharded entre M partes. Esses workers fazem o all-reduce do fragmento em segundo plano enquanto as TPUs seguem rodando os passos do loop interno, sem depender de um coordenador central.
Para quem isso importa, e para quem não
Ninguém vai rodar isso num notebook pessoal: a técnica pressupõe que a equipe já tem múltiplas fatias de TPU (ou, em tese, GPU) em datacenters ou regiões diferentes e está disposta a lidar com a complexidade de orquestrar treinamento distribuído geograficamente. Para quem já enfrenta esse cenário, hoje forçado a concentrar tudo num único datacenter caro e escasso, o Streaming DiLoCo muda a equação: em vez de precisar de ~85 Gbps dedicados entre sites para treinar um modelo do porte do Qwen3-32B, bastam ~1,3 Gbps, ordem de grandeza compatível com links WAN comuns entre regiões de nuvem.
O valor prático para quem não treina modelos de dezenas de bilhões de parâmetros é mais conceitual: o roofline model usado no post (banda necessária ≈ volume de dados dividido pelo tempo de computação a sobrepor) e a lógica de fragmentar o que precisa sincronizar em vez de sincronizar tudo de uma vez são padrões que aparecem em qualquer sistema distribuído com gargalo de rede, não só em treino de IA. Vale estudar o código mesmo sem pretensão de rodar um cluster de TPUs.
O Google diz que o Streaming DiLoCo está disponível no MaxText a partir da versão 0.2.5, publicada no PyPI, com imagens Docker correspondentes e código na branch principal do GitHub do projeto. O post também referencia um guia teórico de dimensionamento de link, um tutorial passo a passo com receitas para Qwen3 8B e 30B, e scripts de lançamento prontos para os cenários denso e MoE.
Fonte: Google Developers Blog
Highlights
- MaxText reduz tráfego de rede em até 65 vezes ao treinar LLMs em datacenters espalhados
- Banda necessária cai de 85 Gbps (data parallel) para 1,3 Gbps (Streaming DiLoCo) no Qwen3-32B
- Teste em redes congestionadas: Streaming DiLoCo alcança 9,57x speedup sobre data parallel tradicional
- Google ativa recurso na versão 0.2.5 do MaxText com configuração YAML e suporte a MoE
- Padrão de fragmentação importa para qualquer sistema distribuído com gargalo de rede, não só IA
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Como o Codex da OpenAI isola comandos de IA sem recorrer a containers
A OpenAI detalhou como o agente de código Codex restringe arquivos e rede usando os mecanismos nativos de sandbox de macOS, Linux e Windows, em vez de rodar tudo dentro de um container Docker.