- Leitura
- 7 min
- Tabelas
- 1
- Código
- 3
- Fontes
- 1
Um tutorial do Google Developers Blog publicado em 19 de novembro usa o jogo Plane Strike para ensinar, passo a passo, como treinar um agente que chama ferramentas e corrige o próprio plano ao longo de vários turnos.
O problema: agentes reais não terminam o trabalho numa única resposta
Em dois posts anteriores, o Google Developers Blog mostrou como o Tunix, a biblioteca JAX de pós-treinamento de LLMs↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI → do Google, simplifica supervised fine-tuning (SFT) e GRPO (Group Relative Policy Optimization) de turno único em Cloud TPUs. Mas um agente de verdade raramente resolve um problema numa tacada só: ele precisa observar um resultado parcial, chamar uma ferramenta, ler a resposta dela e ajustar a estratégia ao longo de vários turnos antes de terminar a tarefa.
Em 19 de novembro de 2026, Wei Wei, developer advocate do Google, publicou um tutorial completo mostrando como treinar um agente multi-turno que usa ferramentas com o pipeline de reinforcement learning agentic do Tunix, rodando numa única TPU v6e-8. O código inteiro está no repositório planestrike-gemma4-rl, no GitHub.
Batalha naval como banco de testes
Para isolar o problema de raciocínio em múltiplos turnos sem a complexidade de um ambiente real, a equipe reaproveitou o jogo Plane Strike de um post anterior sobre RL em TensorFlow/JAX, trocando a política MLP customizada pelo Gemma 4 E2B em modo thinking.
As regras: tabuleiro 6x6 (A1 a F6), um avião de 8 células escondido em uma de 4 orientações possíveis. A cada turno o agente vê o resultado da jogada anterior e o tabuleiro visível (. não tentado, X acerto, O erro), raciocina sobre onde atacar e chama a ferramenta strike(cell="..."). O jogo acaba quando as 8 células do avião são atingidas ou depois de 23 tentativas.
Sem treino, o google/gemma-4-E2B-it já tem alguma noção espacial e sabe chamar ferramentas, mas vence só 9,4% dos jogos em tabuleiros de avaliação, gastando em média 22,44 tentativas. Depois de 100 passos de GRPO agentic com Tunix, a taxa de vitória sobe para 95% e o jogo médio cai para cerca de 16 tentativas.
| Métrica | Antes do treino | Depois de 100 passos |
|---|---|---|
| Taxa de vitória (avaliação) | 9,4% | ~95% |
| Tentativas médias por jogo | 22,44 | ~16 |
Quatro peças modulares formam o pipeline
O tutorial organiza o treinamento em quatro componentes, cada um num arquivo:
- Ambiente da tarefa:
PlaneStrikeEnv, subclasse deBaseTaskEnv, emenv.py - Ferramenta e parser do template de chat:
BaseTooleGemma4ChatTemplateParser, emstrike_tool.py - Agente de conversa:
ConversationAgentBase, emagent.py - Coleta de trajetórias e o learner GRPO:
TrajectoryCollectEngineeGRPOLearner, emtrajectory_utils.pyetrain_planestrike.py
Cada instância do ambiente recebe um dicionário com uma seed que fixa a posição do avião escondido, garantindo que os 8 rollouts de um mesmo grupo GRPO joguem exatamente o mesmo tabuleiro:
class PlaneStrikeEnv(BaseTaskEnv):
  """One Plane Strike game. `entry["seed"]` fixes the hidden plane position."""

  def __init__(
      self,
      entry: dict[str, Any],
      group_id: int | None = None,
      pair_index: int | None = None,
      max_steps: int = MAX_STEPS,
      **kwargs,
  ):
    entry = {k: _unwrap(v) for k, v in entry.items()}
    self.seed = int(entry.get("seed", 0))
    self.split = str(entry.get("split", "train"))
    super().__init__(task=dict(entry), max_steps=max_steps, **kwargs)
    self.extra_kwargs["group_id"] = group_id
    self.extra_kwargs["pair_index"] = pair_index
    self._reset_board()
A cada passo, _step_impl avalia a célula atacada contra o tabuleiro oculto, atualiza a grade visível, soma a recompensa do turno na recompensa da trajetória inteira e devolve um EnvStepResult(observation, reward, done, info). Para agentes com múltiplas ferramentas padrão, o módulo tunix.rl.agentic já traz ToolEnvironment, ToolAgent e ToolManager prontos: esse código sob medida só é necessário quando o controle de turno é especial.
Como o Gemma 4 chama ferramentas sem sair do próprio turno
O ponto mais específico do tutorial é o jeito como o Gemma 4 lida com chamadas de ferramenta nativamente, sem framework externo de function calling. O esquema da ferramenta é declarado no system prompt dentro de <|tool>declaration:...<tool|>, e um turno do modelo que chama uma ferramenta termina em <|channel>thought ... <tool_response|>. Esse é um dos tokens de parada nativos do Gemma 4: o modelo pausa, recebe a resposta como response:strike{value:"..."}<tool_response|> e continua gerando o próprio raciocínio e a próxima chamada dentro do mesmo turno de assistente.
Para isso funcionar, o post estende o parser padrão do Tunix:
class Gemma4ToolChatTemplateParser(parser_lib.Gemma4ChatTemplateParser):
  """Gemma4ChatTemplateParser plus native tool declarations and in-turn tool
  responses."""

  def __init__(self, tokenizer, tools, enable_thinking: bool = True):
    super().__init__(tokenizer, enable_thinking=enable_thinking)
    self.tool_declarations = render_tool_declarations(tokenizer, tools)
    self.tool_response_id = tokenizer.convert_tokens_to_ids(TOOL_RESPONSE_START)

  def _parse_tool(self, content: str) -> str:
    return f"response:{TOOL_NAME}{{value:{_STR}{content}{_STR}}}<tool_response|>"

  def parse(self, messages, add_generation_prompt=False, is_first_msg=False):
    if messages and messages[-1]["role"] == "tool":
      add_generation_prompt = False  # O modelo continua o próprio turno.
    return super().parse(messages, add_generation_prompt=add_generation_prompt,
                          is_first_msg=is_first_msg)
Isso importa porque evita retokenizar a conversa inteira a cada chamada de ferramenta, um dos jeitos mais comuns de introduzir ruído entre o que o modelo gerou e o que o treino enxerga como tokens.
O agente e o loop de GRPO assíncrono
Em agent.py, PlaneStrikeAgent faz a ponte entre observação do ambiente e mensagens do modelo. Ele ignora tudo dentro de <|channel>thought...<channel|> na hora de validar a jogada, e só conta como ação válida uma resposta final com exatamente uma chamada de strike bem formada; o resto vira INVALID_ACTION.
O treino roda com o motor assíncrono vllm-tpu do Tunix, numa TPU v6e-8 onde o modelo ator, o modelo de referência e os workers de rollout dividem os 8 chips. A configuração do GRPO usa loss_algo="gspo-token", advantage_estimator="rloo" e exact_token_continuity=True para preservar os IDs de token exatos entre os turnos, sem retokenização. O job de 100 passos sobe com:
python train_planestrike.py \
  --run_dir runs/grpo_6x6_tool_thinking_100 \
  --learning_rate 2e-6 \
  --lr_end 2e-7
O que os números mostram ao longo do treino
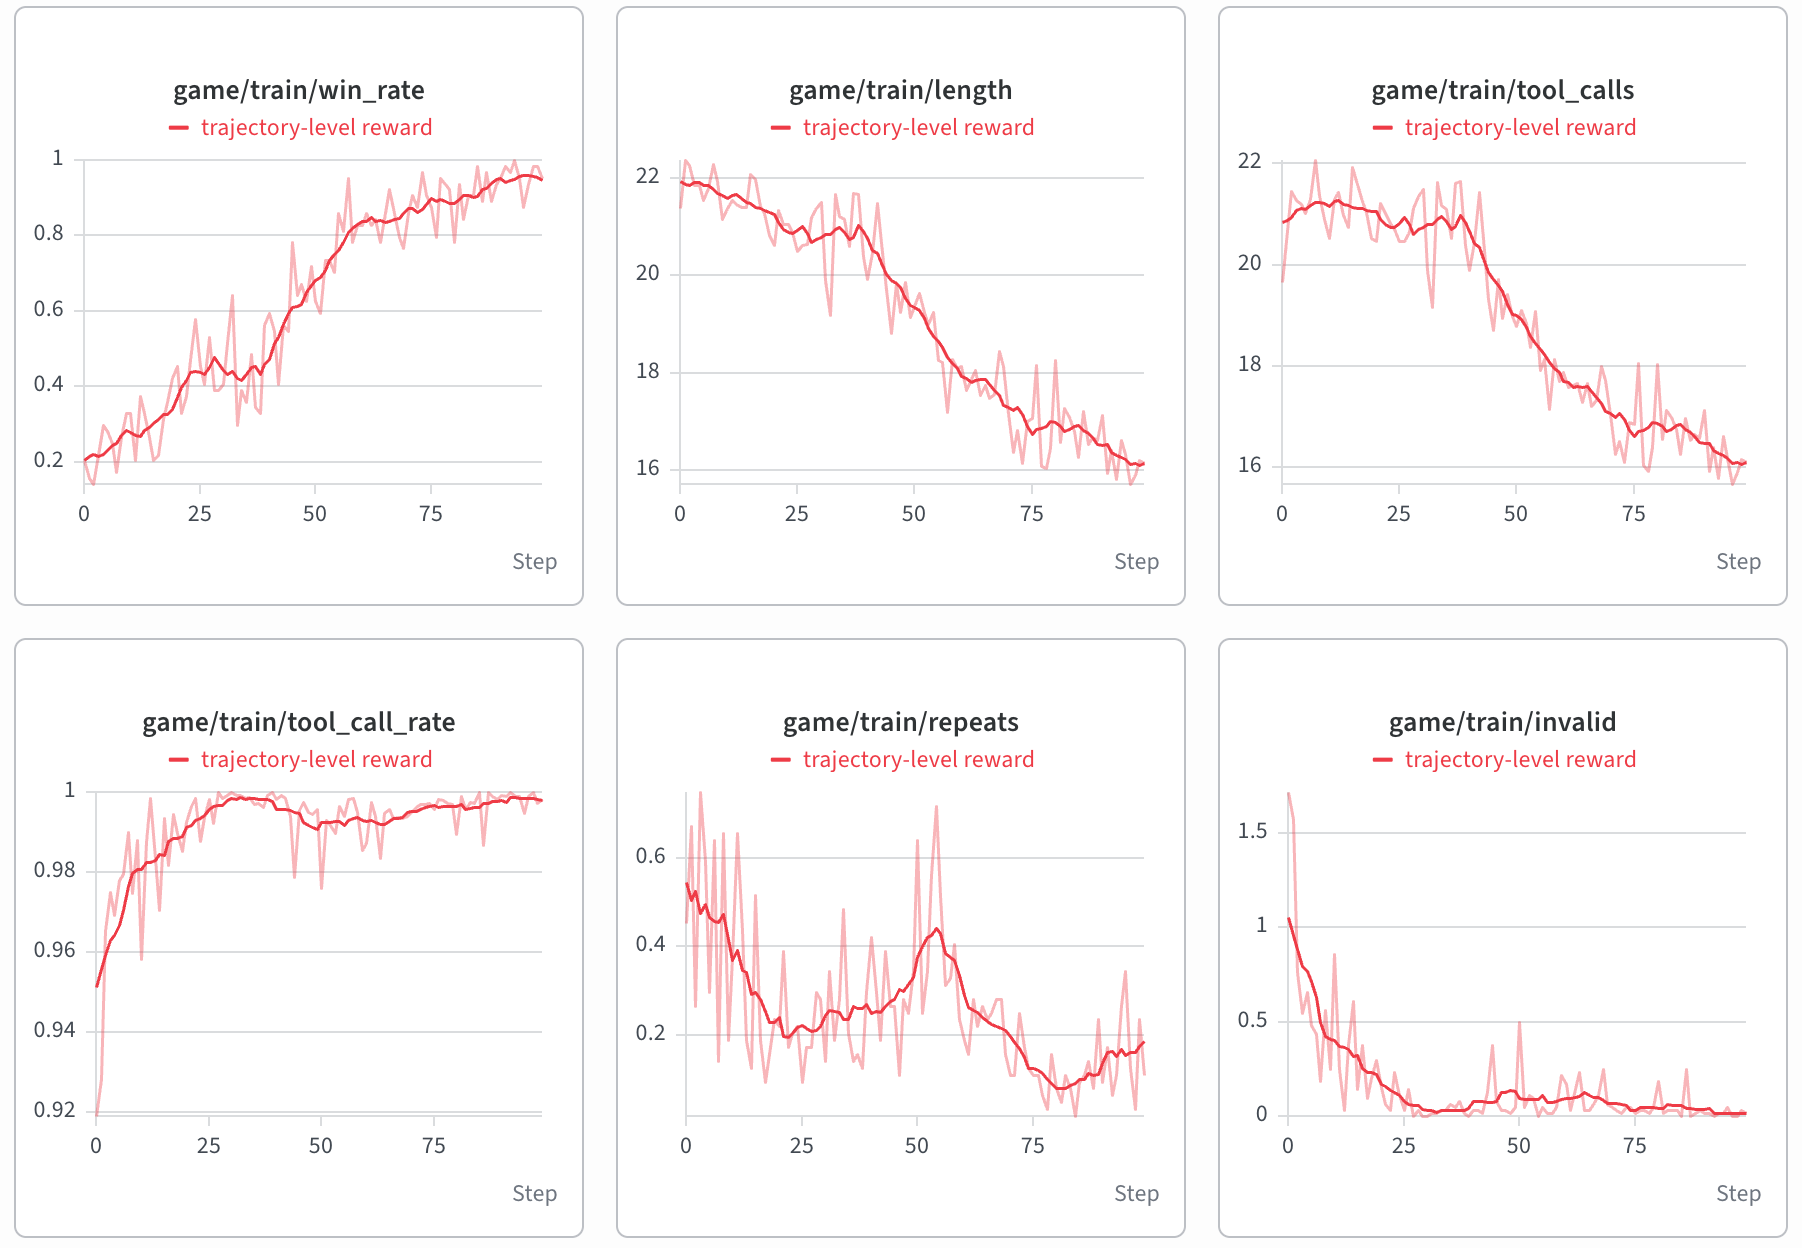
Três curvas contam a história do treinamento, segundo o post:
- A conformidade de chamada de ferramenta converge primeiro:
tool_call_ratechega perto de 100%,invalidcai perto de zero erepeats(ataques repetidos na mesma célula) cai de ~0,55 para ~0,15. - A taxa de vitória sobe de ~0,20 nos primeiros rollouts de treino (9,4% em avaliação held-out) para ~0,95.
- O comprimento médio do jogo cai de ~22 para ~16 tentativas.
O próprio post reconhece uma limitação: hoje todo o jogo usa uma única recompensa de trajetória, somada turno a turno. Ganhos adicionais, segundo os autores, dependem de uma atribuição de crédito mais fina por turno, ou seja, recompensar cada jogada individualmente em vez de só o resultado final.
O que muda pra quem constrói agente aqui
Em resumo: o tutorial não é sobre jogar Plane Strike, é uma receita reproduzível de RL multi-turno com ferramentas nativas, sem depender de orquestrador de function calling por fora do modelo. Isso interessa a quem está construindo agentes que precisam manter estado entre chamadas, como um assistente de suporte que consulta um sistema, ou um agente de dados que roda uma query, refina e roda de novo.
Vale notar as travas práticas antes de replicar isso num projeto no Brasil:
- O pipeline inteiro é pensado para Cloud TPU v6e-8; rodar em GPU exige adaptar o rollout vllm-tpu e a configuração de cluster do Tunix, o que não é trivial.
tunix.rl.agenticcomToolEnvironment,ToolAgenteToolManagercobre o caso comum de múltiplas ferramentas; só vale escrever ambiente e parser do zero, como neste tutorial, quando o controle de turno exige algo fora do padrão (aqui, o Gemma 4 continuando o próprio turno depois da resposta da ferramenta).- O salto de 9,4% para 95% de vitória veio de um jogo determinístico e barato de simular; a mesma curva de aprendizado não está garantida em tarefas onde o ambiente (uma API real, um banco de dados↳Banco de dados134 conteúdosSQL ou NoSQL: eis a questão!!Data · mar 2020Banco de dados: como organizar e dar segurança para milhões de dados de loteriasData · mai 20215 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data →) é mais caro ou mais lento de rodar em escala.
Tunix é open source↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) →, e o repositório planestrike-gemma4-rl traz o código completo, incluindo os arquivos env.py, strike_tool.py, agent.py e train_planestrike.py citados no post. Para quem já usa GRPO de turno único com Tunix, o salto para multi-turno aqui é mais sobre reaproveitar as abstrações agentic prontas da biblioteca do que reescrever o treino do zero.
Fonte: Google Developers Blog
Highlights
- Taxa de vitória do Gemma 4 no jogo Plane Strike sobe de 9,4% para 95% após 100 passos de GRPO agentic
- Tentativas médias por jogo caem de 22,44 para aproximadamente 16 com treinamento em Tunix
- Tutorial usa Gemma 4 E2B em thinking mode para raciocinar sobre múltiplos turnos e chamar ferramentas
- Pipeline de 4 componentes modulares roda em uma única TPU v6e-8 sem orquestrador externo
- Conformidade de chamada de ferramenta converge primeiro; ataques repetidos caem de 0,55 para 0,15
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Google AI Studio passa a gerar apps Android completos em Kotlin com Gemini 4 Hydrogen
Desde 17 de novembro de 2026, o Build agent do Google AI Studio provisiona Firestore, login com Google e chamadas seguras ao Gemini direto no Kotlin, e publica o app na Play Store sem keystore manual.