Serpro testa aprendizado federado para duas instituições treinarem a mesma IA sem juntar os dados
- Leitura
- 3 min
Na 2ª Semana de IA Serpro, experimento com split learning simulou banco e processadora treinando um detector de fraude, e o MGI apresentou ferramenta de autoavaliação de impacto ético em IA.
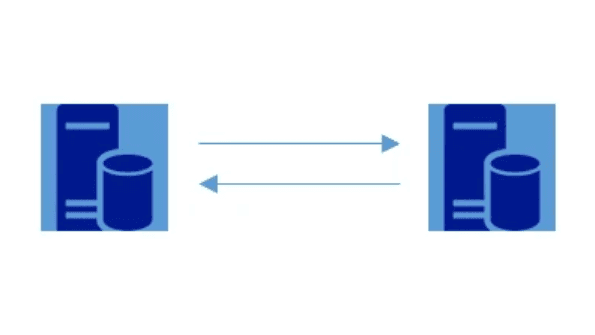
Duas instituições conseguem treinar o mesmo modelo de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → sem juntar os dados num só lugar? O Serpro testou na prática. A estatal dividiu uma base pública de transações com cartão para simular um banco e uma processadora de pagamentos. Só a processadora recebeu a informação de quais compras tinham sido classificadas como fraude. Mesmo assim, os dois participantes treinaram o mesmo modelo, cada um processando a sua parte dos dados no próprio ambiente.
O experimento foi apresentado na 2ª Semana de IA Serpro. A técnica, conhecida como aprendizado federado, pode ganhar um piloto com a Receita Federal.
Split learning: cada lado roda um pedaço da rede
Na simulação, cada participante executou uma parte da rede neural, numa configuração chamada split learning. “Os embeddings, representações intermediárias, e seus gradientes trafegam entre os participantes”, explicou Alexandre Henrique Soares, especialista do Serpro. Ou seja: o que circula entre as instituições são representações numéricas e os ajustes do treinamento, não os registros brutos. A cada rodada, esses cálculos refinam o modelo.
A avaliação exigiu um cuidado clássico em detecção de fraude: as fraudes eram uma parcela pequena das transações. “Em uma base assim, um modelo pode acertar a maioria das classificações e ainda deixar passar justamente as compras que deveria sinalizar”, alertou Soares. Em bases desbalanceadas, acurácia sozinha engana; métricas como precisão e recall da classe minoritária contam mais.
Quem fica nos 5% de erro?
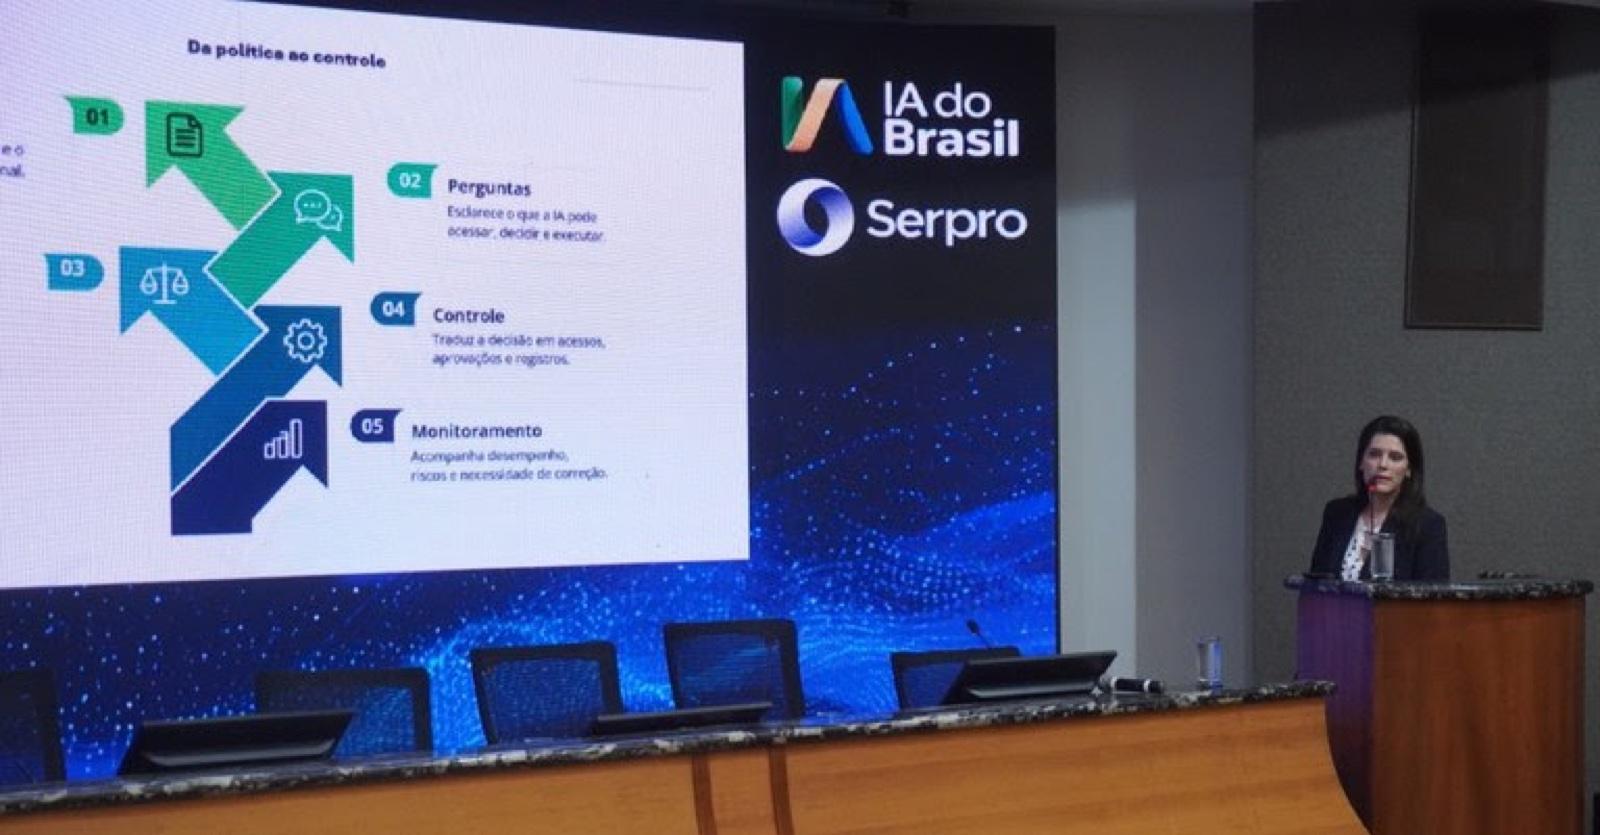
A taxa de acerto também esteve no centro da fala de Camila Falchetto Quadros, coordenadora-geral de Governança de Inteligência Artificial da Secretaria de Governo Digital do Ministério da Gestão e da Inovação (MGI). Ela usou o exemplo hipotético de um sistema de concessão de benefícios que acerta 95% das vezes. “Mas e esses outros 5% que ele erra? Será que é um grupo? Será que a gente pode estar discriminando pessoas? Que tipo de falsos positivos ou falsos negativos podem estar acontecendo nessa camada?”, questionou.
Para explicar ao cidadão por que um benefício foi negado, o órgão precisa reconstituir o caminho até a decisão. Camila defendeu que os servidores tenham condições de revisar o resultado, corrigir erros e interromper o sistema quando necessário.
Autoavaliação de impacto ético
Para apoiar os órgãos, a Secretaria de Governo Digital criou uma Autoavaliação de Impacto Ético em IA, disponível em plataforma do MGI. Um questionário inicial classifica o risco da solução e define as perguntas seguintes: 11 sobre práticas éticas para aplicações de baixo risco e 44 para as de alto risco. Ao final, a ferramenta gera um relatório com recomendações para corrigir as lacunas encontradas. O Serpro ajudou a testar a metodologia e a calibrar o peso das perguntas.
A urgência aparece nos números. No autodiagnóstico de 2025, 120 órgãos disseram já usar IA ou ter iniciado a adoção, mas só 15 faziam avaliação de risco. “A aplicação dessas medidas éticas é muito mais lenta do que a adoção da própria tecnologia”, avaliou Camila. A recomendação é repetir a autoavaliação a cada mudança de fase no ciclo de vida do sistema ou a cada mudança estrutural.