O Inkling 2 Mini, anunciado em 20 de novembro de 2026 pela Thinking Machines Lab via blog do Hugging Face, usa um truque de camadas repetidas para simular um modelo maior com peso de 3B parâmetros ativos por token.
- Leitura
- 7 min
- Código
- 3
- Fontes
- 1
O Inkling 2 Mini, anunciado em 20 de novembro de 2026 pela Thinking Machines Lab via blog do Hugging Face, usa um truque de camadas repetidas para simular um modelo maior com peso de 3B parâmetros ativos por token.
O Hugging Face publicou em 20 de novembro de 2026 o post de apresentação do Inkling 2 Mini, modelo multimodal da Thinking Machines Lab pensado para quem roda IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → fora de datacenter. A proposta central, descrita no texto assinado por merve, Pedro Cuenca, Aritra Roy Gosthipaty e Guarin Flück, é simular um modelo bem maior reaproveitando as mesmas camadas várias vezes durante a inferência, em vez de simplesmente empilhar mais parâmetros físicos.
Para quem testa agentes, pipelines de RAG ou só quer um copiloto de código rodando na própria máquina, o ponto prático é esse: o modelo tem 26 bilhões de parâmetros no total, mas ativa apenas cerca de 3 bilhões por token graças à arquitetura Mixture-of-Experts. Isso aproxima o custo computacional de inferência do de um modelo bem menor, mesmo entregando uma capacidade comparável a modelos maiores em vários benchmarks.
Como funciona o loop de camadas
O Inkling 2 Mini tem 24 camadas físicas de decoder, mas as 12 camadas do meio são executadas três vezes em loop. Na prática, o modelo se comporta como se tivesse 48 camadas lógicas (6 + 3×12 + 6), sem precisar armazenar pesos para todas elas.
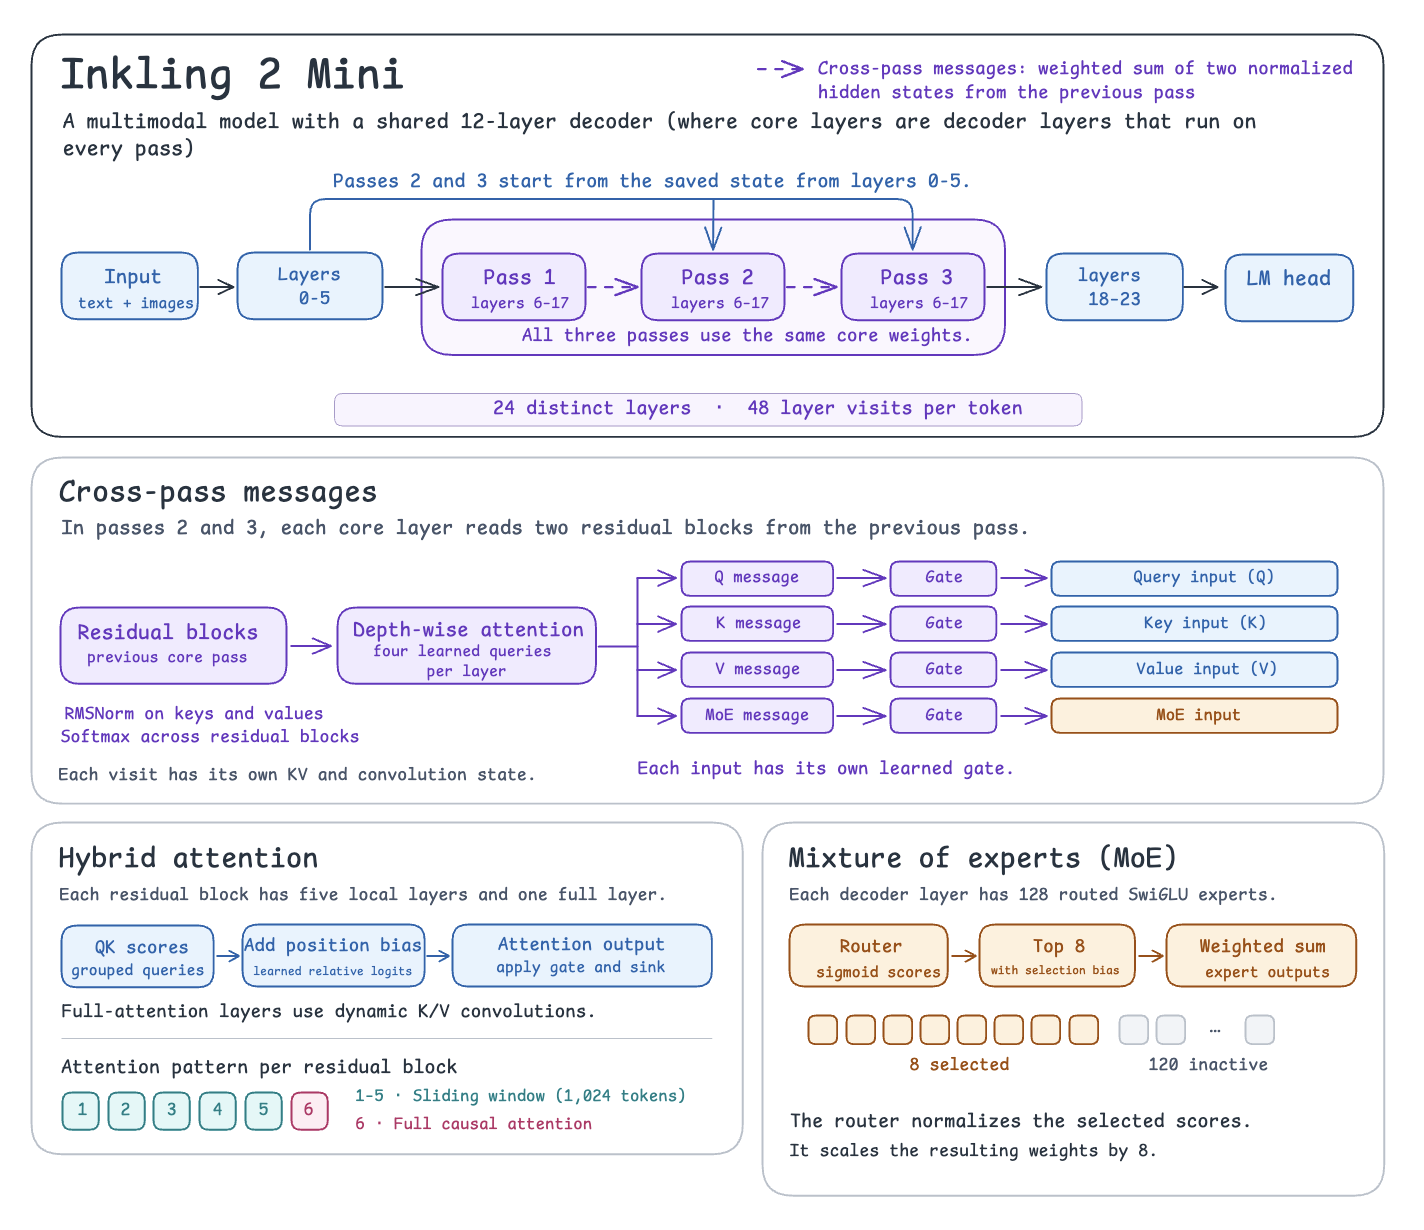
Cada passagem pelo núcleo em loop começa a partir da mesma entrada, que é a saída das seis primeiras camadas. A comunicação entre as passagens acontece por meio de "mensagens entre passagens": cada camada lê uma mensagem da saída da passagem anterior usando sua própria query aprendida, e um controlador de gating decide quanto do valor atual manter e quanto da mensagem incorporar. Esse mecanismo é o que permite que a terceira passagem refine o que a segunda computou, em vez de repetir o mesmo cálculo três vezes.
A ideia de repetir camadas (looping) não é nova, arquiteturas como a Nanbeige já exploraram variações do conceito. A diferença aqui é o jogo de mensagens e gates entre passagens, que dá ao modelo uma forma de acumular raciocínio sem crescer em disco. Cada visita de camada mantém seu próprio estado de KV-cache e de convolução curta, então o ganho de capacidade não é de graça em memória de contexto, mesmo reaproveitando os pesos.
O roteamento de experts segue o padrão MoE: para cada token, o modelo escolhe 8 de 128 experts SwiGLU por camada, normaliza os scores selecionados e escala os pesos por 8. O tamanho oculto do modelo é 2.304, bem menor que o do irmão maior, o Inkling 2 Small (4.608), o que também ajuda a reduzir a pegada de memória.
Onde ele fica no ranking de modelos locais
Segundo o post, o Inkling 2 Mini aparece no topo da categoria no Artificial Analysis Intelligence Index v5 (AAv5) e lidera 32 de 48 benchmarks comparados contra Gemma 4 31B, Muse Glimmer, Qwen3.8-27B e Nemotron 3.5 Super VL, cobrindo código, pesquisa automatizada, uso de ferramentas, visão e segurança.
Na frente mais relevante para quem programa, o modelo lidera o FrontierCode v2.0, empata com o Qwen3.8-27B no Terminal-Bench 4.0 e fica atrás dele no AutomationBench-AA v1.0.6. É um resultado misto, não uma vitória completa, e vale ler com reserva: a própria equipe do Hugging Face admite que os testes mais chamativos do post são impressões subjetivas, não avaliação formal.
Nos nossos testes de vibe, ele é ao menos comparável ao Qwen 3.8 27B. Mais validação é necessária, mas estamos muito empolgados com este lançamento.
Equipe do Hugging Face, autores do post oficial sobre o Inkling 2 MiniIn our vibe tests, it's at least comparable with Qwen 3.8 27B. More validation is needed, but we are super excited about this release!
Essa ressalva importa porque parte da demonstração do post (um flythrough 3D em WebGL, uma recriação animada de "A Noite Estrelada" e um app gerado a partir de um rascunho em papel) são exemplos escolhidos a dedo, não um benchmark reprodutível. Servem para mostrar capacidade de código multimodal, não para substituir uma avaliação própria antes de trocar de modelo em produção.
Rodando na prática: transformers, llama.cpp, MLX e SGLang
O suporte via transformers usa a classe AutoModelForMultimodalLM, tanto para o checkpoint fixo (thinkingmachines/Inkling-2-Mini) quanto para a variante de pesquisa com número de passes ajustável (thinkingmachines/TML-d24-varloop-research):
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "thinkingmachines/Inkling-2-Mini"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id)

messages = [{"role": "user", "content": [{"type": "text", "text": "Why is the sky blue?"}]}]
inputs = processor.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True,
    return_dict=True, return_tensors="pt",
).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=1024)
Na variante de pesquisa é possível reduzir o número de passagens pelo loop via loop_num_passes em text_config, o que acelera a inferência trocando qualidade por velocidade, algo que faz sentido testar em protótipo antes de fixar o número de passes em produção.
Para quem quer rodar fora de um cluster, o caminho mais direto é o Llama App (baseado em llama.cpp), com quants GGUF prontos em 4 bits (IQ4_NL) e 8 bits (Q8_0):
llama serve -hf ggml-org/Inkling-2-Mini-GGUF:IQ4_NLFazendo a conta simples de quantização, 26 bilhões de parâmetros em 4 bits ocupam algo em torno de 13 a 15 GB de memória, faixa que cabe em notebooks com 16 GB de RAM unificada ou GPUs de consumo com VRAM limitada, mesmo sem chegar perto do hardware de datacenter usado para treinar o modelo. É essa conta, não uma promessa da fonte, que sustenta o ângulo de "setup local sem GPU cara".
No MLX, o suporte foi incorporado ao projeto mlx-lm com quants compartilhados pela organização mlx-community, incluindo entrada multimodal:
mlx_lm generate --model thinkingmachines/Inkling-2-Mini --image image.jpg --prompt "Describe this image."Já para quem quer servir o modelo em produção, o SGLang oferece suporte desde o dia zero, com um pré-requisito importante: a precisão mista nativa, que usa NVFP4 e MXFP8 nos pesos dos experts, exige GPU com arquitetura SM103, ou seja, Blackwell de datacenter como a B300 citada no post. Em hardware de consumo, a via realista continua sendo GGUF via llama.cpp ou os quants MLX, não o formato de precisão mista original.
O que muda para quem constrói agentes e RAG
O contexto de 1 milhão de tokens e o suporte nativo a chamadas de ferramenta (tool_calls) tornam o Inkling 2 Mini candidato natural para RAG com janelas grandes e para agentes que precisam decidir quando invocar uma função externa, sem depender de um modelo hospedado. O post mostra um exemplo funcional de function calling em que o modelo pede uma chamada a get_current_temperature, recebe o resultado e o incorpora na resposta final.
Outro detalhe útil para quem ajusta custo versus qualidade em produção é o parâmetro reasoning_effort, com sete níveis (none, minimal, low, medium, high, xhigh, max, padrão high), além de aceitar valores numéricos arbitrários entre 0.0 e 0.99. Isso dá controle fino sobre quanto o modelo "pensa" antes de responder, algo que normalmente só se consegue com prompts manuais em outros modelos.
Para acelerar ainda mais a geração, o SGLang suporta decodificação especulativa com um drafter próprio chamado DSpark, que lê estados intermediários de três visitas do decoder (5, 23 e 41) mais o estado final normalizado para propor tokens que o modelo alvo verifica. O post cita benchmarks de velocidade com e sem esse drafter numa B300, mas sem publicar os números concretos no corpo do texto, só o roteiro do script usado para medir.
Onde a cautela se justifica
A variante de pesquisa com número de passes ajustável (TML-d24-varloop-research) é tentadora para quem quer economizar latência reduzindo o loop de três para uma ou duas passagens, mas a própria equipe do Hugging Face diz ter testado só superficialmente essa configuração, sem avaliação aprofundada. Antes de colocar essa variante numa pipeline real, vale rodar a própria bateria de testes, não confiar no "funciona" do post.
O mesmo vale para os números de benchmark do AAv5: eles comparam o Inkling 2 Mini contra um conjunto específico de concorrentes e descrevem vitória em 32 de 48 categorias, não domínio total. Para quem decide entre modelos locais hoje, isso significa testar nas tarefas específicas do seu projeto (código, RAG, agentes) antes de trocar de modelo em produção, porque a distância entre "líder em FrontierCode" e "melhor modelo para o seu caso de uso" pode ser grande.
Fonte: Hugging Face Blog
Highlights
- Inkling 2 Mini usa looping de camadas: 24 camadas físicas reaproveitadas 3 vezes parecem 48 lógicas
- Lidera 32 de 48 benchmarks contra Gemma, Qwen e Nemotron em código, visão e agentes
- Roda em 13-15 GB quantizado 4-bit: notebooks 16GB e GPUs consumo podem rodar local
- Suporte transformers, llama.cpp, MLX pronto; SGLang requer GPU Blackwell para precisão mista nativa
- Benchmarks do post incluem testes subjetivos não formais: valida em suas tarefas antes produção
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Tunix e Gemma 4 mostram como treinar agentes de IA multi-turno em TPUs
Um tutorial do Google Developers Blog publicado em 19 de novembro usa o jogo Plane Strike para ensinar, passo a passo, como treinar um agente que chama ferramentas e corrige o próprio plano ao longo de vários turnos.