A Liquid AI lançou um modelo de 24 bilhões de parâmetros que ativa só 2 bilhões por token, pensado para agentes que chamam ferramentas e rodam continuamente em hardware local.

A Liquid AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → publicou em 13 de outubro de 2026, no blog da Hugging Face, o LFM2.5-24B-A2B: um modelo de 24 bilhões de parâmetros que ativa apenas 2 bilhões por token, desenhado especificamente para agentes que raciocinam, chamam ferramentas e rodam continuamente em hardware local. A proposta central é simples de enunciar e difícil de entregar: dar ao desenvolvedor um modelo bom o suficiente para substituir chamadas de API por inferência on-device, sem abrir mão de qualidade em tarefas agênticas.
Isso importa porque agente que roda local resolve dois problemas de uma vez: custo de token que escala com uso e dependência de uma API externa que pode mudar preço, rate limit ou política de dados do dia para a noite. Para quem lida com dados sensíveis, sejam eles legais, médicos ou financeiros, rodar o modelo dentro da própria infraestrutura também simplifica a conversa sobre LGPD↳LGPD14 conteúdosComo utilizar a LGPD com o objetivo de conformidade e inovação?Gestão Dev & TI · out 2021LGPD coloca pressão inédita nos responsáveis pela tecnologia das empresasData · ago 2021Proteção de dados: LGPD é sancionada e começa a valerData · set 2020Ver tudo em Gestão Dev & TI →, já que o dado nunca sai da máquina.
Como o modelo é montado por baixo
O LFM2.5-24B-A2B herda a arquitetura do LFM2-24B-A2B: 40 camadas, blocos MoE (mixture-of-experts) com 64 especialistas e roteamento top-4, combinados com convoluções curtas com gate e atenção GQA (grouped-query attention). A diferença de MoE para um modelo denso equivalente é que só uma fração dos parâmetros participa de cada token processado, o que derruba o custo computacional por inferência sem jogar fora capacidade total do modelo.
Em relação ao antecessor, três mudanças concretas aparecem na versão 2.5:
- A janela de contexto salta de 32 mil para 131 mil tokens.
- O vocabulário do tokenizador dobra de 65 mil para 128 mil tokens, via expansão in-place, melhorando a tokenização de idiomas não latinos.
- O modelo deixa de ter modo de resposta direta: agora ele é reasoning-only, ou seja, sempre produz uma cadeia de pensamento explícita antes da resposta final.
A Liquid AI também escalou o pré-treinamento de cerca de 17 trilhões para 33 trilhões de tokens, e acrescentou duas fases de mid-training: 2 trilhões de tokens em contexto de 32K (com peso em raciocínio, matemática, código, instruction following e multilinguismo) e 300 bilhões de tokens em contexto de 131K, voltados a dados de longo contexto. Chamadas de ferramenta e trajetórias multi-turno aparecem desde essa fase, não só no ajuste final.
Cinco estágios para virar agente
O pós-treinamento que transforma o modelo base num agente segue cinco etapas descritas pela equipe: fine-tuning supervisionado (SFT), especialização de professores (teacher specialization), duas rodadas de destilação multi-domínio on-policy (MOPD) — uma em tarefas não agênticas e outra focada em tarefas agênticas — e, por fim, aprendizado por reforço agêntico (Agentic RL), treinado dentro de harnesses de agente reais como OpenClaw, Hermes Agent, Pi e OpenCode.
Esse último detalhe é o que diferencia o LFM2.5-24B-A2B de um modelo generalista com tool calling genérico: ele foi exposto, durante o próprio treinamento de RL, aos mesmos frameworks de agente que o desenvolvedor vai usar em produção. Isso tende a reduzir a distância entre o benchmark e o comportamento real do agente rodando com ferramentas de verdade.
O que os benchmarks mostram (e o que não mostram)
A Liquid AI comparou o modelo com Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it e Nemotron-3.5-Lightning (30B-A3B) em 16 benchmarks, usando vLLM e os parâmetros de geração recomendados por cada teste. O LFM2.5-24B-A2B é o menor modelo do grupo, mas lidera ou empata em cinco dos oito benchmarks de tool use e tarefas agênticas:
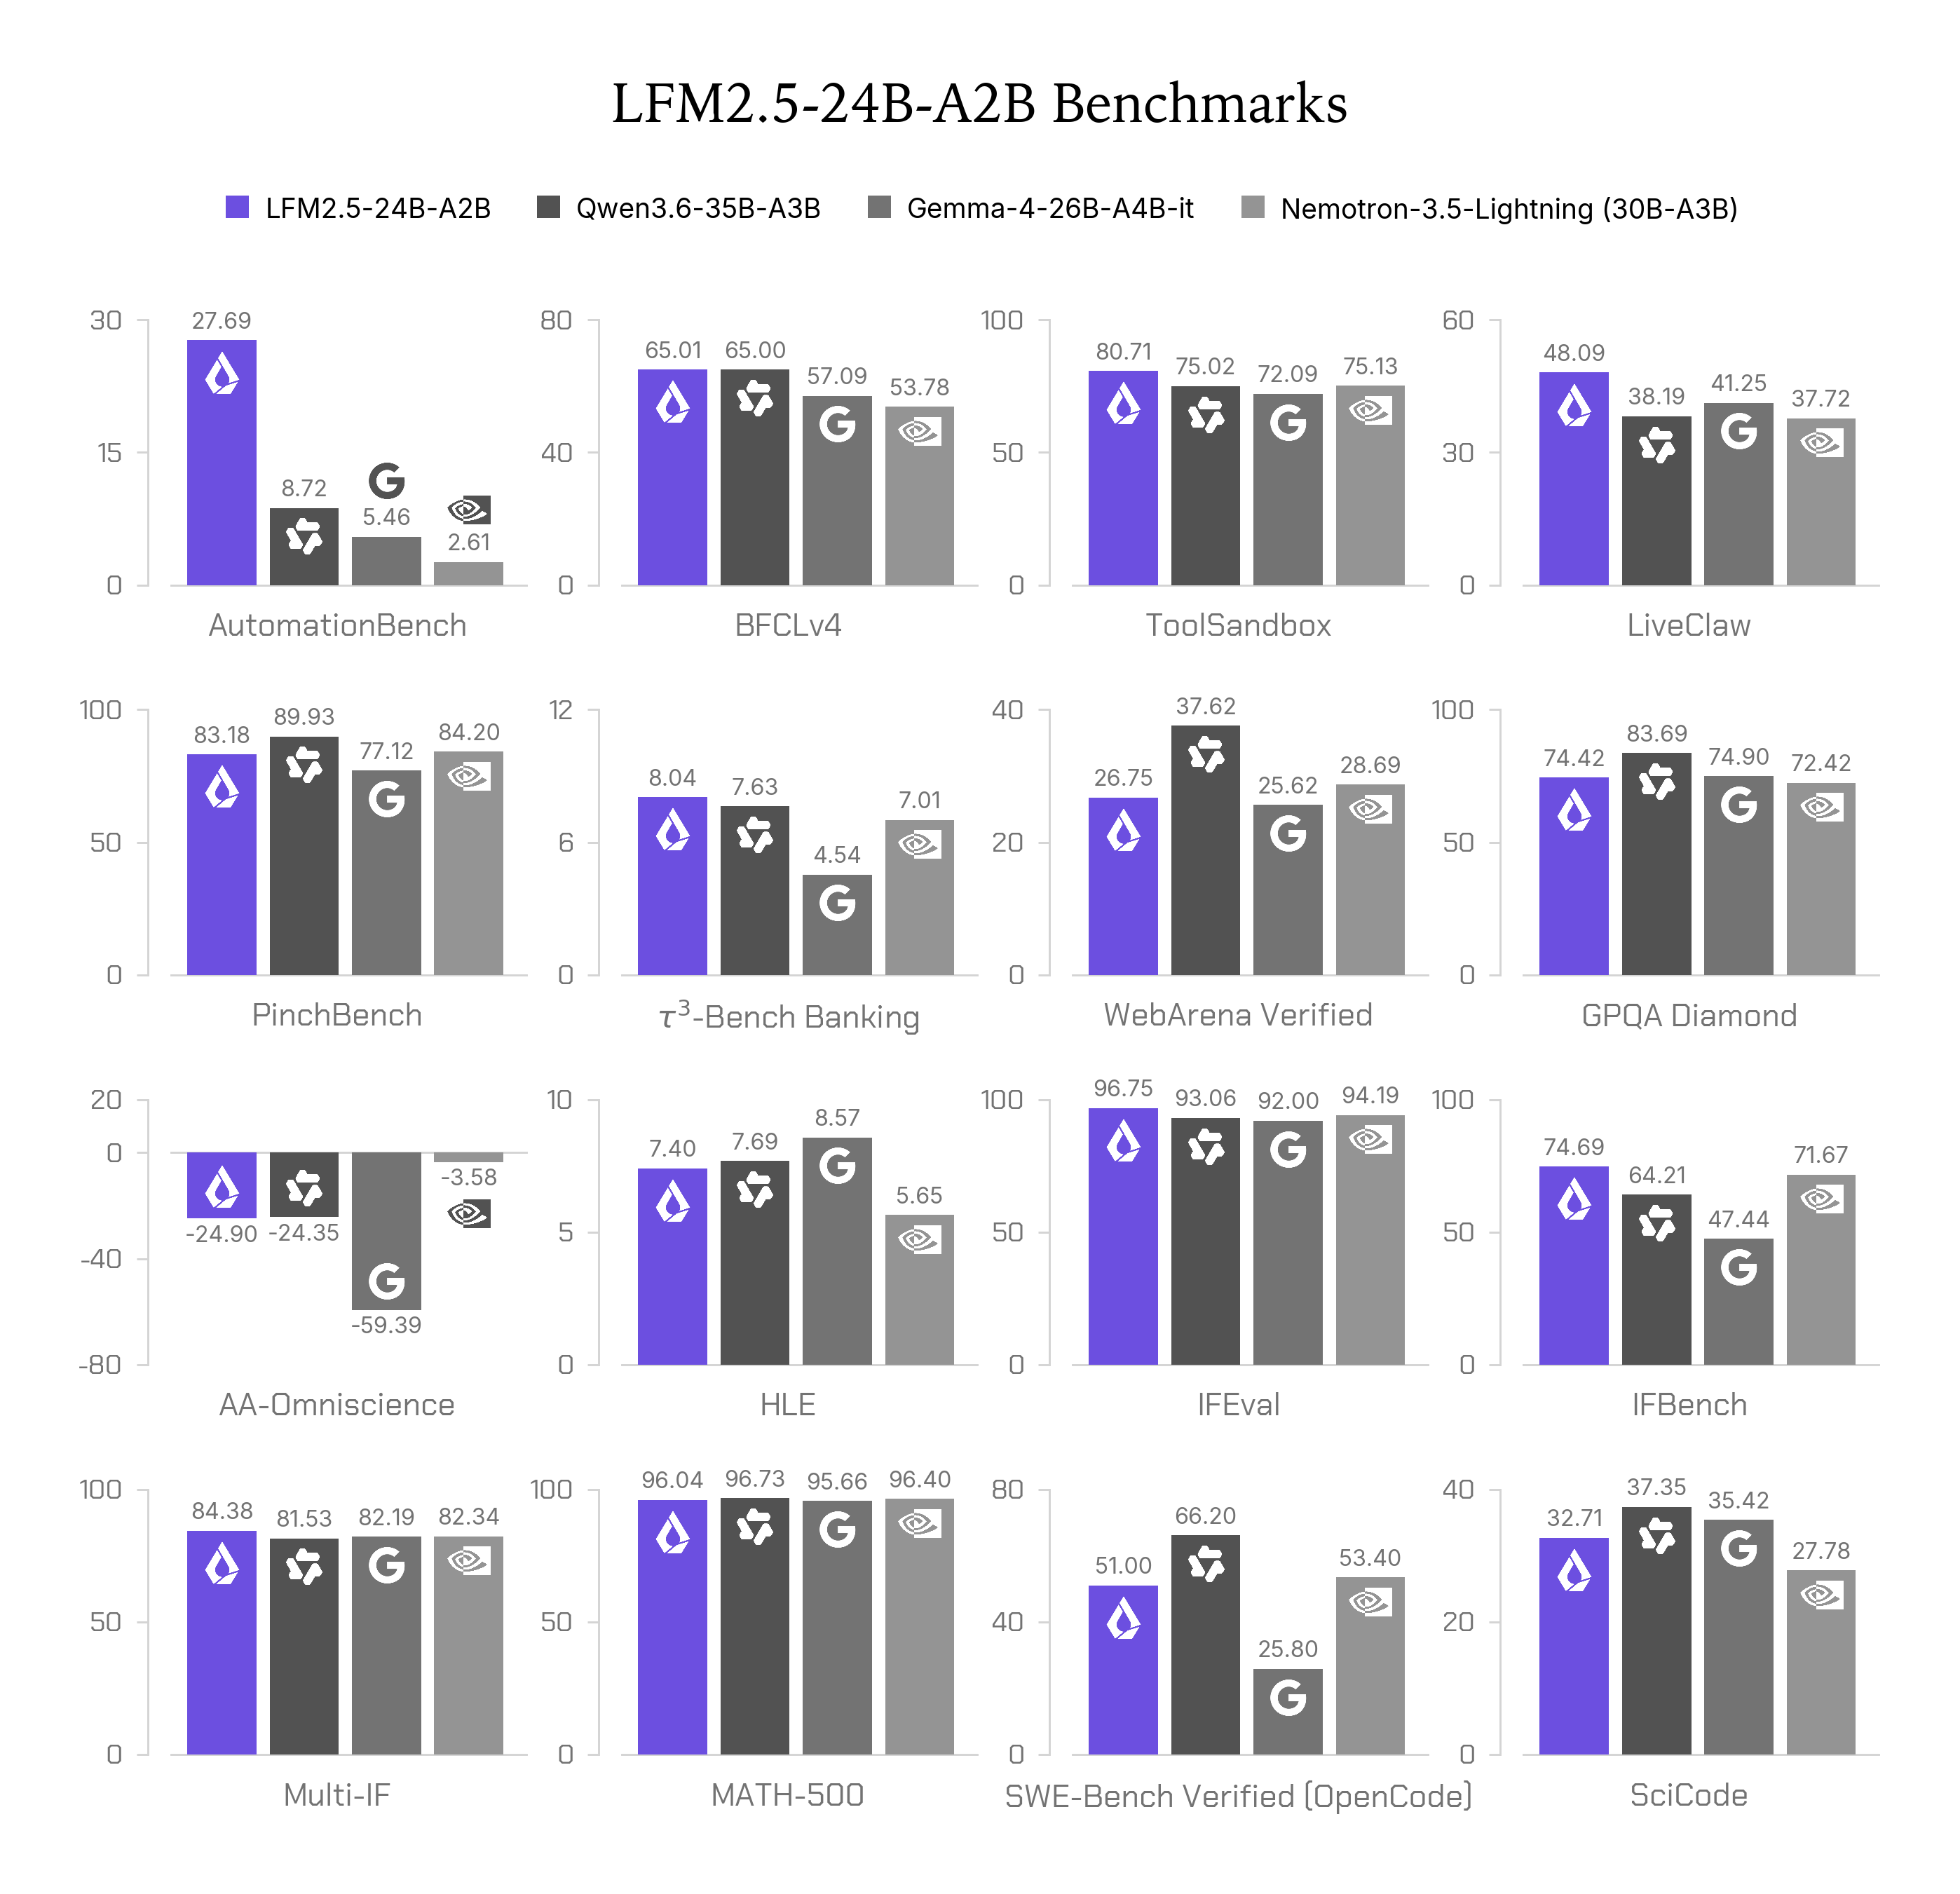
| Benchmark | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning |
|---|---|---|---|---|
| AutomationBench | 27,69 | 8,72 | 5,46 | 2,61 |
| LiveClaw | 48,09 | 38,19 | 41,25 | 37,72 |
| ToolSandbox | 80,71 | 75,02 | 72,09 | 75,13 |
| IFEval | 96,75 | 93,06 | 92,00 | 94,19 |
| SWE-Bench Verified (OpenCode) | 51,00 | 66,20 | 25,80 | 53,40 |
| GPQA Diamond | 74,42 | 83,69 | 74,90 | 72,42 |
No AutomationBench o modelo marca mais do que o triplo do segundo colocado, e no LiveClaw fica dez pontos à frente do Qwen3.6-35B-A3B, que tem cerca de 50% mais parâmetros totais e ativos. O modelo também lidera as três métricas de instruction following testadas (IFEval, IFBench e Multi-IF). Mas a vantagem some em benchmarks de conhecimento e código: em GPQA Diamond, HLE, AA-Omniscience e SWE-Bench Verified, modelos maiores como o Qwen3.6-35B-A3B seguem na frente.
Em resumo: o LFM2.5-24B-A2B é feito para o loop de um agente (entender tarefa, decidir chamar ferramenta, seguir instrução), não para substituir um modelo de conhecimento geral ou um especialista em código. A própria equipe recomenda combiná-lo com busca ou RAG para cargas de trabalho que dependem de conhecimento factual.
Velocidade: o argumento real para rodar local
Os números de inferência são o que sustenta a promessa de "agente contínuo no próprio hardware". Em edge, o modelo decodifica 184 tokens por segundo num Apple M5 Max e 114 tokens por segundo num Ryzen AI Max+ 395, superando as outras MoEs comparadas em até 1,7x enquanto usa menos memória. Em GPU, numa única NVIDIA B300, o modelo passa de 21 mil tokens de saída por segundo em alta concorrência.
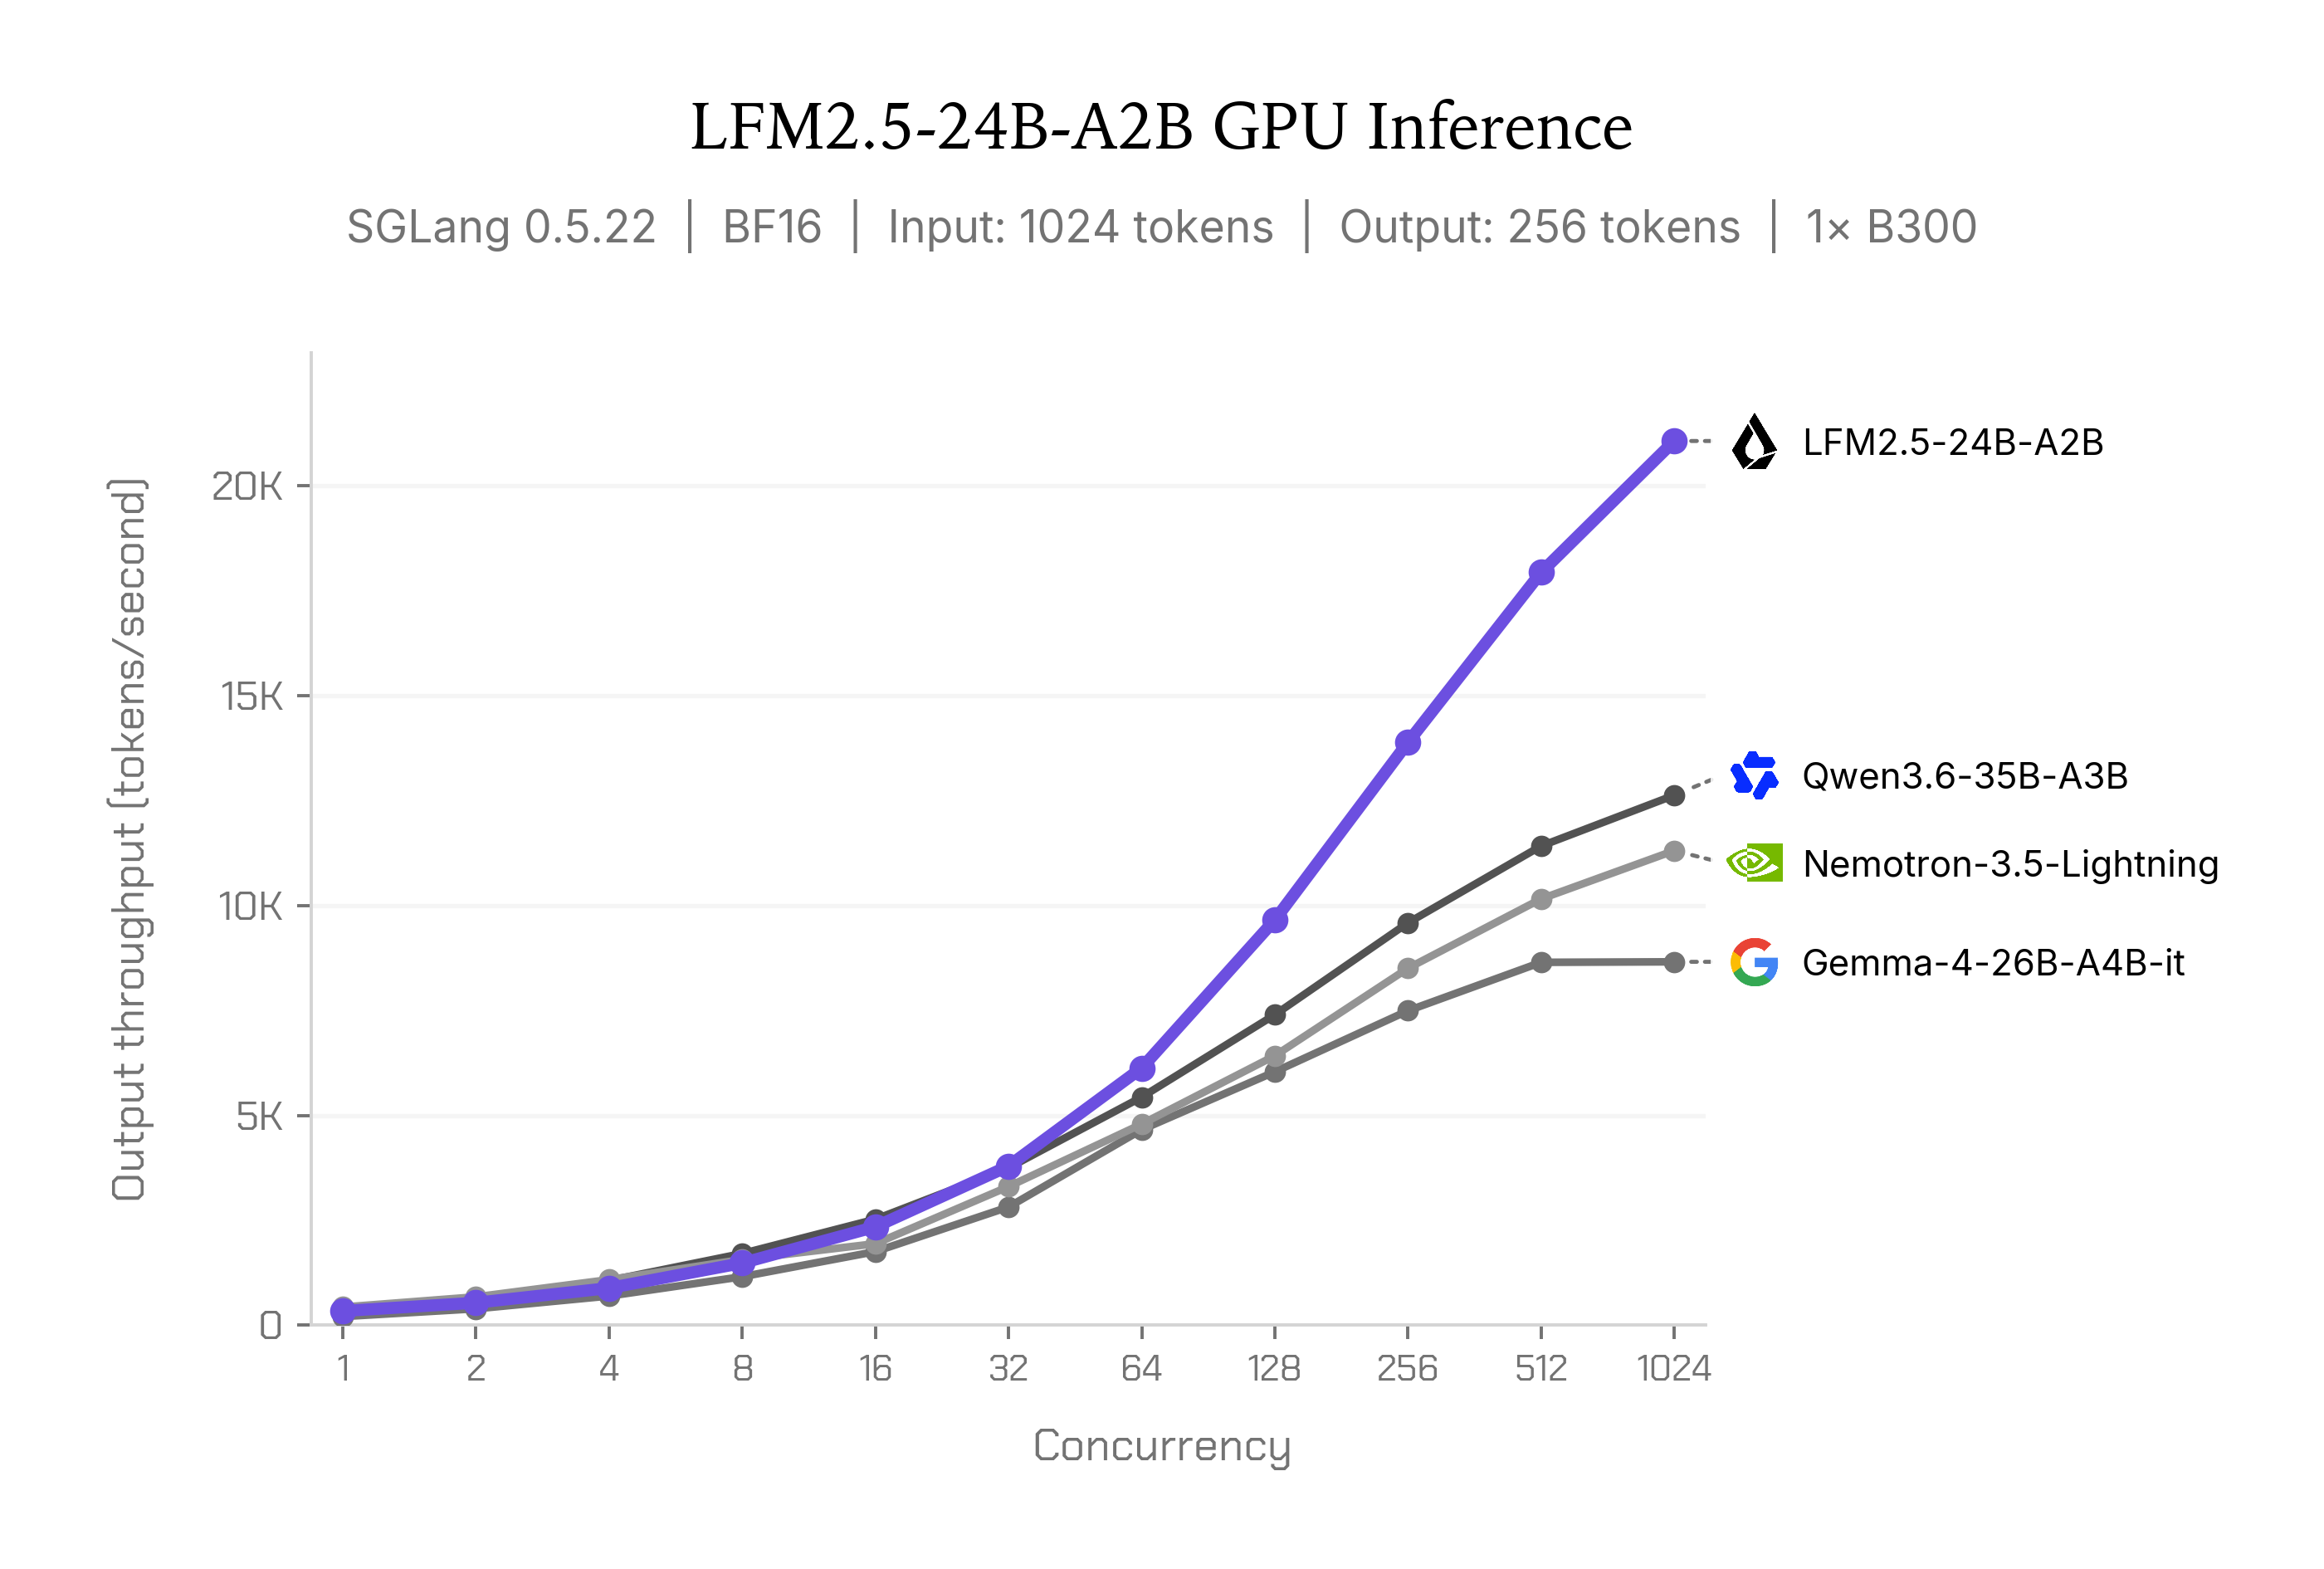
Para o desenvolvedor isso se traduz em um cálculo prático: se o custo marginal por token raciocinado é baixo o suficiente, dá para deixar um agente "pensando" continuamente (monitorando um repositório, triando tickets, observando logs) sem que a conta de API vire o gargalo do projeto. É um argumento de economia operacional, não só de performance de benchmark.
Como rodar na prática
O modelo tem suporte desde o lançamento em llama.cpp, MLX, vLLM, SGLang e ONNX. Via transformers (versão 5.0.0 ou superior), o carregamento segue o padrão já conhecido de modelos causais:
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

model_id = "LiquidAI/LFM2.5-24B-A2B"
model = AutoModelForCausalLM.from_pretrained(
 model_id,
 device_map="auto",
 dtype="bfloat16",
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

prompt = "What is C. elegans?"
input_ids = tokenizer.apply_chat_template(
 [{"role": "user", "content": prompt}],
 add_generation_prompt=True,
 return_tensors="pt",
 tokenize=True,
)["input_ids"].to(model.device)

output = model.generate(
 input_ids,
 do_sample=True,
 temperature=0.1,
 top_k=50,
 repetition_penalty=1.05,
 max_new_tokens=512,
 streamer=streamer,
)
Para plugar num harness de agente, a Liquid AI recomenda servir o modelo atrás de um backend↳Back-end49 conteúdosIntegração front-end com backend: 7 decisões que evitam caos entre APIs, BFF e GraphQLDev (Back & Front) · abr 2026Como criar uma FAKE API REST para testes — JSONPlaceholderDev (Back & Front) · set 2025Construindo um aplicativo de bate-papo de IA simples com Spring AI e AngularDev (Back & Front) · jul 2025Ver tudo em Dev (Back & Front) → compatível com a API da OpenAI e apontar o harness para ele. Com Hermes Agent, por exemplo:
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-24B-A2B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
A porta varia conforme o backend: llama.cpp e MLX usam 8080, vLLM usa 8000, SGLang usa 30000 e LM Studio usa 1234. O model card no Hugging Face traz configurações equivalentes para OpenClaw e Pi.
Quando vale a pena (e quando não)
O LFM2.5-24B-A2B e sua versão base, LFM2.5-24B-A2B-Base, estão disponíveis como open-weight no Hugging Face. Faz sentido considerar o modelo se o projeto depende de um agente que chama ferramentas com frequência, precisa seguir instruções de forma rígida e roda em hardware com memória limitada, seja um Mac com Apple Silicon, um laptop com NPU da linha Ryzen AI ou um único GPU de datacenter. Não faz tanto sentido se a carga de trabalho é majoritariamente geração de código complexo ou perguntas de conhecimento geral profundo, onde os benchmarks mostram os modelos maiores ainda na frente.
Fica em aberto, porque o blog da Liquid AI não detalha, como o modelo se comporta em tarefas agênticas de ponta a ponta fora dos benchmarks controlados, por exemplo num agente operando por horas sobre uma base de código real, ou qual o custo de fine-tuning do modelo para um domínio vertical específico. A empresa promete tutoriais de fine-tuning, mas o material divulgado até aqui cobre só a arquitetura, os benchmarks e o setup inicial.
Fonte: Hugging Face Blog
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Spec do MCP exige OAuth 2.1 completo para servidores remotos de ferramentas
A especificação oficial do Model Context Protocol detalha, desde junho de 2025, um fluxo de autorização baseado em OAuth 2.1 que times com servidores MCP em produção precisam revisar linha por linha.