Coral NPU completa arquitetura RISC-V de 10 mW e ganha compilador que dispensa assembly


Google fechou a arquitetura de 32 bits do Coral NPU e lançou a versão 1.0 do compilador que leva modelos PyTorch, TensorFlow e JAX direto ao silício, sem escrever uma linha de assembly.
Rodar inferência de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → fora da nuvem sempre esbarrou num problema prático: cada fabricante de chip de borda tem sua própria arquitetura, seu próprio compilador e suas próprias limitações de quantização. O resultado, nas palavras do Google Developers Blog, é uma "taxa de fragmentação": o time de ML reescreve kernels, requantiza modelo e depura compilador proprietário para cada novo alvo de hardware.
Foi para atacar isso que o Google Research apresentou, no ano passado, o Coral NPU: um padrão aberto de hardware (arquitetura RISC-V voltada a ML) acoplado a um toolchain open source↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) →. Em 20 de outubro de 2026, coincidindo com o Synaptics Tech Day, o projeto chegou a três marcos que mudam o status do padrão de experimento para algo que já roda em silício comercial.
A arquitetura de 32 bits fica completa
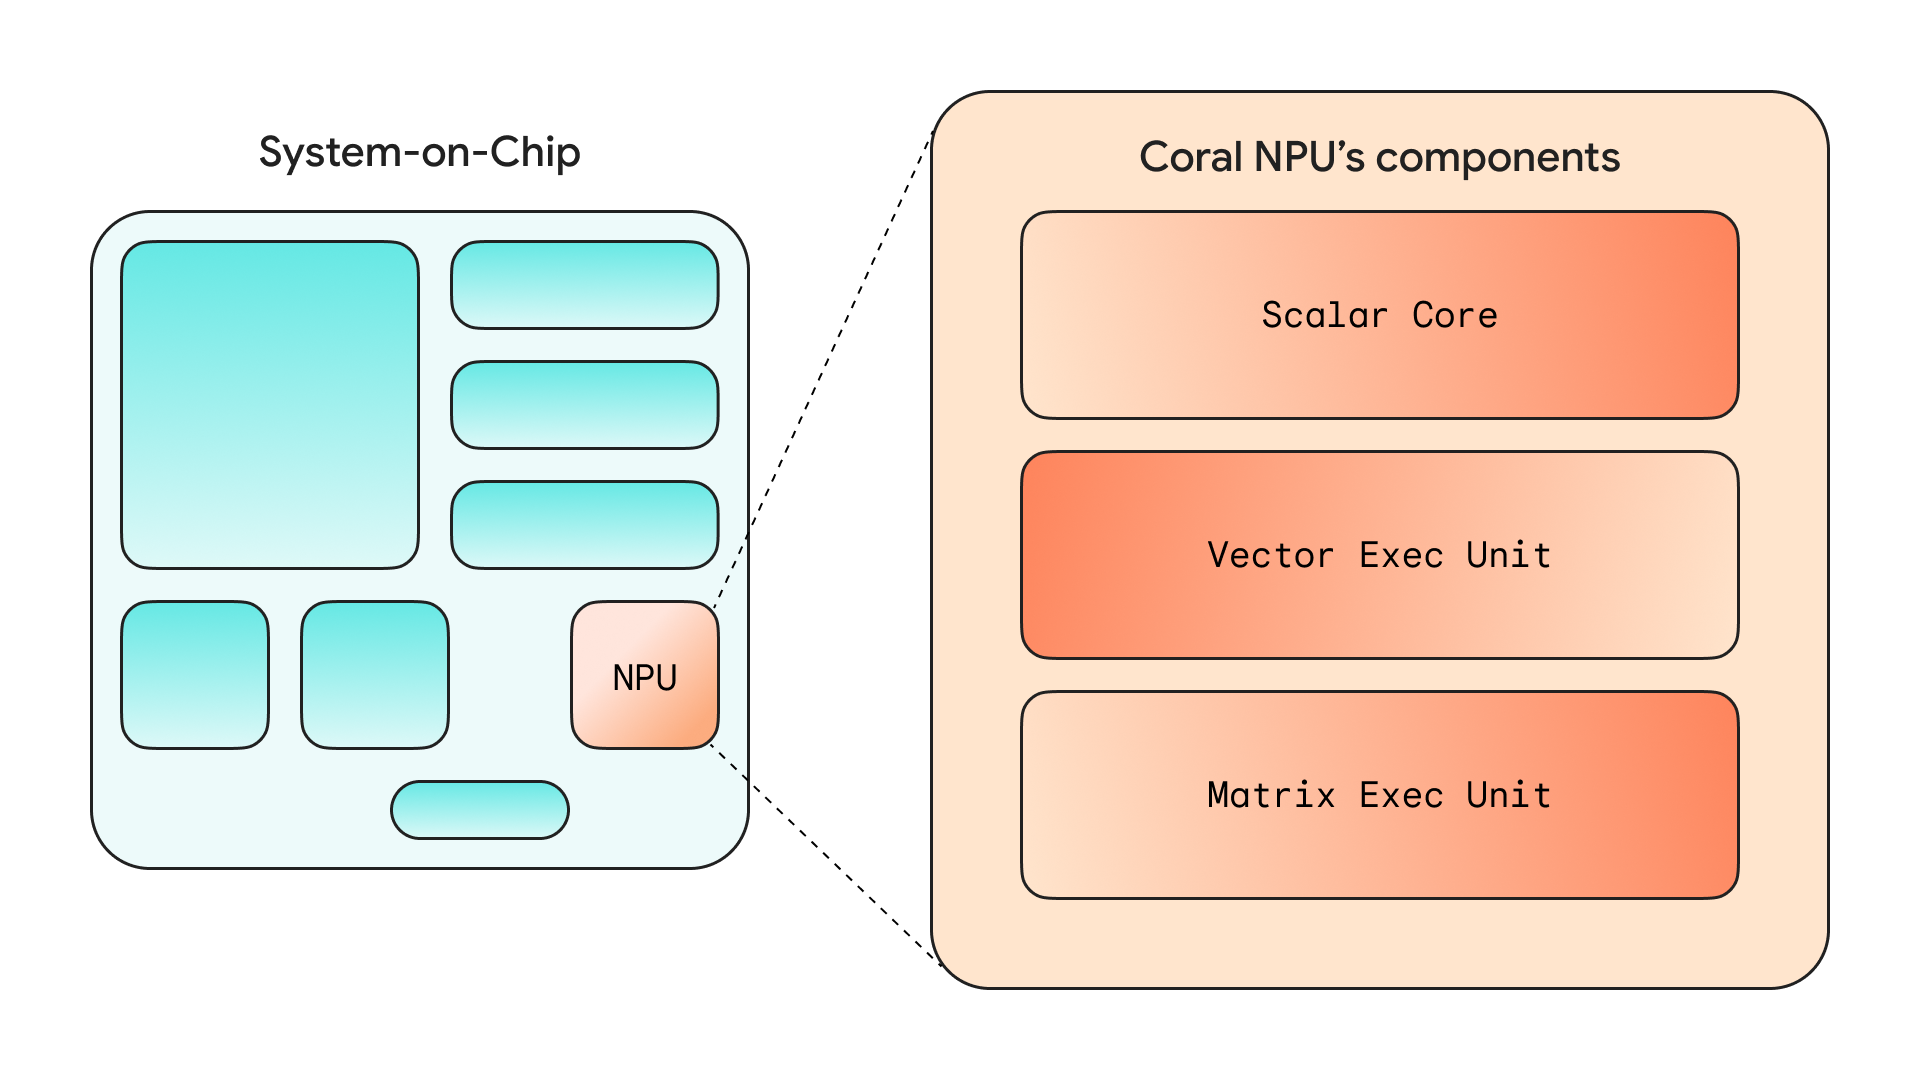
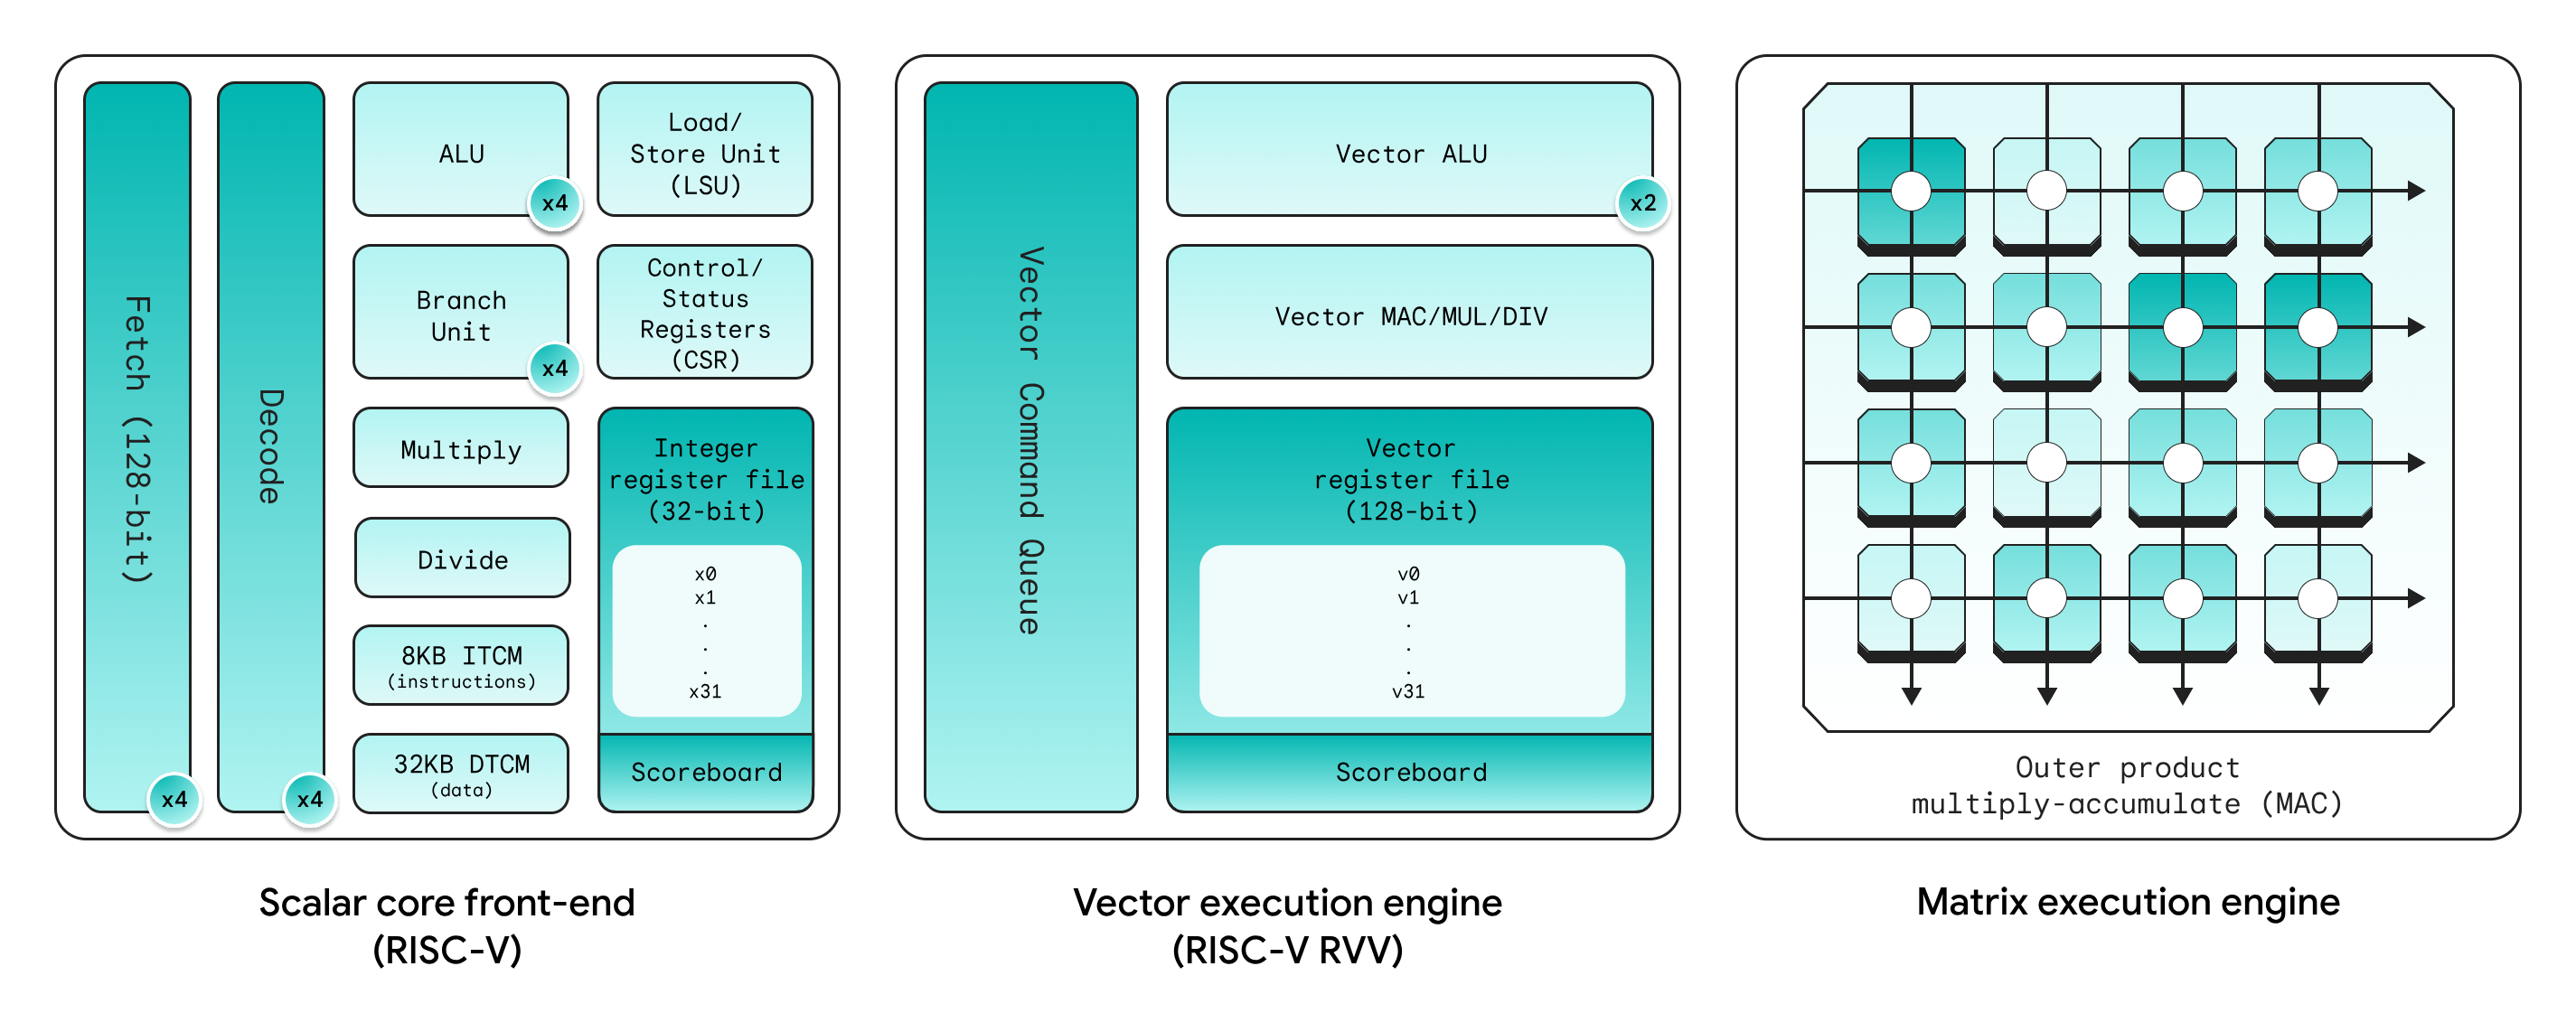
O Coral NPU é construído em quatro blocos ("milestones"). Os três primeiros, lançados ao longo do último ano, cobriam um frontend escalar RISC-V programável em C para controle de fluxo, um coprocessador vetorial RVV v1.0 para operações SIMD e um subsistema de memória com suporte a ponto flutuante. O quarto e último bloco, anunciado agora, é a Matrix Execution Unit (MXU).
A MXU existe porque cargas de ML modernas, de encoders de visão a camadas de atenção de transformer, passam a maior parte do tempo em multiplicação de matrizes (GEMM/GEMV). Rodar matemática 2D num motor vetorial 1D obriga o chip a recarregar pesos e ativações da memória repetidamente, e isso gasta mais energia movendo dado do que fazendo conta. A MXU usa um motor de MAC em outer-product baseado na especificação RISC-V VME (família Zvt), capaz de computar um tile 2D inteiro por ciclo, 256 MACs por ciclo, reaproveitando pesos e ativações em registradores locais.
O resultado prático: throughput escala de forma quadrática, configurável até 1 TOPS, com meta de 10 mW de potência média para inferência. Esse número é o que separa, segundo o Google, dispositivos que só fazem keyword spotting ou detecção simples de movimento de dispositivos capazes de rodar modelos multimodais contínuos, como versões compactas do Gemma, tradução de voz em tempo real em wearables e percepção visual de baixa latência em robôs, tudo numa bateria pequena.
O RTL completo da arquitetura de 32 bits está disponível no GitHub, e o Google diz estar trabalhando com a VeriSilicon na implementação e verificação do design para deixá-lo pronto para tape-out, além de parceria com a GlobalFoundries no processo 12LP+ FinFET, que acelerou o timing do núcleo em 70% e reduziu a área de standard-cell em até 15% entre iterações de RTL.
Do PyTorch ao silício sem escrever assembly
A segunda peça é o Coral Compiler v1.0, construído sobre IREE/MLIR. Ele pega modelos escritos em JAX, PyTorch ou TensorFlow e os leva por representações padronizadas como StableHLO e TOSA até o hardware do Coral NPU. No caminho, o compilador particiona o trabalho entre a CPU host e o núcleo NPU, faz fusão de operadores, faz tiling das matrizes para caber na SRAM local e nos acumuladores de matriz, e progressivamente rebaixa (lowering) tudo para instruções escalares, vetoriais (RVV v1.0) e matriciais (VME) do Coral NPU.
Isso é o que elimina a necessidade de escrever assembly vendor-specific: o fluxo inteiro, do framework de ML até a instrução de silício, passa por um pipeline só. Junto com o compilador, o Google libera o simulador MPACT e um design de referência em FPGA, o que permite benchmarkar modelo e ajustar configuração de silício antes mesmo de o chip ir para fabricação, algo relevante para quem projeta SoC próprio e não pode esperar um tape-out para descobrir que um modelo não roda.
Hardware real: dois Coralboards, um workflow só
O terceiro marco é onde a promessa vira produto. No Synaptics Tech Day, a Synaptics lançou três itens construídos sobre o Coral NPU:
| Produto | Chip | Desempenho | Alvo |
|---|---|---|---|
| Astra SR200 series | 2ª geração Coral NPU IP | 400 GOPS | MCU para wearables e sensores industriais |
| Coralboard SR | Astra SR200 | 400 GOPS | Prototipagem rápida de Edge/Physical AI classe MCU |
| Coralboard SL | Astra SL2619 | 1 TOPS (subsistema Torq/Coral NPU) | IoT e robótica baseados em Linux↳Linux34 conteúdosKali Linux em um Servidor VPS: como, quando e por que usar?DevSecOps · dez 2024Construindo um Windows Service ou Linux Daemon com Worker Service & .NET Core – Parte 2Dev (Back & Front) · jul 2020Criando uma WebApi utilizando .NET, Linux e VSCodeDev (Back & Front) · ago 2019Ver tudo em DevSecOps → |
O Coralboard SL, que teve uma pré-venda limitada no Google I/O, agora está em disponibilidade geral mundial pela DigiKey, com SDK e documentação na página de desenvolvedores da Synaptics. Como as duas famílias de produto compartilham a mesma arquitetura e o mesmo compilador, a equipe de ML otimiza um modelo uma vez e despacha o mesmo binário tanto para um wearable classe miliwatt (Coralboard SR) quanto para uma placa de 1 TOPS (Coralboard SL), usando o mesmo workflow de compilação.
O que isso muda para quem constrói aqui
Para quem desenvolve IoT, robótica ou wearables no Brasil, o ponto central não é o TOPS, é o lock-in. Hoje, migrar um modelo treinado em PyTorch de um MCU para outro geralmente significa trocar de SDK, de formato de quantização e, em muitos casos, de framework de inferência inteiro (TensorFlow Lite Micro num chip, SDK proprietário em outro). Com o Coral NPU, a promessa é compilar uma vez e rodar em qualquer SoC que implemente o padrão, do classe MCU ao classe 1 TOPS, sem reescrever o pipeline de inferência.
Na prática, isso abre caminho para protótipos de sensoriamento de borda, por exemplo em aplicações de agro ou monitoramento industrial, que hoje dependem de keyword spotting simples porque o orçamento de energia não permitia nada mais sofisticado. Com um subsistema matricial dedicado em menos de 10 mW, passa a ser viável cogitar modelos de visão ou áudio mais pesados rodando continuamente numa bateria pequena, sem depender de round-trip para a nuvem a cada inferência.
Vale lembrar que esse ganho é teórico até alguém medir no hardware real: o Google fala em meta de projeto ("targeting 10mW"), não em benchmark publicado de aplicação final. Quem for avaliar o Coralboard SR ou SL via DigiKey deveria tratar esse número como ponto de partida para validação própria, não como garantia de produção.
Onde o padrão ainda não chegou
O Coral NPU é RISC-V, e isso tem dois lados. De um lado, significa não depender de um único fornecedor de IP; do outro, significa um ecossistema de tooling, debugger e suporte comercial ainda bem mais magro do que o de arquiteturas estabelecidas como Cortex-M com TensorFlow Lite Micro, que hoje domina boa parte do IoT embarcado no Brasil. Por ora, o único silício comercial anunciado vem de um parceiro, a Synaptics; não há ainda uma segunda fonte de fabricantes para quem quer evitar dependência de fornecedor único de novo, ironicamente o problema que o padrão aberto se propõe a resolver em nível de arquitetura.
O roteiro do Google já aponta uma arquitetura de 64 bits e suporte a CHERI (segurança de memória em hardware) como próximos passos, o que sinaliza que a plataforma ainda está em formação. Para quem precisa de algo em produção amanhã, o caminho mais seguro é tratar o Coralboard SL como kit de avaliação primeiro: pedir a placa pela DigiKey, rodar o compilador v1.0 contra um modelo real do seu domínio e medir consumo e latência antes de comprometer um projeto de hardware inteiro com a aposta.
Fonte: Google Developers Blog
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Granite Switch 4.1 da IBM junta chat, decisões e fala em um único endpoint
A IBM combina em um só modelo a capacidade de conversar, classificar e transcrever áudio, usando adaptadores leves que compartilham o mesmo cache de GPU.