Um agente pode parecer perfeito na demo e ainda assim estourar custo, travar em loop e falhar silenciosamente em produção. O Google detalha, em playbook publicado em 15 de outubro, como estruturar uma avaliação real além do teste manual.

Um agente pode parecer perfeito na demo e ainda assim estourar custo, travar em loop e falhar silenciosamente em produção. O Google detalha, em playbook publicado em 15 de outubro, como estruturar uma avaliação real além do teste manual.
Por que o teste no olho não serve mais
Quando um time começa a construir um agente de IA↳Agentes de IA42 conteúdosOpera passa a integrar ChatGPT, Claude e outros agentes de IADev (Back & Front) · mar 2026Operações mais inteligentes, decisões mais rápidas: o impacto da IA agêntica na rotina de TIAI · abr 2026Adobe aposta em orquestração de agentes de IA: o que muda para devsDev (Back & Front) · abr 2026Ver tudo em AI →, o teste inicial costuma ser sempre o mesmo: conectar um modelo, dar algumas ferramentas a ele, rodar três ou quatro prompts no terminal e julgar a resposta no olho. Se parece razoável, vai para produção. O problema, descrito em artigo publicado em 15 de outubro de 2026 no Google Developers Blog por Hugo Selbie, Dani Zamora e Jesse Carah (times de Customer & Partner Solutions e Incubation do Google), é que esse método quebra rápido assim que o agente ganha complexidade.
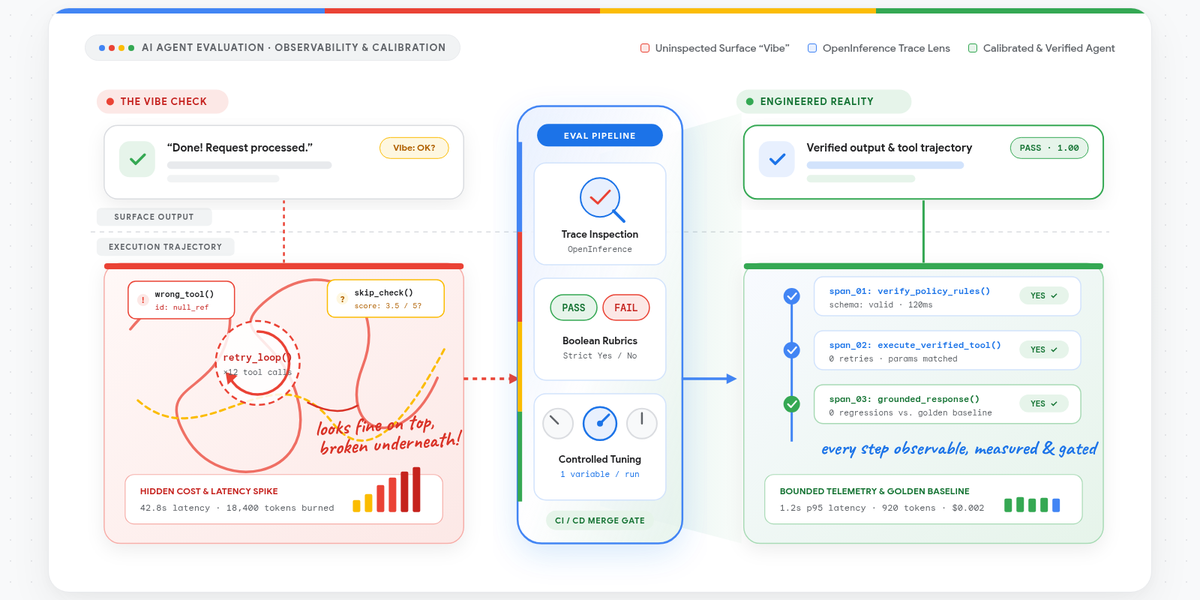
Um ajuste no system prompt que corrige um caso de borda em um fluxo pode fazer o agente parar de chamar uma ferramenta obrigatória em outro. Pior: agentes falham de um jeito que nenhum teste visual pega. Um agente pode entrar em loop de retry, disparar múltiplas chamadas de ferramenta e ainda assim devolver uma resposta educada e plausível no final.
Essa falha silenciosa custa caro em produção:
- Infla a conta de nuvem e o consumo de tokens sem aviso.
- Estoura limites de taxa e cotas de APIs downstream.
- Deixa o usuário olhando para um spinner de carregamento.
- Dispara efeitos colaterais duplicados em sistemas externos, tudo enquanto a resposta final parece perfeitamente normal.
Em resumo: o texto de saída pode estar impecável e o sistema por trás dele estar quebrado. É exatamente isso que um teste manual não enxerga.
Critical user journeys: a base de tudo
O primeiro pilar do framework é parar de testar contra benchmarks abstratos e ancorar os testes em "critical user journeys" (CUJs): descrições do que o usuário espera do sistema, estruturadas em torno de persona, objetivos, restrições e condições de verificação. O artigo traz um exemplo de como uma CUJ bem escrita se parece:
Como analista de operações, espero que o agente processe um e-mail de divergência de contraparte, identifique a transação contestada, verifique a economia do trade em relação ao nosso ledger interno em até 30 segundos e redija uma resposta convertendo nossos IDs internos de volta para a nomenclatura do broker, sem intervenção humana.
As an operations analyst, I expect the agent to ingest a counterparty trade discrepancy email, identify the disputed transaction, verify the trade economics against our internal ledger within 30 seconds, and draft a response reverse-translating our internal trade IDs back into the broker's nomenclature without human intervention.Exemplo de CUJ, Google Developers Blog
Cada cláusula dessa frase vira um ponto de avaliação separado: o agente resolveu a transação correta? Checou o ledger antes de redigir a resposta? Mapeou os IDs internos de volta para a nomenclatura externa? É esse tipo de granularidade que falta num teste de terminal baseado só em impressão.
De usuário simulado a tráfego real
Não é preciso meses de logs de produção para montar o primeiro conjunto de testes de referência. A recomendação é quebrar cada CUJ em cenários concretos, cobrindo tanto o caminho feliz quanto casos de borda, e alimentar isso para um LLM simulador de usuário (o artigo cita as ADK user simulations como referência). Com uma persona e restrições de comportamento, como um analista impaciente que dá números de ticket incompletos, o simulador reproduz a bagunça de frases reais, erros de digitação e conversas de múltiplos turnos.
Rodando o agente contra esses usuários sintéticos, dá para registrar traces completos de execução, incluindo os logs de chamada de ferramenta, antes mesmo de qualquer usuário real tocar no sistema. Conforme o tráfego de produção começa a fluir, esses cenários sintéticos vão sendo substituídos gradualmente por traces reais, numa transição contínua em vez de uma troca abrupta de método.
Quatro camadas, não um score único
Um placar único nunca vai dizer por que um agente falhou. Para isolar a causa raiz, o framework separa a avaliação em quatro camadas:
- Testes unitários: validam componentes isolados, como o parsing de parâmetros de uma ferramenta.
- Métricas determinísticas: contagem de chamadas de ferramenta, checagem de schema de saída, latência.
- LLM-as-a-judge com rubricas: um modelo avalia se uma condição qualitativa foi cumprida.
- Testes de integração: validam o fluxo completo, ponta a ponta.
As quatro armadilhas mais comuns
| Armadilha | O erro | Por que importa |
|---|---|---|
| Descartar testes | Apagar ou trocar casos de teste entre rodadas | Invalida a baseline: não dá pra saber se o agente melhorou ou se o teste mudou |
| Nota de 1 a 5 | Pedir a um juiz LLM uma escala subjetiva | A fronteira entre "3" e "4" varia de rodada pra rodada; perguntas booleanas (sim/não) são mais estáveis |
| Avaliar só o texto | Ignorar custo, latência e chamadas de ferramenta | Uma resposta perfeita que levou 40 segundos e custou sessenta centavos de dólar por consulta ainda é uma falha de produção |
| Pipeline por framework | Reescrever a suíte de testes a cada troca de orquestrador | Frameworks diferentes emitem OpenTelemetry, mas com convenções semânticas distintas para tool calls e tokens |
Para a quarta armadilha, a saída proposta é padronizar os traces em torno da especificação aberta OpenInference, desacoplando a avaliação do framework de orquestração usado, seja LangGraph, Google ADK ou um runtime próprio.
O rollout: de Day 0 a Day 2
O artigo organiza a adoção em três estágios, usando o toolkit open source↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) → agent-eval como ferramenta de referência. Ele combina captura de traces OpenTelemetry com o serviço Agent Evaluation da plataforma Gemini, antigo Vertex AI Evaluation.
No Day 0, o time escreve cenários para as principais CUJs, roda simulações e lê os traces de execução do início ao fim com o que o artigo chama de "caneta vermelha": marcar cada ponto em que o agente hesitou, alucinou um parâmetro, escolheu a ferramenta errada ou enrolou na resposta. Ler vinte traces manualmente parece mais lento do que gerar um gráfico automático, mas é esse exercício que mostra como o sistema realmente quebra, em vez de chutar modos de falha hipotéticos.
No Day 1, as anotações da caneta vermelha viram checagens automatizadas:
- O
agent-evalexecuta cenários multi-turno contra o agente via HTTP, usando a flag--base-url, ou offline. - Ele ingere traces estruturados em convenções OpenInference, independentemente do framework usado.
- Roteia tudo para o serviço de Agent Evaluation rodar as checagens determinísticas e as rubricas booleanas, sem código de API sob medida.
A cada mudança de prompt, troca de modelo ou edição de docstring de ferramenta, a mesma bateria de testes roda de novo e o resultado é comparado contra a baseline. O artigo também insiste num ponto: nenhuma métrica de juiz automatizado deve ser confiada sem antes ser validada contra os traces que o time já revisou à mão no Day 0.
No Day 2, o pipeline vira porta de merge. Rodando de forma headless em CI/CD↳CI/CD23 conteúdosCI/CD Mobile: o caos invisível que separa times comuns de times de alta performanceDev (Back & Front) · abr 2026Lambda: implementando com GitLab CI/CD e Terraform para Integração SFTP, S3 e Databricks em GoDev (Back & Front) · nov 2023Publicando sua aplicação Web Python no WebApp do Azure e configurando o CI/CD da sua aplicaçãoDevSecOps · abr 2019Ver tudo em DevSecOps →, como Cloud Build ou GitHub Actions, ele aplica duas regras: a suíte precisa bater um piso mínimo de aprovação (95% de sucesso booleano, no exemplo do artigo) e nenhuma métrica que já passava pode regredir, mesmo que o placar geral se mantenha estável. Os artefatos de cada rodada, como traces brutos em JSONL, hashes de prompt, versões de modelo e perfis de latência, vão para um data warehouse como BigQuery ou Cloud Storage, alimentando um dashboard compartilhado pelo time.
O ciclo de ajuste fino: dezenas de voltas, não reescritas
Segundo o artigo, atingir qualidade de produção costuma levar de 50 a 60 pequenas iterações, não reescritas do system prompt inteiro a cada manhã. Um ajuste esclarece a descrição de um parâmetro de ferramenta; o próximo adiciona uma restrição negativa; o seguinte ajusta o schema JSON de saída.
O relatório HTML gerado pelo agent-eval a cada rodada junta, numa visão só, as métricas booleanas de pass/fail e os números operacionais: latência, consumo de tokens, custo de API, uso de cache e o caminho de execução das chamadas de ferramenta. Ele ainda inclui uma análise automática de causa raiz feita pelo Gemini para cada turno que falhou, apontando a diretriz de prompt ou o parâmetro que disparou o problema.
Essa visão evita decisão por achismo. Uma mudança de prompt pode parecer muito melhor na checagem manual e, ainda assim, a bateria de testes revelar que a latência dobrou e as alucinações em chamadas de ferramenta subiram 15%. A lição que os autores tiram disso é direta: mudanças pequenas e medidas vencem reescritas grandes, de forma consistente.
O que muda para quem constrói agentes
Para quem já trabalha com LangGraph, Google ADK ou qualquer stack agentic, a proposta do artigo é menos sobre adotar uma ferramenta específica e mais sobre um hábito: tratar avaliação como parte do ciclo de desenvolvimento desde o primeiro protótipo, não como etapa posterior. O ponto de entrada é barato, um conjunto pequeno de cenários de teste e uma tarde lendo traces com atenção, e o valor aparece exatamente no momento em que a demo bonita começa a receber tráfego de verdade.
Vale o alerta inverso também: times que já têm alguma suíte de testes ad-hoc ganham mais apagando menos dela. A armadilha de descartar testes entre rodadas é das mais fáceis de cair, porque parece limpeza de código, mas na prática empurra a baseline para debaixo do tapete. Antes de comemorar que um novo prompt melhorou o placar, vale confirmar se o conjunto de testes usado é exatamente o mesmo de antes.
Fonte: Google Developers Blog
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
OpenAI Agents SDK: como montar handoffs e guardrails entre agentes antes de ir para produção
O OpenAI Agents SDK oferece três peças (agentes, handoffs e guardrails) para orquestrar times de LLMs em Python. O tutorial mostra como montá-las e onde a arquitetura tende a quebrar antes da produção.