Black Forest Labs lançou o modelo aberto com suporte nativo no Diffusers, imagem com múltiplas referências e edição guiada por coordenadas; veja como instalar, os custos de GPU e o que muda no código.

O que muda com o FLUX.3 Image Klein
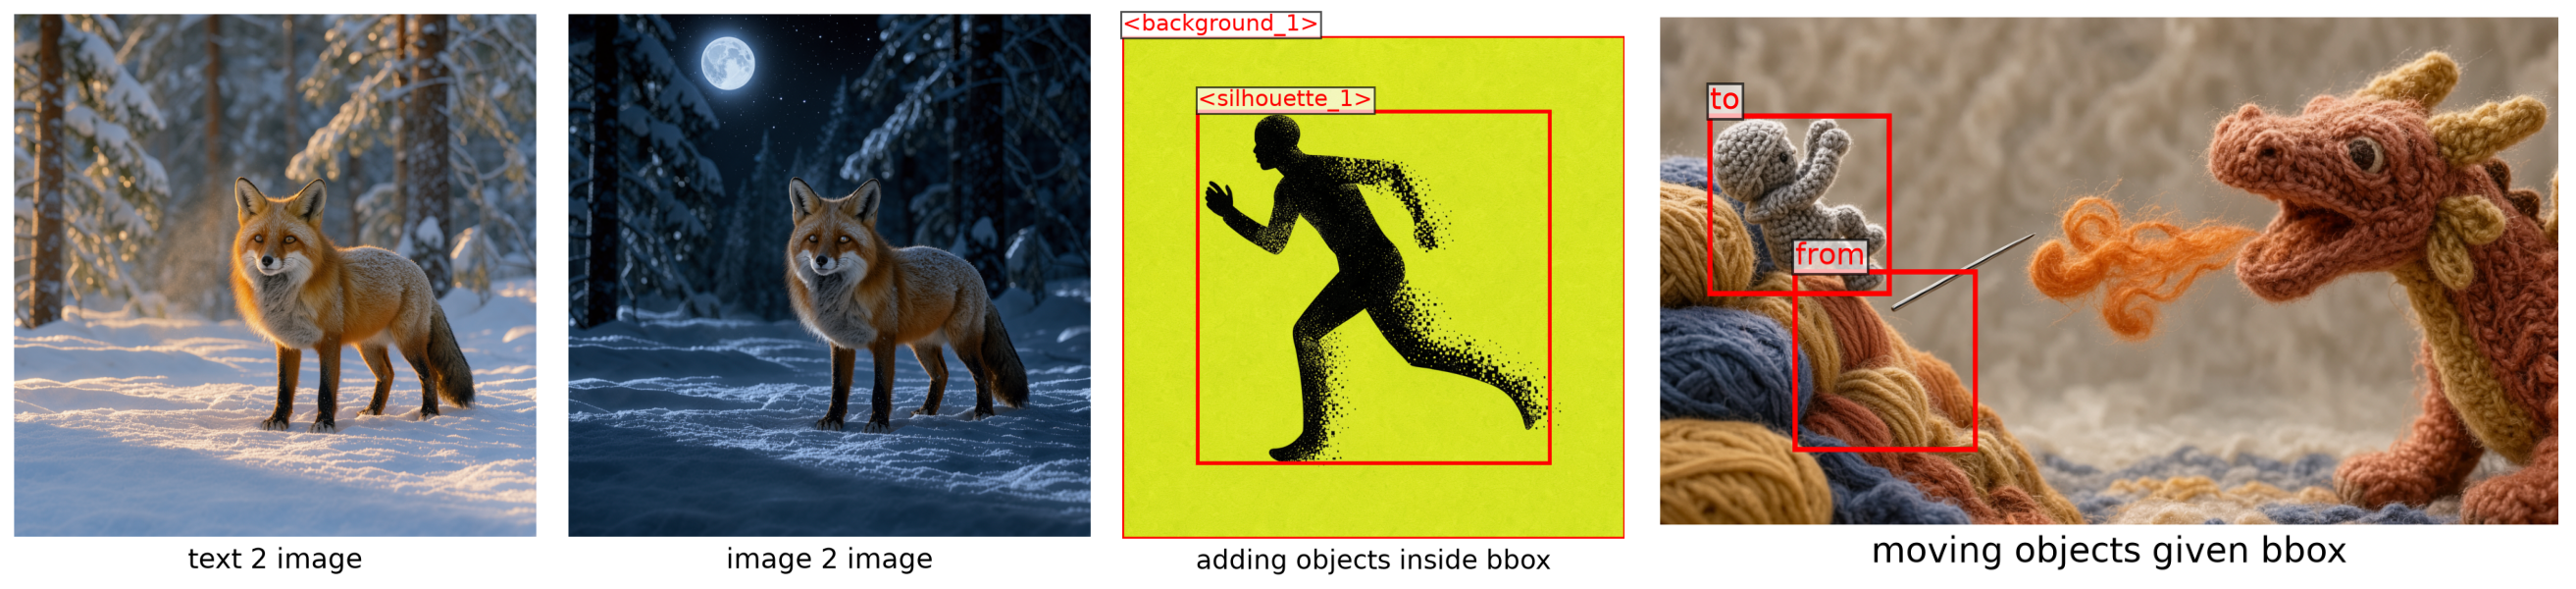
A Black Forest Labs publicou, em 15 de outubro de 2026, o FLUX.3 Image Klein, novo modelo aberto de geração de imagem que já roda na biblioteca Diffusers, da Hugging Face, desde o dia do lançamento. A novidade central não é só mais um gerador de texto para imagem: o mesmo checkpoint faz texto para imagem, edição com múltiplas imagens de referência e, pela primeira vez na família FLUX, controle de layout por bounding box. O usuário escreve no prompt onde cada elemento da cena deve ficar, em coordenadas normalizadas, e o modelo respeita.
Há duas versões abertas, reunidas na coleção FLUX.3 Image Klein no Hugging Face: black-forest-labs/flux-3-image-klein, destilada por passo de tempo (16 passos, sem classifier-free guidance), pensada para inferência rápida; e black-forest-labs/flux-3-image-klein-base, o modelo base, com 50 passos e CFG, recomendado como ponto de partida para fine-tuning. Também dá para testar sem instalar nada, pelo espaço que a Black Forest Labs disponibilizou no Hugging Face.
Rodando localmente com Diffusers
A integração veio pronta via ModularPipeline, a arquitetura modular que o time do Diffusers vem consolidando. Para instalar, segundo o post oficial do Hugging Face Blog, é preciso puxar a versão mais recente do pacote, porque o FLUX.3 usa o Qwen3-VL como text encoder:
pip install -U diffusers transformersCarregar o checkpoint destilado e gerar uma imagem leva poucas linhas:
import torch
from diffusers import ModularPipeline

pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein")
pipe.load_components(dtype=torch.bfloat16)
pipe.to("cuda")

pipe(prompt="a red fox", output="images")[0].save("fox.png")
A fonte recomenda prompts descritivos completos (sujeito, cenário, luz, composição, estilo) em vez de palavras soltas. Para trocar resolução ou número de passos, os parâmetros height, width e num_inference_steps entram direto na chamada do pipeline.
Multi-referência e o controle de layout
A parte que separa o FLUX.3 Image Klein de modelos anteriores da família é dupla. Na edição simples, passa-se uma imagem em image=, e o prompt funciona como legenda do resultado desejado, já incluindo a mudança. Com mais de uma referência, cada imagem é citada no prompt como <ref_image_0>, <ref_image_1> e assim por diante, na ordem em que aparecem na lista passada a image, o que permite compor elementos de fotos diferentes numa cena só.
O controle de layout entra como um bloco JSON anexado ao prompt, com uma lista de regiões. Cada região tem um id, um bbox (coordenadas [y_min, x_min, y_max, x_max], na escala 0 a 1000, independente do tamanho real da imagem) e uma desc. Para edição, em vez de um bbox único, cada região leva um src_bbox (de onde vem, na referência) e um tgt_bbox (para onde vai, na saída); quando os dois são iguais, o elemento fica no lugar.
O exemplo do cavaleiro de amigurumi, usado no post oficial do Hugging Face Blog (assinado por Aritra Roy Gosthipaty, Sayak Paul e Linoy Tsaban, da equipe de Diffusers/Hugging Face) para ilustrar o lançamento do modelo, mostra o caso de uso: mover só a figura do cavaleiro na imagem, mantendo pano de fundo, penhasco, agulha e dragão intactos, cada um com src_bbox igual ao tgt_bbox para travar a posição. É uma forma de edição guiada por coordenadas que até agora dependia de máscaras pintadas à mão ou de inpainting menos previsível.
Variantes quantizadas, para quem não tem um H100
A Black Forest Labs também publica o transformer em arquivo único, em bf16 e em dois formatos quantizados, fp8r (FP8 por linha) e nvfp4, carregáveis com from_single_file sem baixar o peso bf16 completo:
from diffusers import BFLQuantizationConfig, Flux3Transformer2DModel, ModularPipeline

model_id = "black-forest-labs/flux-3-image-klein-base"
variant = "fp8r"  # ou "nvfp4"

transformer = Flux3Transformer2DModel.from_single_file(
    f"https://huggingface.co/{model_id}/blob/main/variants/{variant}/model.safetensors",
    config=model_id,
    subfolder="transformer",
    quantization_config=BFLQuantizationConfig(compute_dtype=torch.bfloat16),
    dtype=torch.bfloat16,
)

pipe = ModularPipeline.from_pretrained(model_id)
pipe.update_components(transformer=transformer)
O fp8r tem kernels rápidos em GPUs com compute capability 8.9 ou superior (Ada, Hopper, Blackwell); em placas mais antigas, o peso é desquantizado a cada passo, o que economiza memória mas não acelera nada. O nvfp4 segue a mesma lógica, só que exigindo Blackwell com flashinfer-python e flashinfer-cubin na mesma versão para ganhar velocidade.
Os números de memória publicados pela Hugging Face dão uma régua para decidir qual variante vale:
| Variante | GPU | Pico após carregar | Pico após inferência |
|---|---|---|---|
| nvfp4 | RTX6000 | 13,4 GiB | 15,3 GiB |
| fp8r | H100 | 14,35 GiB | 16,27 GiB |
| bf16 | H100 | 18,80 GiB | 20,72 GiB |
Para GPU ainda mais modesta, o post sugere liberar o text encoder depois de usá-lo (ele roda uma vez por imagem, antes do denoising) e ligar o offload automático via ComponentsManager.enable_auto_cpu_offload, que move cada componente para a GPU só enquanto ele está em uso. A própria Hugging Face não mediu esse caminho, então não há número de referência para ele.
Quanto custa rodar, em tempo
Os testes de velocidade publicados foram feitos numa única H100 de 80 GB, sem offload, com o backend↳Back-end49 conteúdosIntegração front-end com backend: 7 decisões que evitam caos entre APIs, BFF e GraphQLDev (Back & Front) · abr 2026Como criar uma FAKE API REST para testes — JSONPlaceholderDev (Back & Front) · set 2025Construindo um aplicativo de bate-papo de IA simples com Spring AI e AngularDev (Back & Front) · jul 2025Ver tudo em Dev (Back & Front) → de atenção padrão, média de três execuções após aquecimento, usando o checkpoint destilado (16 passos):
- Texto para imagem, 1024×1024: 1,93 s, pico de 23,8 GiB
- Imagem-a-imagem, uma referência de 1024×1024: 3,87 s
- Edição por layout (o exemplo do cavaleiro), referência de 1360×768: 4,10 s
Uma referência praticamente dobra o tempo porque seus tokens entram na mesma sequência que o texto e a imagem sendo gerada: uma referência de 1024×1024 soma 4.096 tokens a cada chamada do transformer. É o tipo de custo que precisa entrar na conta de latência antes de colocar em produção uma feature com várias referências por chamada, porque o tempo cresce a cada imagem extra, não fica fixo.
Fine-tuning com LoRA
O Diffusers já traz scripts de DreamBooth LoRA para as duas tarefas, texto para imagem e edição de imagem. O exemplo oficial treina um estilo de tarot a partir do dataset multimodalart/1920-raider-waite-tarot-public-domain, disparado pela palavra-gatilho trtcrd:
accelerate launch train_dreambooth_lora_flux3_klein.py \
  --pretrained_model_name_or_path="black-forest-labs/flux-3-image-klein-base" \
  --dataset_name="multimodalart/1920-raider-waite-tarot-public-domain" \
  --caption_column="caption" \
  --instance_prompt="trtcrd" \
  --output_dir="trained-flux3-tarot-lora" \
  --mixed_precision="bf16" \
  --resolution=1024 \
  --use_aspect_ratio_buckets \
  --train_batch_size=1 \
  --rank=16 \
  --lora_alpha=16 \
  --learning_rate=1e-4 \
  --lr_scheduler="constant" \
  --max_train_steps=1500 \
  --validation_prompt="a trtcrd of a cat, tarot style" \
  --validation_epochs=25 \
  --seed=0 \
  --push_to_hub
É o checkpoint base (50 passos, com CFG) que serve de ponto de partida para fine-tuning, não o destilado: o post é explícito nisso. Para quem tem menos VRAM, três flags mudam o custo direto: --gradient_checkpointing recalcula ativações no backward (menos memória, mais lento), --cache_latents pré-codifica as imagens e libera a VAE, e --use_8bit_adam mantém o estado do otimizador em 8 bits. Para edição baseada em instrução, o script train_dreambooth_lora_flux3_klein_img2img.py treina em trincas de imagem de referência, imagem alvo e instrução.
Por baixo do capô: duas etapas de atenção
A arquitetura explica por que o layout funciona tão bem. O FLUX.3 é um modelo de flow matching no espaço latente: a VAE (a mesma do Flux.2) comprime a imagem 8× em cada direção, gerando 32 canais, e empacota cada bloco de 2×2 desse latente num único token de 128 canais. Isso dá um token por patch de 16×16 pixels; uma imagem de 1024×1024 vira uma grade de 4.096 tokens, e cada referência passa pelo mesmo caminho, mantendo seu próprio tamanho.
O texto passa pelo Qwen3-VL, mas o FLUX.3 não usa só a última camada: lê os estados ocultos de 8 das 36 camadas (4, 8, ..., 32), empilha isso num vetor de 20.480 dimensões e projeta para os 3072 do transformer, trazendo informação de várias profundidades do modelo de linguagem↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI →, não só da camada final.
O transformer processa tudo em dois estágios. No primeiro, cada modalidade (texto, imagem ruidosa, referências) passa por 5 blocos com pesos próprios, sem conversar entre si. No segundo, as três sequências são concatenadas em [texto | imagem | referência] e passam por 28 blocos com pesos compartilhados, onde tudo atende a tudo. É uma diferença de desenho em relação ao Flux.2, cujos blocos "double-stream" já deixam texto e imagem conversarem desde o início; o FLUX.3 separa primeiro, funde depois.
Outro detalhe sustenta a edição por coordenadas: cada token recebe seu próprio timestep de modulação. Os tokens da imagem ruidosa são modulados pelo passo de tempo corrente; texto e referência são sempre modulados pelo timestep 0, ou seja, "já limpo, não precisa de denoising", o que marca explicitamente uma referência como contexto dado, não como algo a ser gerado. O posicionamento usa RoPE em quatro eixos, (t, h, w, l), e como a referência usa as mesmas coordenadas (h, w) da saída, "o mesmo ponto na referência" tem um significado preciso para o modelo, exatamente o que o src_bbox/tgt_bbox explora.
O que muda pra quem constrói com isso
Pra quem já integra geração de imagem num produto, dois pontos pesam mais que o resto. Primeiro, o controle de layout por coordenadas normalizadas tira uma camada de incerteza que inpainting por máscara sempre carregou: dá para versionar um prompt com JSON de bounding boxes e esperar reprodutibilidade razoável, em vez de redesenhar máscara a cada tentativa. Segundo, o custo de referência dobrando o tempo de inferência precisa entrar na conta de latência antes de uma feature de edição com múltiplas fotos ir para produção, porque cresce a cada imagem extra na chamada.
Quem já usa Diffusers com FLUX.1 ou FLUX.2 não precisa reaprender muita coisa: a API muda pouco, e o pipeline continua modular, dá para trocar blocos individuais via ModularPipeline. A decisão prática está nas variantes: nvfp4 só compensa em Blackwell com as bibliotecas certas na mesma versão, fp8r já ganha velocidade em qualquer GPU Ada, Hopper ou Blackwell, e o caminho bf16 segue sendo o mais previsível para quem tem GPU de sobra e quer rodar sem complicação.
Fonte: Hugging Face Blog
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
MCP exige OAuth 2.1 para servidores remotos desde junho de 2025: veja o que muda no código
A revisão de 18 de junho de 2025 da especificação do Model Context Protocol transforma todo servidor HTTP remoto em um resource server OAuth 2.1. Quem ainda valida um token estático em variável de ambiente tem um caminho de migração concreto, e também casos em que isso não se aplica.