
Em uma aula surgiu uma discussão sobre como é feito o fine-tuning de um modelo de linguagem↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI →. O conceito parece relativamente simples: partimos de um modelo pré-treinado e realizamos treinamento adicional para adaptar seu comportamento ou suas capacidades a determinados objetivos, tarefas ou domínios.
Fine-tuning não é uma técnica única. O termo é usado de maneira ampla para diferentes formas de adaptação pós-treinamento. Podemos fazer Supervised Fine-Tuning (SFT) com pares de entrada e saída desejada, realizar treinamento adicional sobre grandes conjuntos de textos de determinado domínio, frequentemente chamado de continued pretraining ou domain-adaptive pretraining, ou utilizar métodos baseados em preferências para modificar determinados comportamentos do modelo.
Essas abordagens têm objetivos diferentes. Também é comum ouvir que fine-tuning serve para “ensinar conhecimento novo ao modelo”. Essa explicação é incompleta.
Treinamento adicional pode fazer o modelo incorporar ou reforçar informações e regularidades de determinado domínio. Mas alterar pesos não transforma um LLM em um banco de dados↳Banco de dados134 conteúdosSQL ou NoSQL: eis a questão!!Data · mar 2020Banco de dados: como organizar e dar segurança para milhões de dados de loteriasData · mai 20215 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → confiável, auditável e facilmente atualizável. Se a informação muda constantemente, gravá-la nos parâmetros pode ser justamente a arquitetura errada.
Imagine um modelo que precisa analisar interações de atendimento e produzir categoria, prioridade e justificativa segundo um padrão definido pela empresa. Podemos fornecer milhares de exemplos contendo a interação como entrada e a resposta esperada como saída.
No Supervised Fine-Tuning, o modelo processa esses exemplos e é treinado para aumentar a probabilidade das sequências de resposta desejadas condicionadas à entrada.
Em modelos autoregressivos, isso normalmente acontece por teacher forcing: durante o treinamento, o modelo recebe os tokens corretos anteriores e aprende a prever o próximo token. Uma função de perda, tipicamente baseada em cross-entropy, mede a discrepância entre a distribuição produzida pelo modelo e os tokens esperados.
O backpropagation calcula os gradientes dessa perda em relação aos parâmetros treináveis, e o otimizador utiliza esses gradientes para atualizá-los. O processo se repete em mini-batches ao longo de uma ou mais epochs.
Mas nem todo fine-tuning precisa modificar todos os parâmetros. No full fine-tuning, todos ou praticamente todos os parâmetros treináveis do modelo são atualizados. Em modelos com bilhões de parâmetros, isso pode exigir quantidade considerável de memória, computação e armazenamento.
Uma alternativa são técnicas de PEFT, Parameter-Efficient Fine-Tuning, que procuram adaptar o modelo treinando uma parcela muito menor de parâmetros.
Uma das mais conhecidas é LoRA, Low-Rank Adaptation. De forma simplificada, em vez de atualizar diretamente as grandes matrizes de pesos do modelo-base, seus pesos permanecem congelados e são introduzidas matrizes treináveis de baixo rank que representam uma atualização para módulos selecionados. Durante a inferência, essas adaptações participam da transformação e, em determinadas implementações, podem ser incorporadas aos pesos-base.
Isso reduz drasticamente a quantidade de parâmetros que precisam ser treinados e, consequentemente, a memória necessária para gradientes e estados do otimizador. Mas PEFT não significa automaticamente desempenho idêntico ao full fine-tuning em qualquer tarefa. Existe uma troca entre eficiência e capacidade de adaptação que precisa ser medida.
Há ainda uma possibilidade particularmente interessante para empresas: nem toda aplicação precisa especializar um LLM enorme. Podemos partir de um modelo menor, frequentemente chamado de SLM, Small Language Model, e especializá-lo para determinada tarefa. Não existe, entretanto, uma fronteira universal que separe SLM de LLM por um número específico de parâmetros. São termos relativos e usados de maneiras diferentes na literatura e na indústria.
Para tarefas estreitas e bem definidas, como determinadas classificações, extração estruturada de informações ou geração dentro de formatos controlados, um modelo menor especializado pode atingir a qualidade necessária com menor consumo de memória e menor latência e, dependendo do volume, hardware e modelo de implantação, menor custo.
Mas tamanho menor não significa automaticamente solução melhor. Modelos maiores podem continuar sendo mais adequados quando a aplicação exige amplitude de capacidades, conhecimento abrangente, tratamento de instruções complexas ou generalização diante de situações muito variadas. A escolha precisa ser determinada por avaliações representativas do ambiente real, não apenas pelo número de parâmetros.
Outra distinção fundamental é entre fine-tuning e RAG. Para preços, contratos, políticas, normas, catálogos ou informações corporativas que mudam continuamente, frequentemente é preferível manter essas informações fora dos pesos e recuperá-las no momento da inferência.
RAG busca conteúdo potencialmente relevante em fontes externas e o acrescenta ao contexto fornecido ao modelo. Isso permite atualizar a fonte sem retreinar o modelo e pode melhorar a fundamentação das respostas.
Mas aqui também é importante evitar uma simplificação: RAG não garante factualidade. A recuperação pode trazer documentos errados, incompletos, desatualizados ou irrelevantes, e o modelo ainda pode interpretar incorretamente o contexto ou produzir afirmações não sustentadas por ele.
RAG resolve um problema de acesso à informação, mas não elimina automaticamente o problema de confiabilidade. Fine-tuning e RAG, portanto, não são necessariamente concorrentes.
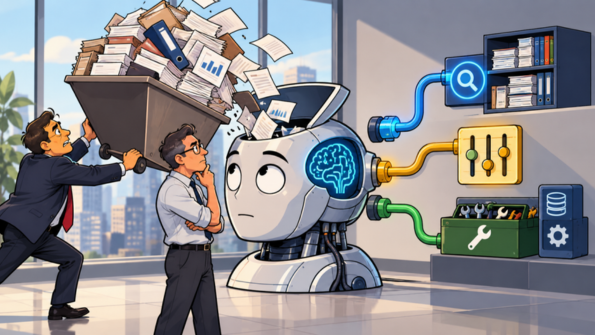
Fine-tuning pode ser utilizado para adaptar persistentemente como o modelo se comporta ou executa determinada tarefa. RAG pode fornecer informação externa e atualizável durante a inferência. Ferramentas podem permitir que o sistema consulte dados estruturados ou execute operações em sistemas externos. Uma arquitetura corporativa pode combinar os três.
Há ainda outro ponto frequentemente ignorado: fine-tuning pode melhorar algumas capacidades e degradar outras. Treinar excessivamente sobre um conjunto estreito de dados pode produzir overfitting ou interferir em capacidades previamente adquiridas. A literatura sobre adaptação de domínio e fine-tuning documenta o risco de catastrophic forgetting: melhorar o desempenho no domínio-alvo enquanto se perde desempenho em capacidades anteriores.
Por isso, todo projeto de fine-tuning deveria começar e terminar com avaliação. É necessário estabelecer um baseline, separar adequadamente dados de treinamento, validação e teste, controlar vazamento entre esses conjuntos, definir métricas relacionadas à tarefa e avaliar não apenas onde o modelo melhorou, mas também onde piorou.
E existe um aspecto ainda mais básico: qualidade dos dados. Milhares de exemplos inconsistentes, enviesados ou incorretos podem simplesmente ensinar ao modelo esses mesmos problemas. Em muitos projetos, construir e revisar um dataset representativo da distribuição real de uso é mais importante do que escolher entre LoRA e full fine-tuning.
Mais dados não significam necessariamente melhores dados. Mais epochs não significam necessariamente melhor modelo. E menor training loss não significa necessariamente melhor desempenho em produção.
Antes de discutir LoRA, rank, learning rate, número de epochs, quantização ou GPUs, é necessário definir claramente qual comportamento ou capacidade se pretende modificar e demonstrar que alterar os parâmetros é uma solução adequada para isso.
Em alguns casos, um prompt melhor resolve. Em outros, exemplos no contexto são suficientes. Para conhecimento dinâmico, RAG pode ser mais adequado. Para acessar sistemas ou dados estruturados, ferramentas podem resolver melhor o problema. Em tarefas estreitas e repetitivas, um modelo menor especializado pode ser suficiente. E existem situações em que um modelo maior continua sendo necessário.
Uma abordagem de engenharia mais disciplinada começa pela definição do problema e dos requisitos, estabelece um baseline, testa inicialmente as alternativas mais simples e mede seus resultados. Fine-tuning entra quando existe evidência de que modificar os parâmetros do modelo acrescenta valor suficiente para justificar sua complexidade, seus custos e seus riscos.
A decisão de engenharia não deve começar pelo maior modelo disponível nem pela técnica de fine-tuning mais sofisticada. Deve começar pela arquitetura mais simples capaz de atender, com qualidade, confiabilidade, latência e custo adequados, ao problema real. Essa é a diferença entre simplesmente usar modelos de IA e começar a tratá-los como componentes de uma arquitetura de engenharia.


Na era da IA, o QA não testa só software. Ele desenha confiança
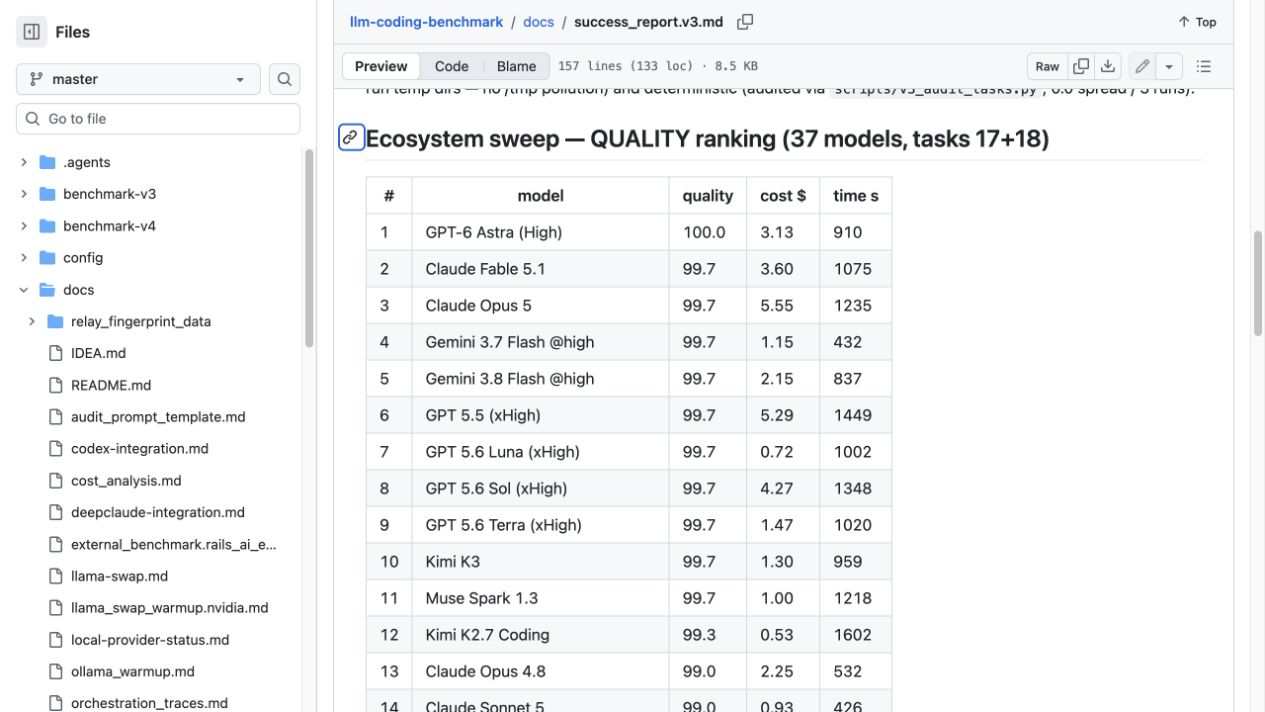

LLM Benchmark: retestando TODOS os principais LLMs (Parte 1)
Do Build à Loja: Automatizando a Publicação de Apps com Computer Use, Codex e Claude
 Iago Cavalcante
Enquanto discutimos a AGI, o risco real da IA já está operando
 Cezar Taurion
LLMs: estamos confundindo memória com aprendizado?
Cezar TaurionGraphRAG – Teoria, prática e o por que você deve aprender o quanto antes.
 Airton Lira Junior