
Recentemente participei do desenho de uma estratégia de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → para uma empresa que já havia avançado bastante no uso de IA generativa. Não estávamos começando do zero. Já existiam copilotos, assistentes internos, RAGs, automações e diferentes áreas experimentando agentes.
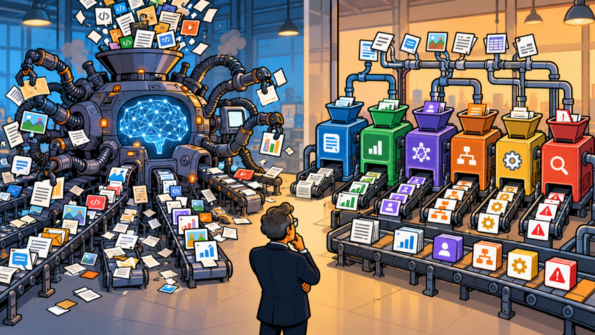
Foi justamente isso que tornou a discussão interessante. Percebi rapidamente que nosso principal problema já não era criar mais agentes. Era evitar que a facilidade de criá-los produzisse uma nova geração de silos tecnológicos.
Cada área poderia escolher seus modelos, frameworks, fontes de dados, ferramentas e integrações. Olhadas isoladamente, várias dessas decisões eram perfeitamente defensáveis. Quando colocávamos tudo no mapa, porém, aparecia outra realidade: componentes duplicados, custos difíceis de enxergar, controles diferentes e uma arquitetura que poderia ficar progressivamente mais difícil de operar.
Minha preocupação foi não responder à descentralização criando o extremo oposto. Uma grande plataforma corporativa obrigatória poderia reduzir a diversidade, mas também transformar uma tentativa de simplificação em um novo lock-in.
Acabamos seguindo outro caminho: arquitetura compartilhada, padrões comuns e liberdade controlada para as áreas.
Começamos pelos modelos. Em vez de eleger “o LLM corporativo”, criamos a ideia de um catálogo governado. Qualidade, latência, custo, segurança e características do caso de uso determinariam a escolha. Não existe razão econômica para utilizar o modelo mais sofisticado disponível quando outro, menor e mais barato, atende aos requisitos.
Ao mesmo tempo, evitamos uma simplificação que tenho visto com frequência que é tratar modelos como peças perfeitamente intercambiáveis. Não são. Trocar o modelo pode alterar comportamento, aderência a instruções, chamadas de ferramentas e desempenho. Modularidade facilita a substituição. Não elimina a necessidade de testar novamente o sistema.
Na camada seguinte, procuramos aquilo que não fazia sentido cada equipe reconstruir: acesso a ferramentas e APIs, gerenciamento de contexto, estado, memória quando realmente necessária, identidade, credenciais, observabilidade↳Observabilidade11 conteúdosObservabilidade para APIs: os desafios e benefícios dessa abordagemDev (Back & Front) · jan 2025Falhas em Observabilidade afetam os Apps e a Segurança das OrganizaçõesDev (Back & Front) · nov 2023ADK Java 1.0: O Google quer que você pare de gambiarra Python no seu backendMarketing Tech · abr 2026Ver tudo em DevSecOps →, políticas e mecanismos de controle. Isso não significava obrigar todos os agentes a ter a mesma arquitetura. Significava não reconstruir encanamento básico a cada projeto.
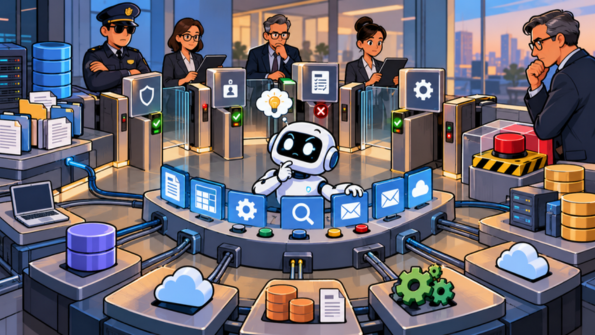
Mas a discussão que mais me interessou surgiu quando começamos a falar de autonomia. Percebi que estávamos discutindo demais o que o agente conseguia fazer e pouco sobre o que ele poderia ser autorizado a fazer. Saber fazer, poder fazer e estar autorizado a fazer são coisas diferentes.
Um agente pode ser perfeitamente capaz de recomendar um pagamento sem possuir autoridade para executá-lo. Pode preparar uma operação para aprovação humana. Em outro processo, de menor risco, pode receber permissão para executar determinadas ações dentro de limites previamente estabelecidos.
A partir daí, nossa discussão deixou de ser apenas sobre agentes e passou a incluir algo que considero ainda mais importante: engenharia de autoridade.
Quem é esse agente? Em nome de quem está agindo? Que credenciais utiliza? Quais ferramentas pode acessar? Sobre quais dados? Quais ações pode executar? Até qual valor? Em quais circunstâncias precisa parar e pedir intervenção humana?
Foi quando a visão de governança ficou muito mais concreta. Governança não pode morar apenas em políticas, documentos e comitês. Parte dela precisa virar software. Identidades, permissões, segregação de funções, limites operacionais, validações determinísticas, aprovações, registros, mecanismos de interrupção e tratamento de exceções precisam existir no momento da execução.
O mesmo vale para segurança. Se um agente lê um e-mail, documento ou página externa, aquele conteúdo não pode ganhar autoridade simplesmente porque entrou na janela de contexto. Ele pode conter instruções maliciosas ou simplesmente inadequadas.
Informação não é instrução. E instrução não é autorização. Essa separação precisa estar na arquitetura, não apenas escrita no prompt.
Também percebemos que colocar um agente em produção não encerrava o problema. Modelo, prompt, ferramentas, dados, políticas e integrações mudam. Portanto, avaliações precisam acompanhar o ciclo de vida. Versionamento, testes de regressão, monitoramento em produção e critérios objetivos para aumentar, reduzir ou retirar autonomia passaram a fazer parte do desenho.
E observabilidade deixou de significar apenas logs. Se alguma coisa desse errado, queríamos conseguir reconstruir o objetivo recebido, o contexto utilizado, o modelo envolvido, as ferramentas chamadas, a identidade usada, as políticas aplicadas, as aprovações obtidas e o resultado produzido.
Mas não queríamos terminar com uma arquitetura tecnicamente sofisticada e economicamente bonita apenas no PowerPoint. Ela precisava provar valor.
Passamos a acompanhar tempo até produção, reutilização de componentes, custo por caso, custo de inferência, qualidade, falhas, intervenções humanas, incidentes e adoção dos componentes comuns. E acrescentamos uma pergunta que considero particularmente importante: quanto custa operar o sistema quando ele falha?
Uma ferramenta pode ficar indisponível. Uma chamada pode executar uma operação e falhar antes de confirmar o resultado. Uma tentativa automática pode repetir uma transação. Uma ação pode exigir compensação ou reversão. Agentes não eliminaram os problemas clássicos dos sistemas distribuídos. Acrescentaram componentes probabilísticos a eles.
Também não decidimos construir tudo internamente. A empresa não precisa possuir cada modelo, framework ou componente. Precisa controlar aquilo que é estratégico: arquitetura, dados, identidade, políticas, autoridade, observabilidade e capacidade de substituir componentes.
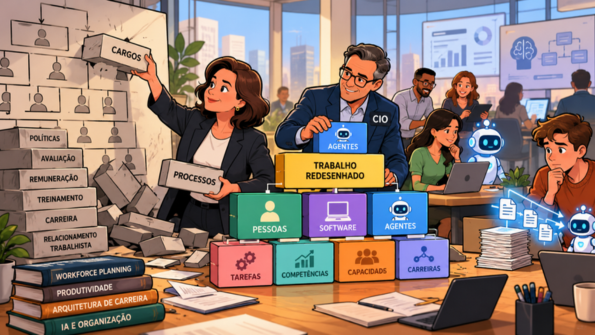
No final, percebemos que nem sequer estávamos discutindo apenas tecnologia. Estávamos redesenhando trabalho. Quando agentes entram nos processos, alguém precisa decidir o que permanece humano, o que pode ser automatizado, o que exige aprovação, quando uma pessoa precisa assumir o controle e quem continua responsável pelo resultado. Delegar uma tarefa a um agente não significa delegar accountability à máquina.
E ficou igualmente claro que nem todo problema precisava de um agente. Em vários casos, um workflow determinístico, um modelo especializado, uma automação convencional ou mesmo uma regra continuava sendo uma solução melhor.
Criar agentes está ficando fácil. Operar dezenas ou centenas deles de forma econômica, observável, segura e controlável é outra história.
O objetivo que definimos acabou sendo bastante simples: fazer novos casos de IA chegarem à produção mais rapidamente e com menor custo, sem permitir que risco, complexidade e dependência tecnológica crescessem na mesma velocidade.
Usar IA é relativamente fácil. Construir uma empresa capaz de operar IA em escala exige arquitetura, economia, engenharia e governança trabalhando juntas. Foi isso que, na prática, acabamos desenhando.


Quando o agente de IA vira funcionário: um problema de identidade

NET – Integração de IA no Backend com Microsoft.Extensions.AI
Seu agente não é tão autônomo quanto parece
 Cezar Taurion
O que é o Jev, e o que eu aprendi construindo uma cidade inteira com ele
 Fabricio Carraro
O chatbot começou a errar. O problema estava na empresa.
Cezar Taurion.NET – Orquestração Híbrida de IA com MAF, Ollama e OpenAI
 José Carlos Macoratti