
Acompanhei de perto um projeto que me mostrou claramente, na prática, por que uma boa demo de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → está muito longe de ser um sistema pronto para atender clientes reais.
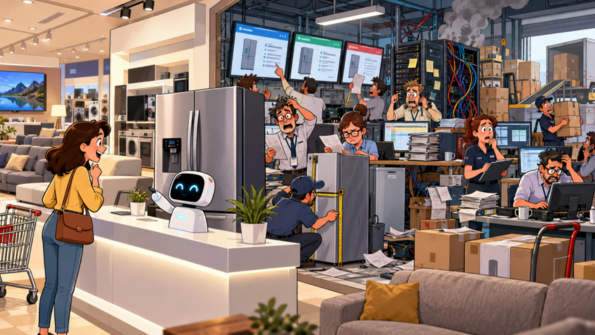
Foi em uma empresa de varejo de móveis e eletrodomésticos. O objetivo parecia simples: criar um chatbot capaz de responder dúvidas sobre produtos e ajudar o consumidor a escolher uma geladeira, TV, sofá ou máquina de lavar.
Nos testes controlados, funcionava muito bem. O problema começou quando clientes reais passaram a conversar com ele. E foi justamente o uso real que revelou problemas que os testes tradicionais não haviam capturado.
O primeiro choque veio dos dados. A empresa começou a perceber reclamações de clientes sobre características dos produtos. Ao reconstruir as conversas e comparar as respostas com as fontes corporativas, descobriu-se situações curiosas. O bot recomendava um refrigerador dizendo que tinha 480 litros, enquanto outra base registrava 462. Em alguns casos confundia dimensões da embalagem com dimensões do produto. Em outros, encontrava atributos diferentes no ERP, no catálogo digital e na descrição fornecida pelo fabricante.
O LLM não havia criado essas inconsistências. Ele simplesmente tornou público e conversacional uma desorganização de dados que já existia.
A primeira correção, portanto, não aconteceu no modelo. Tiveram de definir fontes autoritativas para cada atributo, revisar taxonomias, identificar campos ausentes e conflitantes e estabelecer regras sobre quais informações poderiam ser utilizadas nas respostas. Quando não existisse informação suficientemente confiável, o bot deveria assumir a incerteza, não completá-la com uma resposta plausível.
Depois apareceram os problemas de integração. O cliente perguntava por uma máquina de lavar adequada à sua necessidade e disponível para entrega em sua cidade. O bot encontrava um excelente produto no catálogo, mas estoque, logística e prazo estavam em sistemas diferentes. Algumas recomendações eram tecnicamente boas e comercialmente inúteis: o produto não estava disponível naquela região ou o prazo apresentado já havia mudado.
Descobriu-se isso comparando recomendações registradas nos logs com pedidos, estoque e simulações reais de entrega.
Foi necessário separar duas coisas que inicialmente pareciam uma só: recomendar um produto e afirmar sua disponibilidade. A primeira podia utilizar catálogo e características. A segunda exigia consulta em tempo real aos sistemas transacionais. Quando essa consulta falhava, o agente não poderia simplesmente continuar como se tivesse obtido a informação.
Então vieram as perguntas que nenhum roteiro de homologação havia imaginado.
“Esse sofá aguenta meus três filhos pulando nele todos os dias?”
“Essa geladeira cabe no elevador do meu prédio?”
“Posso colocar essa TV na varanda onde bate sol à tarde?”
Foi aí que se percebeu outro problema nos testes. Havia sido testado principalmente aquilo que se esperava que os clientes perguntassem. Os clientes reais não tinham participado da elaboração do nosso roteiro.
Passaram então a analisar conversas reais, agrupar perguntas que produziam respostas problemáticas e criar conjuntos de avaliação com casos ambíguos, incompletos, adversariais e fora do escopo. As falhas encontradas em produção passaram a alimentar continuamente os evals.
Também definiu-se classes de resposta. Para determinados atributos objetivos, o bot só poderia responder quando encontrasse evidência em fonte autorizada. Para situações subjetivas ou sem informação suficiente, deveria explicitar a limitação. Para temas com maior risco ou ambiguidade, transferiria a conversa para uma pessoa.
Isso parece trivial. Não é. LLMs são muito bons em produzir respostas plausíveis mesmo quando a informação disponível é insuficiente. Em atendimento ao consumidor, uma resposta educada, convincente e errada pode ser mais perigosa que um simples “não sei”.
Também surgiram comportamentos inesperados quando clientes insistiam, reformulavam perguntas, contradiziam o bot ou tentavam levá-lo para assuntos completamente fora do contexto. Descobriram que guardrails baseados predominantemente em prompts eram insuficientes.
Foram necessários controles adicionais de escopo, validação das respostas em situações específicas, limites para determinadas afirmações e regras externas ao modelo. O princípio passou a ser simples: nem tudo que o modelo consegue responder significa que o sistema deveria permitir que ele respondesse.
E apareceu outro problema que não havia sido pensado: latência. Ao instrumentar o fluxo de ponta a ponta, se percebeu que uma pergunta aparentemente simples podia provocar várias operações: classificação da intenção, recuperação de contexto, busca de produto, consulta a APIs, validação e geração da resposta.
O cliente não enxergava nada disso. Apenas esperava. A observabilidade↳Observabilidade11 conteúdosObservabilidade para APIs: os desafios e benefícios dessa abordagemDev (Back & Front) · jan 2025Falhas em Observabilidade afetam os Apps e a Segurança das OrganizaçõesDev (Back & Front) · nov 2023ADK Java 1.0: O Google quer que você pare de gambiarra Python no seu backendMarketing Tech · abr 2026Ver tudo em DevSecOps → mostrou onde o tempo estava sendo consumido. Algumas consultas podiam ocorrer em paralelo. Outras eram redundantes. Determinadas perguntas não precisavam do modelo mais sofisticado. Algumas informações poderiam utilizar cache com critérios adequados de validade. Retries precisavam ser limitados.
Em certos pontos, a melhor otimização foi simplesmente eliminar uma chamada ao LLM. A combinação de respostas incorretas, inconsistências, problemas de integração e latências excessivas levou à decisão de suspender temporariamente o atendimento automatizado e voltar à engenharia.
O que mudou. A homologação deixou de avaliar apenas se “o chatbot responde bem”. Passou a medir qualidade factual, cobertura das fontes, disponibilidade das integrações, latência, falhas de ferramentas, comportamento fora de escopo, transferência para humanos e capacidade de recuperação quando alguma dependência não funcionava.
E criou-se algo ainda mais importante: uma taxonomia de falhas. Erro do modelo, erro de recuperação, dado inconsistente, integração indisponível, regra de negócio inadequada, informação insuficiente e falha de orquestração deixaram de ser colocados na mesma caixa chamada genericamente de “erro da IA”.
Isso mudou a discussão. Colocar um LLM diante do cliente é relativamente fácil. Colocar a empresa diante do cliente através de um LLM é muito mais difícil. O chatbot acaba transformando em linguagem natural tudo aquilo que existe atrás dele: dados, integrações, regras, processos, sistemas legados e decisões de governança.
E esse foi o maior aprendizado daquele projeto. Quando o chatbot começou a errar, inicialmente parecia que havia um problema de IA. Depois de investigar, descobriu-se algo muito mais interessante: a IA estava tornando visíveis, em escala e diante do cliente, problemas que a empresa já tinha havia muito tempo.


Dicas do Voice Flow


IA Conversacional: o que esperar dos chatbots e assistentes virtuais em 2025?
Criando um Bot IA de atendimento com WhatsApp em 6 etapas
 Douglas Falsarella
Tecnologia da Informação: Três temas que continuarão no radar dos líderes de TI
 Jane Greco
Como a combinação entre Chatbot, BPMs e RPA pode acelerar a transformação digital
 Fernando Baldin
Criando um ChatBot em menos de 5 minutos? Sim, é possível!
 Gláucia Lemos