A ideia que libertou os dados: como nasceu uma das maiores revoluções da computação.

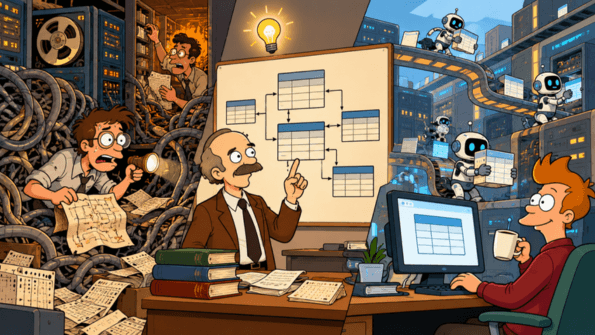
Trabalhei muito com bancos de dados↳Banco de dados134 conteúdosSQL ou NoSQL: eis a questão!!Data · mar 2020Banco de dados: como organizar e dar segurança para milhões de dados de loteriasData · mai 20215 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → relacionais e usei muito SQL. Mas, vejo que muita gente desconhece sua história e evolução. Resolvi escrever uma série de 3 artigos sobre o tema, para serem publicados aqui no Linkedin. Esse é o primeiro artigo da série A Revolução Silenciosa dos Dados, das origens da computação corporativa ao nascimento do SQL.
Em junho de 1970, um pesquisador da IBM publicou um artigo de onze páginas em uma revista científica. Seu título, “A Relational Model of Data for Large Shared Data Banks”, dificilmente despertaria interesse fora de um pequeno círculo de especialistas. O artigo não anunciava um novo computador, não apresentava uma linguagem de programação comercial e tampouco prometia revolucionar os negócios. Propunha algo aparentemente mais modesto: uma maneira diferente de organizar e acessar informações.
Mas a ideia de Edgar F. Codd continha uma mudança profunda. Em vez de obrigar os programas a conhecer os caminhos físicos pelos quais os dados eram armazenados, seria possível trabalhar com uma representação lógica baseada em relações matemáticas.
O que parecia uma discussão acadêmica acabaria influenciando profundamente a indústria de software, a arquitetura dos sistemas corporativos e a maneira como organizações de todos os setores utilizam informações.
Mais de cinquenta anos depois, quando falamos de inteligência artificial↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →, computação em nuvem↳Cloud30 conteúdosGerenciamento de infraestrutura multicloud com Kubernetes proporciona otimização e economiaDevSecOps · set 2021Vivo assina contrato para aquisição da IPNET e cresce em cloud computingDevSecOps · ago 20245 tendências da computação em nuvem para as empresasDevSecOps · abr 2022Ver tudo em DevSecOps → e bancos de dados distribuídos, continuamos utilizando princípios e linguagens cuja trajetória começou naquela época.
Esta é a história de como uma ideia matemática se transformou em uma das infraestruturas mais importantes do mundo digital.
Uma observação importante: o modelo relacional, os sistemas gerenciadores de bancos de dados relacionais e a linguagem SQL são coisas distintas. Essa diferenciação será preservada ao longo dos três textos.
Há algumas histórias da computação que considero particularmente fascinantes. Não necessariamente porque envolvam máquinas extraordinárias, grandes lançamentos ou personagens que se tornaram celebridades, mas porque mostram como uma ideia aparentemente abstrata pode modificar profundamente uma indústria inteira.
A história do modelo relacional de dados é uma delas. Mais de meio século depois do artigo de Codd, aquela ideia continua presente em sistemas bancários, plataformas de comércio eletrônico↳E-commerce21 conteúdosECBR Club: novo espaço para devs se conectarem ao ecossistema de e-commerceDev (Back & Front) · mai 2025TOTVS anuncia joint venture com VTEXMarketing Tech · mai 2019Jovens da Brasilândia recebem formação gratuita em tecnologiaGestão Dev & TI · jul 2025Ver tudo em Marketing Tech →, aplicações empresariais, sistemas de reservas, operações logísticas e inúmeras outras atividades.
O artigo tornou-se um dos trabalhos mais influentes da história da computação. Em outubro de 2026, a página da ACM registrava aproximadamente 5.900 citações, indicador bibliométrico que naturalmente muda com o tempo. Mas o aspecto mais interessante dessa história não está no número de citações. Está no problema que Codd procurava resolver.
Para compreendê-lo, precisamos voltar aos anos 1950 e 1960, quando a computação corporativa começava a se expandir e administrar dados era uma atividade muito diferente daquilo que conhecemos hoje.
Naquela época, grande parte das informações empresariais era processada por sistemas que utilizavam arquivos organizados de acordo com necessidades bastante específicas. Cartões perfurados, fitas magnéticas e, posteriormente, discos eram utilizados para armazenar registros de clientes, funcionários, produtos, transações e operações.
Os programas precisavam conhecer detalhadamente a organização desses arquivos. Em muitas aplicações, a maneira de encontrar determinada informação estava intimamente ligada à forma como ela havia sido armazenada.
Isso criava uma grande dependência. Se a organização física dos dados mudasse, os programas que os utilizavam frequentemente precisariam ser modificados. Se uma empresa desejasse realizar uma consulta não prevista originalmente, era necessário desenvolver um novo programa ou alterar significativamente um existente.
Imagine um banco que mantivesse registros de clientes, contas e movimentações financeiras. Um sistema poderia ter sido desenvolvido para produzir extratos. Outro, para calcular saldos. Um terceiro, para identificar determinadas operações. Mas uma nova necessidade gerencial, como relacionar clientes de diferentes agências a determinados produtos, poderia exigir um trabalho considerável de programação e reorganização de informações.
O problema não era simplesmente a quantidade de dados. Era a dificuldade de utilizar os mesmos dados para responder a perguntas diferentes. E esse desafio crescia à medida que as empresas informatizavam mais atividades.
A computação deixava de ser utilizada apenas para executar cálculos e processamentos periódicos. Passava a sustentar operações comerciais, financeiras e administrativas cada vez mais complexas.
Os sistemas de gerenciamento de bancos de dados surgiram justamente para enfrentar parte dessas dificuldades. Entre as soluções mais importantes estavam os modelos hierárquicos e em rede. Um exemplo emblemático foi o IMS, desenvolvido pela IBM no contexto do programa espacial Apollo.
A documentação histórica registra que, em 1965, a IBM estabeleceu uma parceria com a North American Aviation, posteriormente associada à Rockwell, para desenvolver um sistema destinado a administrar informações complexas sobre componentes utilizados na construção das espaçonaves. Em 1966, uma equipe composta por doze profissionais da IBM, dez da Rockwell e três da Caterpillar iniciou o desenvolvimento do sistema que daria origem ao IMS.
A primeira versão foi entregue em 1967. A instalação ocorreu em 1968, e o sistema tornou-se disponível comercialmente em 1969. É interessante observar como uma necessidade concreta de engenharia aeroespacial contribuiu para o desenvolvimento de tecnologias que depois seriam utilizadas em inúmeras organizações.
O IMS utilizava uma organização hierárquica dos dados, adequada a muitas das necessidades daquele contexto. Registros podiam ser organizados em estruturas semelhantes a árvores, com relações entre elementos superiores e subordinados.
Outros sistemas adotavam modelos em rede, nos quais os relacionamentos eram representados por estruturas de navegação mais flexíveis. Essas soluções foram fundamentais para a evolução da computação empresarial.
E aqui considero importante evitar uma simplificação histórica muito comum. Não devemos olhar para os sistemas hierárquicos e em rede como tecnologias primitivas que simplesmente aguardavam a chegada de uma solução superior. Eles foram desenvolvidos para problemas concretos, em condições nas quais memória, armazenamento e capacidade de processamento eram recursos extremamente caros.
Em determinadas cargas de trabalho, estruturas de acesso previamente definidas ofereciam vantagens importantes de desempenho. O problema aparecia quando as necessidades de informação mudavam.
Em muitos desses sistemas, recuperar dados significava percorrer caminhos de navegação definidos pela estrutura existente. O programador precisava conhecer esses caminhos. A maneira como a informação era organizada influenciava diretamente a maneira como os programas eram construídos.
Foi nesse ambiente que Codd começou a questionar uma premissa fundamental. Por que os usuários e as aplicações precisariam conhecer tantos detalhes sobre a organização interna dos dados? Por que uma mudança no armazenamento físico deveria obrigar a modificar programas que, conceitualmente, continuavam precisando das mesmas informações? E por que a recuperação dos dados deveria depender de caminhos previamente estabelecidos?
A resposta que Codd propôs não nasceu de uma nova tecnologia de armazenamento. Nasceu da matemática. Codd havia estudado matemática e trabalhava no laboratório de pesquisa da IBM em San Jose, na Califórnia.
Sua proposta utilizava o conceito matemático de relação. Em vez de representar as informações principalmente por caminhos de navegação, seria possível organizá-las logicamente em relações compostas por atributos e tuplas.
Em uma explicação simplificada, podemos imaginar uma relação contendo clientes, outra contendo contas e uma terceira contendo movimentações financeiras. Cada uma descreve determinado conjunto de fatos. Os relacionamentos entre essas informações podem ser estabelecidos por valores e operações sobre os dados, sem exigir que todas as ligações estejam codificadas como caminhos físicos de navegação.
A consequência é profunda. O usuário pode formular uma pergunta sobre as informações sem precisar determinar exatamente como o sistema deverá percorrer os dispositivos de armazenamento para respondê-la.
A ideia central era separar a representação lógica dos dados dos detalhes de sua organização física. O próprio resumo do artigo de 1970 enfatizava a necessidade de proteger os usuários do conhecimento sobre a representação interna das informações.
Essa preocupação tornou-se uma das contribuições mais duradouras do modelo relacional. À primeira vista, parece uma questão exclusivamente técnica. Mas seu impacto econômico potencial era enorme.
Se uma organização consegue modificar estruturas físicas, índices e mecanismos de acesso sem necessariamente alterar todas as aplicações, reduz parte do custo de manutenção e evolução de seus sistemas.
Se novas consultas podem ser formuladas sem definir previamente todos os caminhos de navegação, a informação torna-se mais flexível. Se diferentes aplicações conseguem trabalhar sobre uma representação lógica compartilhada, surgem novas possibilidades de integração.
A revolução não estava em colocar dados em tabelas. Estava em reduzir a dependência entre aquilo que queríamos saber e a maneira como os dados eram fisicamente organizados.
O modelo relacional não é simplesmente um conjunto de planilhas. Uma relação matemática possui propriedades específicas. No modelo relacional clássico, as tuplas formam um conjunto, sem duplicatas, e a ordem dos registros não possui significado intrínseco.
Já os sistemas SQL comerciais incorporaram decisões pragmáticas que não reproduzem integralmente essas propriedades. Por exemplo, consultas SQL podem produzir linhas duplicadas, e a linguagem utiliza valores nulos e uma lógica que exige cuidados específicos.
Portanto, modelo relacional e SQL não são sinônimos. O primeiro é uma proposta teórica para representar e manipular dados. O segundo é uma linguagem que surgiu posteriormente para trabalhar com sistemas inspirados nessa proposta.
Essa diferença é importante porque mostra que a história da tecnologia não é simplesmente a transformação direta de uma teoria em produto. Entre a ideia original e sua implementação comercial existem decisões, compromissos, limitações e adaptações.
E o modelo relacional enfrentou um desafio particularmente difícil. Era preciso demonstrar que funcionaria com desempenho adequado.
Em 1970, os computadores tinham capacidades muito inferiores às atuais. A ideia de permitir que um usuário descrevesse o resultado desejado, deixando para o sistema a responsabilidade de descobrir como obtê-lo, parecia elegante. Mas havia uma objeção evidente. Como garantir que o computador escolheria um caminho eficiente?
Em sistemas navegacionais, o programador frequentemente definia explicitamente a sequência de acesso aos registros. No modelo relacional, parte dessa responsabilidade passaria para o próprio gerenciador de banco de dados.
Isso exigia mecanismos sofisticados de planejamento e otimização. Em outras palavras, a abstração proposta por Codd precisava ser sustentada por uma engenharia capaz de esconder a complexidade sem comprometer excessivamente o desempenho.
A IBM iniciou, em 1973, o projeto System R justamente para investigar essa viabilidade. O objetivo era demonstrar que seria possível construir um sistema relacional robusto, capaz de operar em condições próximas das exigidas por aplicações reais.
Participaram desse esforço pesquisadores que se tornariam personagens centrais da história dos bancos de dados, entre eles Donald Chamberlin, Raymond Boyce, Patricia Selinger e Raymond Lorie. O System R foi muito mais do que um experimento destinado a comprovar a ideia de Codd. Tornou-se um ambiente no qual diferentes problemas fundamentais dos bancos relacionais puderam ser estudados.
Uma das contribuições mais importantes foi a otimização de consultas baseada em custos. Patricia Selinger e seus colaboradores publicaram, em 1979, o artigo “Access Path Selection in a Relational Database Management System”. O trabalho descrevia como o System R selecionava caminhos de acesso para consultas simples e complexas.
Em vez de exigir que o usuário determinasse todos os passos de execução, o sistema avaliava alternativas utilizando estimativas de custo. Essas estimativas consideravam aspectos como métodos de acesso, índices e operações necessárias para combinar informações.
O artigo foi publicado em maio de 1979 e tornou-se uma referência fundamental para a evolução dos otimizadores de bancos de dados. Essa inovação merece destaque porque representa uma mudança na distribuição do trabalho entre pessoas e máquinas. O usuário descreve o que deseja. O sistema decide como executar a operação, dentro das alternativas disponíveis.
Isso não significa que o sistema sempre encontre o plano ideal. Estimativas podem estar erradas. Estatísticas podem estar desatualizadas. Diferentes estratégias podem apresentar resultados muito distintos. Mas a responsabilidade de selecionar caminhos eficientes passa, em grande parte, a ser tratada pelo próprio banco de dados. É uma forma de automação intelectual que antecede em décadas as discussões atuais sobre sistemas capazes de executar tarefas complexas.
Hoje, quando discutimos agentes de IA, frequentemente apresentamos como novidade a ideia de expressar um objetivo e permitir que um sistema determine os passos necessários para alcançá-lo. Mas, o problema é muito mais antigo. A computação vem explorando diferentes formas de separar a descrição de um objetivo dos mecanismos de execução há décadas.
O SQL é um dos exemplos mais bem-sucedidos dessa abordagem. Mas ainda faltava criar uma linguagem que permitisse expressar consultas de maneira relativamente acessível.
Foi nesse contexto que Donald Chamberlin e Raymond Boyce desenvolveram o SEQUEL, abreviação de Structured English Query Language. Em 1974, os dois publicaram o artigo “SEQUEL: A Structured English Query Language”, apresentado em um encontro da ACM sobre descrição, acesso e controle de dados.
A proposta era oferecer uma linguagem de alto nível para manipular informações em um banco de dados relacional. A linguagem seria posteriormente conhecida como SQL. O detalhe importante é que ela não exigia que o usuário descrevesse todos os caminhos físicos de acesso aos dados.
Uma consulta poderia expressar quais informações deveriam ser selecionadas, quais condições precisariam ser satisfeitas e como diferentes conjuntos de dados deveriam ser relacionados. O sistema ficaria responsável por transformar essa solicitação em operações executáveis. Isso alterava profundamente a relação entre aplicações e bancos de dados.
Até então, grande parte da programação de acesso às informações dependia de procedimentos que descreviam como navegar pelas estruturas existentes. O SQL ajudou a popularizar uma abordagem declarativa. Em vez de detalhar todos os passos, descrevemos o resultado desejado.
Essa mudança contribuiu para tornar o acesso aos dados mais flexível e para criar uma linguagem comum que atravessaria gerações de computadores. É importante lembrar que o SQL não surgiu como a única linguagem possível para bancos relacionais. Codd havia proposto uma linguagem denominada Alpha, e outros projetos desenvolveram alternativas.
Na Universidade da Califórnia em Berkeley, por exemplo, Michael Stonebraker, Eugene Wong e colaboradores trabalhavam no projeto Ingres. Um relatório técnico de 1974 já descrevia o sistema relacional desenvolvido naquele ambiente acadêmico. O projeto utilizaria a linguagem QUEL, diferente do SQL. Portanto, a vitória posterior do SQL não era inevitável. Existiam diferentes grupos de pesquisa, propostas de linguagem e caminhos de implementação.
O que conhecemos hoje como padrão dominante resultou de uma combinação de mérito técnico, desenvolvimento de produtos, decisões comerciais, padronização e efeitos de rede.
Essa é uma das lições mais interessantes da história da computação. Uma ideia pode ser teoricamente importante sem se transformar em padrão de mercado. Uma implementação pode ser tecnicamente sofisticada sem conquistar adoção ampla.
E uma linguagem pode tornar-se dominante não apenas por suas propriedades formais, mas também porque empresas, profissionais, ferramentas e instituições passam a utilizá-la.
No caso do SQL, essa convergência começaria a ganhar força no final dos anos 1970. Mas antes de chegar ao mercado, os pesquisadores precisavam resolver outros problemas. Um banco de dados corporativo não pode apenas responder consultas. Ele precisa administrar operações simultâneas, preservar informações consistentes e recuperar-se de falhas.
Imagine uma transferência bancária. Uma operação pode envolver a redução do saldo de uma conta e o aumento do saldo de outra. Não basta executar duas alterações independentes. É necessário garantir que a transação seja tratada adequadamente, evitando estados intermediários inconsistentes caso ocorra uma falha.
Também é preciso lidar com milhares de operações concorrentes, nas quais diferentes usuários consultam e modificam informações. Esses desafios levaram ao desenvolvimento e aperfeiçoamento de mecanismos de transação, controle de concorrência, recuperação e integridade.
É importante não atribuir todas essas inovações ao modelo relacional. Muitas ideias relacionadas ao processamento transacional surgiram em diferentes linhas de pesquisa e em sistemas anteriores.
O que aconteceu foi uma integração progressiva dessas capacidades aos bancos relacionais comerciais. A combinação entre modelo lógico, linguagem declarativa, otimização e mecanismos transacionais ajudou a transformar uma proposta matemática em uma infraestrutura empresarial.
E isso não aconteceu sem resistência. A IBM já possuía investimentos importantes em tecnologias estabelecidas, como o IMS. Grandes organizações haviam construído aplicações sobre arquiteturas existentes. Havia profissionais especializados, procedimentos operacionais, contratos, ferramentas e investimentos que não poderiam simplesmente ser abandonados. O modelo relacional precisava demonstrar não apenas que funcionava, mas que oferecia vantagens suficientes para justificar sua adoção.
Essa situação se repete continuamente na história da tecnologia. Uma inovação não entra em um ambiente vazio. Ela encontra sistemas funcionando, processos consolidados, investimentos realizados e pessoas cuja experiência foi construída sobre tecnologias anteriores.
Por isso, mesmo quando uma nova abordagem apresenta vantagens importantes, sua adoção pode levar muitos anos. A história do modelo relacional é um excelente exemplo dessa dinâmica. Codd publicou seu artigo em 1970. O System R começou em 1973. O SEQUEL foi apresentado em 1974. Os avanços fundamentais de otimização foram documentados ao longo da década.
E somente no final dos anos 1970 os bancos relacionais baseados em SQL começaram a alcançar o mercado comercial. Quase uma década separou a publicação original de Codd da chegada de uma implementação comercial de SQL.
Ao final daquela década, os elementos fundamentais da revolução estavam presentes. Havia uma teoria capaz de separar a representação lógica dos dados de sua organização física. Havia implementações experimentais que demonstravam a viabilidade da abordagem. Havia linguagens de consulta que permitiam expressar necessidades de informação sem detalhar os caminhos de acesso. E havia mecanismos cada vez mais sofisticados para executar essas consultas com desempenho adequado.
Faltava conquistar as empresas. Essa seria a próxima etapa. O que considero mais impressionante nessa história é a durabilidade da ideia original. Codd não estava tentando criar uma linguagem para a internet, que ainda não existia na forma que conhecemos. Não estava pensando em plataformas de comércio eletrônico, aplicações móveis ou inteligência artificial generativa.
Seu problema era muito mais concreto. Como permitir que grandes bancos de dados fossem utilizados sem obrigar os usuários a conhecer sua organização interna?
Mas a solução proposta criou uma abstração que sobreviveria a mudanças profundas de hardware, software e arquitetura. As tecnologias que transformam uma indústria nem sempre são aquelas que introduzem mais funcionalidades. Muitas vezes são aquelas que eliminam dependências que antes pareciam inevitáveis.
O modelo relacional fez exatamente isso. Separou conceitos que estavam excessivamente acoplados. Permitiu que a representação dos dados fosse tratada em um nível diferente dos mecanismos físicos de armazenamento. E abriu caminho para uma linguagem que se tornaria uma das mais duradouras da computação.
No próximo artigo, veremos como uma ideia nascida na pesquisa enfrentou disputas comerciais, conquistou os grandes sistemas corporativos e acabou se tornando uma linguagem praticamente universal para trabalhar com dados estruturados.

Aplicações Java inteligentes usando Spring AI e Gemini

O banco de dados está no Brasil. Você sabe para onde sua IA envia os dados?

.NET – Criando Agentes com MAF e Ollama
Dica Rápida – TestContainers
 William Santos
.NET – Modernizando sistemas Legados com Spec-Driven Development
 José Carlos Macoratti
A importância de sua API suportar um ID de rastreamento
 Cesar Gimenes
.NET 11 e C# 15: Recursos e Otimizações no EF Core e LINQ
José Carlos Macoratti