
Uma pergunta que aparece com frequência quando explico como funcionam os grandes modelos de linguagem↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI → é aparentemente simples. Se alguns modelos são grandes demais para caber na memória de uma única GPU, como conseguimos colocá-los em produção e atender muitos usuários simultaneamente com latência aceitável?
A resposta começa por abandonar a imagem de uma GPU gigantesca executando sozinha todo o modelo. Na prática, a inferência de LLMs em grande escala é também um sofisticado problema de sistemas distribuídos. Diferentes formas de paralelismo são combinadas com técnicas de gerenciamento de memória, quantização, KV cache, processamento dinâmico de requisições e orquestração da infraestrutura.
Existe uma distinção importante logo no início. Um modelo pode ter centenas de bilhões ou até mais de um trilhão de parâmetros totais, mas isso não significa necessariamente que todos participem da computação de cada token. Em arquiteturas Mixture of Experts, MoE, apenas um subconjunto dos especialistas é normalmente ativado para cada token. Isso reduz a computação ativa em relação ao número total de parâmetros, embora os pesos dos especialistas ainda precisem estar distribuídos pela infraestrutura.
O primeiro desafio é a memória. Quando o modelo cabe em uma GPU ou em um grupo de GPUs, mas precisamos atender mais requisições, podemos criar múltiplas réplicas e distribuir a carga entre elas. Conceitualmente, isso se aproxima do paralelismo de dados, embora, em inferência, seja mais preciso falar em replicação do modelo para aumentar capacidade e concorrência.
Quando o modelo não cabe em uma única GPU, precisamos particioná-lo. Uma das técnicas é o Tensor Parallelism. Grandes operações matriciais de uma mesma camada são divididas entre várias GPUs. Cada dispositivo executa parte do cálculo e os resultados intermediários precisam ser sincronizados.
Isso cria uma consequência importante. O desempenho deixa de depender apenas da capacidade computacional das GPUs. A largura de banda e a latência da comunicação entre elas passam a ser parte do desempenho do próprio sistema. Por isso, interconexões de alta velocidade são tão importantes nessas arquiteturas.
Outra possibilidade é o Pipeline Parallelism. Diferentes GPUs ou grupos de GPUs ficam responsáveis por conjuntos diferentes de camadas, e as ativações percorrem esses estágios durante a execução. A analogia com uma linha de montagem ajuda, mas é imperfeita. Pipelines podem introduzir períodos de subutilização, os chamados pipeline bubbles. Técnicas de escalonamento e processamento de múltiplas requisições ou microbatches são utilizadas para melhorar a utilização dos recursos.
Nos modelos MoE aparece ainda o Expert Parallelism. Os especialistas podem estar distribuídos entre GPUs ou nós diferentes. O mecanismo de roteamento determina quais especialistas processarão as representações associadas a cada token.
A vantagem é não precisar ativar todos os parâmetros para cada token. O preço aparece na comunicação, no roteamento e no balanceamento de carga. Se determinados especialistas forem selecionados com frequência muito maior que outros, eles podem se transformar em gargalos.
Mas distribuir os pesos resolve apenas parte do problema. Existe outro grande consumidor de memória durante a inferência, o KV cache. Durante o processamento da sequência, as chaves e valores calculados pelas camadas de atenção para tokens anteriores podem ser armazenados. Assim, durante a geração autoregressiva, o sistema evita recalcular repetidamente essas representações para todo o prefixo.
Quanto maiores o contexto e o número de sequências concorrentes, maior pode se tornar a pressão do KV cache sobre a memória. A magnitude exata depende da arquitetura do modelo, da precisão utilizada e de características como o tipo de atenção.
Por isso, infraestruturas modernas utilizam técnicas de gerenciamento e paginação do KV cache, além de continuous batching. Requisições podem entrar e sair dinamicamente dos lotes de processamento, evitando que toda a GPU fique condicionada à requisição mais longa de um lote estático.
Há ainda uma diferença fundamental entre duas fases da inferência. No prefill, o modelo processa o prompt e constrói o estado inicial necessário para a geração. Como vários tokens do prompt podem ser processados em paralelo, essa fase frequentemente apresenta maior intensidade computacional.
Depois vem o decode. A geração torna-se autoregressiva e cada novo token depende dos anteriores. Nessa fase, em muitos regimes de operação, movimentação de dados e largura de banda de memória passam a ter peso dominante.
Essa distinção também aparece para o usuário. O prefill influencia fortemente o tempo até o primeiro token. O decode influencia a velocidade com que os tokens seguintes aparecem. Otimizar apenas o número total de tokens processados por segundo não garante, portanto, uma boa experiência para cada usuário.
Em infraestruturas suficientemente grandes, as diferenças entre essas duas fases permitem outra estratégia, a desagregação de prefill e decode.
Grupos distintos de GPUs podem ser especializados em cada fase, transferindo entre eles o estado necessário para continuar a geração. Isso permite otimizar recursos com características diferentes para cargas computacionais diferentes.
Mas não existe almoço grátis. Transferir o KV cache e outros estados também consome rede, largura de banda e tempo. A vantagem da desagregação depende do modelo, hardware, comprimento dos prompts, quantidade de tokens gerados, concorrência e infraestrutura de comunicação. Em determinadas situações, manter prefill e decode juntos pode ser mais eficiente.
Outro componente importante é a quantização. Pesos podem ser representados com precisões numéricas menores, reduzindo memória e movimentação de dados e, dependendo do hardware e da implementação, aumentando a capacidade de processamento. Algumas arquiteturas também utilizam menor precisão para ativações ou KV cache.
Mas quantização não é simplesmente compressão gratuita. Existe uma relação entre formato numérico, hardware, velocidade, consumo de memória e preservação da qualidade que precisa ser avaliada para cada modelo e aplicação.
Na prática, portanto, não existe uma técnica isolada que torne possível executar modelos gigantescos. Uma infraestrutura pode combinar Tensor Parallelism, Pipeline Parallelism, Expert Parallelism, replicação, quantização, gerenciamento eficiente do KV cache e continuous batching. Em determinadas escalas, prefill e decode também podem ser executados por recursos distintos.
Acima disso existe uma camada de execução e orquestração da inferência responsável por distribuir requisições, administrar filas, controlar admissão, balancear carga, escolher réplicas, gerenciar caches, lidar com falhas e buscar compromissos adequados entre latência, capacidade e custo.
Não existe apenas uma métrica de desempenho. Maximizar throughput pode prejudicar latência. Reduzir o tempo até o primeiro token pode exigir mais capacidade ociosa. Contextos maiores pressionam memória. Mais concorrência pode aumentar eficiência da GPU, mas também aumentar espera em filas.
Inferência em escala é um problema de compromissos. Para quem utiliza o sistema, o LLM aparece como uma única entidade lógica. Fisicamente, sua execução pode envolver muitas GPUs, diferentes servidores, redes de altíssima velocidade e até grupos de recursos especializados em partes diferentes da inferência.
Quando digitamos um prompt e vemos tokens surgindo quase imediatamente na tela, parece que estamos conversando com um único modelo executado em algum computador gigantesco.
Por trás dessa simplicidade existe uma sofisticada arquitetura distribuída. Em escala, executar um LLM em produção deixa de ser apenas um problema de inteligência artificial. Torna-se também um problema de memória, computação, comunicação, redes, escalonamento, filas, tolerância a falhas, latência e economia de infraestrutura.
E é justamente essa engenharia, quase invisível para quem utiliza o modelo, que permite transformar bilhões ou trilhões de parâmetros em uma resposta que começa a aparecer na tela em poucos segundos.


Federação de Service Mesh Multicloud: Orquestrando Tráfego Zero-Trust entre Nuvens via Istio e SPIFFE/SPIRE
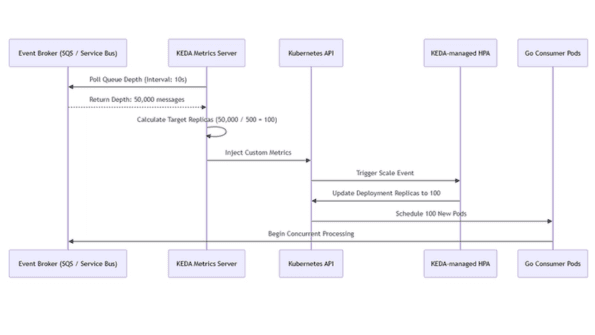
Arquitetando o dimensionamento automático orientado a eventos em várias nuvens: federando KEDA e Go na AWS e no Azure
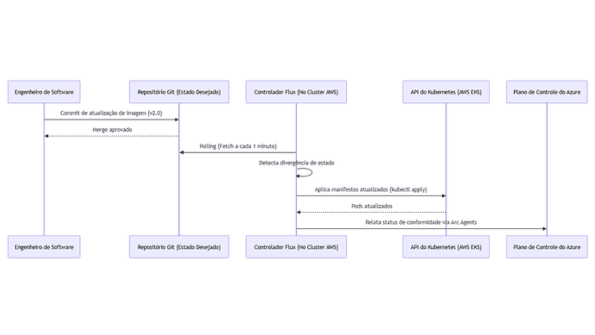
Governança Multicloud e GitOps: Unificando Clusters Kubernetes com Azure Arc e Flux
 Cláudio Raposo
Arquitetura de Identidade Multicloud de Confiança Zero: Federando SPIFFE/SPIRE na AWS e no Azure
Cláudio RaposoArquitetura de CQRS Multicloud: Desacoplando Domínios de Leitura e Gravação entre AWS e Azure
Cláudio RaposoAWS Cellular Architecture: Escalando Sistemas Event-Driven com DynamoDB, SNS e SQS
Cláudio Raposo