O banco de dados está no Brasil. Você sabe para onde sua IA envia os dados?

Soberania de dados vai além da região da cloud: prompts, logs e rotas de contingência também precisam respeitar os limites do produto.

A aplicação roda no Brasil. O banco de dados↳Banco de dados134 conteúdosSQL ou NoSQL: eis a questão!!Data · mar 2020Banco de dados: como organizar e dar segurança para milhões de dados de loteriasData · mai 20215 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → também. Na revisão da nova integração com IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →, alguém aponta para a região escolhida na cloud e dá o assunto por encerrado.
Só que o botão de “resumir chamado” acabou de criar outros caminhos para aqueles dados.
Imagine este cenário: o sistema de atendimento exige autenticação, usa TLS e consulta uma API cujo fornecedor informa que não usa os dados para treinar seus modelos por padrão. Quando o atendente pede um resumo, o texto do chamado segue para o endpoint de inferência. Se a requisição falha, o SDK registra seu conteúdo e manda o log para a plataforma de observabilidade. Se o fornecedor fica indisponível, a aplicação tenta outro serviço, com condições contratuais diferentes.
O cenário é hipotético, mas o problema de arquitetura é bem definido. A equipe sabe onde está o registro original, porém não verificou o destino das cópias que a própria feature produz.
Eu revisaria o fluxo inteiro, não apenas a região do banco de dados. A promessa feita ao cliente precisa continuar valendo quando a requisição falha, o log é enviado ou um worker tenta processar o chamado novamente.
O endereço do banco de dados não descreve o sistema inteiro
Escolher uma região responde a uma parte da discussão. Ainda precisamos separar residência, jurisdição e controle sobre os dados.
Na residência, interessa saber onde ficam o banco de dados, os backups e o índice de busca, além de onde a inferência acontece. Esses componentes podem estar em lugares diferentes, mesmo dentro de uma única integração.
A jurisdição diz respeito às leis e obrigações que alcançam a operação e os agentes envolvidos. A própria LGPD↳LGPD14 conteúdosComo utilizar a LGPD com o objetivo de conformidade e inovação?Gestão Dev & TI · out 2021LGPD coloca pressão inédita nos responsáveis pela tecnologia das empresasData · ago 2021Proteção de dados: LGPD é sancionada e começa a valerData · set 2020Ver tudo em Gestão Dev & TI → prevê hipóteses de aplicação independentemente do país da sede ou da localização dos dados.[1]
O controle aparece nas decisões do dia a dia: quem pode acessar o conteúdo, autorizar outro uso, interromper o envio, executar uma exclusão e mostrar o que aconteceu. É com esse sentido de engenharia que uso “soberania de dados” neste artigo, não como sinônimo jurídico de “servidor nacional” ou como algo que a nacionalidade do fornecedor resolva sozinha.
A LGPD não estabelece uma obrigação geral de manter todos os dados pessoais no Brasil. O artigo 33 prevê hipóteses para transferência internacional, cada uma com seus requisitos.[1] A Resolução CD/ANPD nº 19/2024 regulamenta mecanismos como cláusulas-padrão contratuais e decisões de adequação.[2]
Na prática, precisamos avaliar o fluxo, a finalidade, os dados e os agentes envolvidos, considerando também regras setoriais e contratuais aplicáveis. Proibir qualquer saída pode ser uma simplificação tão ruim quanto liberar tudo porque o fornecedor assinou um contrato.
O regulamento também define transferência como transmitir, compartilhar ou disponibilizar acesso a dados pessoais a outro agente, e distingue transferência internacional de coleta internacional direta.[2] Procurar apenas uma cópia física no exterior deixa perguntas sem resposta. Um acesso de suporte a partir de outro país, por exemplo, precisa ser avaliado considerando os agentes e as condições daquele acesso. O IP, sozinho, não resolve o enquadramento.
No diagrama de arquitetura, eu detalharia essas conexões antes de considerar encerrada a escolha da região.

Consentimento não é um booleano que libera tudo
Uma checkbox “aceito o uso de IA” pode parecer uma solução rápida. O consentimento é uma das hipóteses legais de tratamento previstas na LGPD, não a única. Para dados pessoais sensíveis, há requisitos específicos no artigo 11.[1]
O time de desenvolvimento não deveria escolher a base legal pela facilidade de implementação ou presumir que a execução de um contrato cobre qualquer uso dos dados. Cabe ao controlador definir e sustentar esse enquadramento, com o apoio das áreas responsáveis. Para a engenharia, o trabalho é explicar o que o sistema realmente faz e implementar os limites definidos.
Quando o tratamento depende de consentimento, ele precisa se referir a finalidades determinadas. A lei considera nulas as autorizações genéricas e prevê revogação por procedimento gratuito e facilitado.[1]
No nosso chamado, resumir o relato para ajudar o atendente é uma operação. Reaproveitar o histórico dos clientes para desenvolver um modelo é outra. A justificativa da primeira não deve ser estendida automaticamente à segunda. Cada uso exige avaliar finalidade, necessidade, transparência e base legal.[1]
Nesse caso, consent=true é pouco para explicar a decisão. Em um fluxo baseado em consentimento, eu precisaria relacionar a manifestação à finalidade, à versão do aviso apresentada, ao momento do aceite e ao estado atual da autorização. Esse é um desenho possível para produzir evidência, não um schema exigido pela lei.
Se houver transferência internacional, existe outra avaliação. O regulamento exige tanto uma hipótese legal de tratamento quanto um mecanismo válido para a transferência.[2] O consentimento específico e em destaque para a transferência é uma das hipóteses da LGPD, mas não uma exigência universal para toda operação internacional.[1]
Identificar a base legal não dispensa avaliar o mecanismo de transferência. Da mesma forma, assinar o contrato do fornecedor não dispensa verificar o conteúdo que a aplicação envia.
“Não usamos para treinamento” deixa outras perguntas em aberto
Eu não encerraria a avaliação de uma API ao encontrar essa frase na documentação. Ainda precisaria saber onde a inferência acontece, por quanto tempo o conteúdo fica retido, em que estado a aplicação persiste e quais terceiros podem acessá-lo.
A documentação da API da OpenAI ajuda a entender essa diferença. Ela informa que os dados enviados não são usados para treinar ou melhorar os modelos, salvo adesão explícita ao compartilhamento. No mesmo documento, descreve a retenção de logs de monitoramento de abuso, estado de aplicação e controles sujeitos a elegibilidade e limitações.[3]
“Não treina”, portanto, não quer dizer “não guarda”. E uma condição documentada para um endpoint não deve ser estendida automaticamente a todas as ferramentas do fornecedor.
A localização também pede uma leitura cuidadosa. A documentação distingue armazenamento regional de processamento regional e ressalva situações em que o conteúdo pode ser processado fora da região selecionada. Há ainda exceções de escopo, como dados de sistema e serviços de terceiros.[3]
Estou usando esse fornecedor como exemplo porque a documentação permite mostrar essas diferenças. Para uma integração real, eu verificaria o produto contratado, o endpoint, os recursos habilitados e as condições aplicáveis àquele uso. Uma declaração sobre a empresa inteira não chega nesse nível de detalhe.
Na busca semântica, essa revisão começa antes do prompt final. Se uma API externa gera os embeddings, ela recebe o texto necessário para produzi-los. Guardar os vetores localmente não muda o destino que o texto já teve.
Eu também não trataria a conversão em vetor como prova de anonimização. A LGPD relaciona anonimização à impossibilidade de associação com uma pessoa, considerando meios razoáveis e disponíveis, e prevê situações em que a reversibilidade mantém o enquadramento como dado pessoal.[1] Antes de dispensar controles sobre embeddings e metadados, eu avaliaria a possibilidade de identificação no contexto em que serão usados.

Transformando o compromisso em uma política de fluxo
Antes de conectar o SDK ao sistema de atendimento, eu preencheria uma ficha curta:
Pergunta-resposta que precisa existir: Para que o dado será usado? Finalidade específica do resumo e limites de reutilização. O que precisa sair? Campos e trechos mínimos; anexos e histórico completo não entram por conveniência. Quem recebe ou acessa? Fornecedor, serviços auxiliares, operadores e acessos administrativos relevantes. Onde pode armazenar e processar? Restrições separadas para conteúdo, derivados, logs e backups. O que sustenta a operação? Hipótese legal, mecanismo de transferência quando aplicável e condições contratuais avaliadas. Quando deve parar ou apagar? Eventos de término, revogação quando aplicável e política de retenção. O que acontece se falhar? Destinos alternativos previamente avaliados ou degradação sem IA.
A ficha não substitui inventário de tratamento, contrato ou avaliação jurídica. Eu a usaria para colocar na mesma conversa decisões que, sem algum registro, acabam espalhadas entre configuração, código e condições do fornecedor.
No payload do resumo, por exemplo, eu selecionaria os campos necessários em vez de serializar o objeto inteiro do chamado. Se CPF, telefone e endereço não ajudam o modelo naquela tarefa, ficam de fora. É uma aplicação do princípio da necessidade previsto na LGPD.[1]
O corpo do chamado dá mais trabalho. O cliente pode escrever dados pessoais no texto livre, mesmo que a aplicação tenha removido os campos correspondentes do payload. Filtros e mascaramento ajudam, mas não garantem anonimização. Dependendo do risco, pode ser necessário restringir o uso da feature ou revisar o conteúdo antes do envio.
Em um RAG, eu aplicaria as permissões do usuário e o isolamento entre clientes antes de montar o contexto enviado ao modelo. A instrução “não revele dados de outro cliente” no prompt não substitui o controle de acesso no backend↳Back-end49 conteúdosIntegração front-end com backend: 7 decisões que evitam caos entre APIs, BFF e GraphQLDev (Back & Front) · abr 2026Como criar uma FAKE API REST para testes — JSONPlaceholderDev (Back & Front) · set 2025Construindo um aplicativo de bate-papo de IA simples com Spring AI e AngularDev (Back & Front) · jul 2025Ver tudo em Dev (Back & Front) →.
Uma camada de integração pode concentrar a escolha do endpoint permitido, configurações de retenção, minimização e auditoria. Para isso funcionar como controle, a equipe também precisa cuidar das credenciais e das restrições de saída. De pouco adianta centralizar a política se outro serviço consegue contorná-la usando uma chave alternativa.
Eu também não criaria um gateway sofisticado só para dizer que existe um gateway. Para uma integração pequena, um adaptador bem delimitado, com configuração revisada e testes de saída, pode ser suficiente. Procuraria o desenho mais simples que permita aplicar a mesma política em todas as chamadas daquele fluxo.
O fallback também precisa respeitar a regra
O fornecedor principal ficou indisponível. A equipe preparou um segundo destino para manter o resumo funcionando. Esse segundo destino pode receber os mesmos dados?
Se o produto promete processamento em uma região aprovada, mudar silenciosamente de destino pode manter a feature no ar e ao mesmo tempo quebrar o compromisso assumido. Essa escolha precisa ser feita quando a contingência é desenhada, não no meio do incidente.
Para o chamado do exemplo, eu consideraria algumas possibilidades conforme a política aprovada:
- Usar um segundo destino já avaliado para o mesmo fluxo.
- Manter o atendimento disponível, mas suspender temporariamente o resumo por IA.
- Reprocessar depois, se a retenção na fila e a autorização ainda permitirem.
Reprocessar exige mais do que guardar o payload. Entre a entrada na fila e a execução do job, a política pode mudar ou pode ocorrer uma revogação aplicável àquele tratamento. O worker precisa reavaliar essas condições antes do envio, em vez de confiar indefinidamente na decisão tomada quando o job foi criado.
Rodar o modelo em infraestrutura própria também é uma possibilidade. Pode reduzir a dependência de uma API externa, mas deixa com a equipe o trabalho de gerir acesso administrativo, atualização, monitoramento, capacidade e descarte. Eu colocaria essas responsabilidades na conta antes de escolher self-hosting como solução para o problema.
Quanto mais destinos a aplicação puder usar, mais condições ela precisará verificar antes de encaminhar os dados. Esse trade-off entre flexibilidade de roteamento e limites de uso precisa aparecer na decisão de arquitetura e no comportamento do produto, inclusive nos retries.

Apagar a linha não encerra o ciclo de vida
O resumo ficou pronto. Além do chamado original, o sistema pode ter armazenado a resposta, criado cache, emitido eventos, indexado trechos e registrado dados de diagnóstico. Quando for necessário eliminar um dado, a equipe precisará saber quais desses artefatos ainda permitem associá-lo ao titular.
A LGPD prevê o término do tratamento, direitos de eliminação e hipóteses de conservação. Revogação, portanto, não deve ser apresentada como apagamento imediato e irrestrito de tudo. Tampouco autoriza continuar o mesmo uso sob outro nome.[1]
Eu relacionaria os derivados à origem para conseguir executar o descarte: retirar trechos do índice de busca, invalidar caches, tratar jobs pendentes e registrar o resultado das operações necessárias. Se houver obrigação legal de retenção, essa finalidade precisa ficar separada do uso pelo assistente.
Com backups, eu definiria como o descarte funciona e o que acontece durante uma restauração. Se a estratégia usa expiração controlada, precisa documentar prazo, acesso restrito e procedimento de recuperação, além de validar se isso atende às obrigações aplicáveis. Restaurar um backup não pode simplesmente devolver ao uso dados cuja restrição ou exclusão já havia sido registrada.
A observabilidade merece o mesmo cuidado. Registrar o prompt completo para demonstrar conformidade cria outra cópia do conteúdo, justamente o tipo de coisa que estamos tentando controlar. Eu daria preferência a evidências proporcionais, como identificador da operação, versão da política, destino autorizado, decisão de bloqueio e resultado do descarte. Esses metadados também precisam de regras de acesso e retenção.
O que eu pediria antes de aprovar a integração
A declaração “o fornecedor atende à LGPD” não mostra como a nossa aplicação se comporta. Em uma revisão, eu pediria evidências do fluxo implementado:
- Um payload de teste mostrando que campos desnecessários não saem da aplicação.
- Uma tentativa de recuperar dados de outro cliente foi bloqueada antes da inferência.
- Uma indisponibilidade simulada sem desvio para um destino não autorizado.
- Um job pendente barrado depois de uma mudança de política ou revogação aplicável.
- Um teste de exclusão e restauração cobrindo os derivados relevantes.
- Uma revisão dos logs confirmando que o tratamento de erro não registra conteúdo proibido.
Esses testes não certificam conformidade jurídica. Servem para verificar se o sistema faz o que foi definido e, principalmente, encontrar os lugares onde política e implementação ainda não combinam.
No nosso exemplo, o botão de resumo continua sendo uma funcionalidade pequena na tela. Eu só não encerraria a revisão nele. Acompanharia o chamado até a API, os logs, a fila e os destinos de contingência.
Saber que o banco de dados está no Brasil não responde por nenhum desses caminhos.
Se a próxima integração de IA precisar respeitar uma restrição de uso dos dados, o que hoje impede seu sistema de ultrapassá-la, inclusive durante uma falha?
Nota de escopo: este artigo discute implicações de engenharia a partir de fontes brasileiras e documentação técnica. Não substitui a avaliação jurídica do caso concreto. Condições de fornecedores e normas aplicáveis devem ser rechecadas antes da implementação e da publicação.
Sources
[1] https://www.planalto.gov.br/ccivil_03/_ato2015-2018/2018/lei/l13709.htm
O modelo não fez tudo aquilo. O sistema fez.
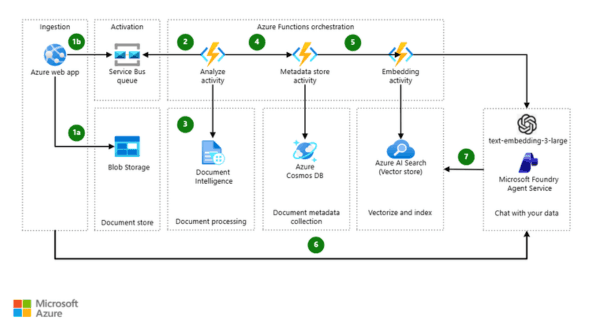

Processamento de Documentos em Larga Escala: Pipeline de OCR Assíncrono com Azure AI Document Intelligence, Azure Functions e PostgreSQL

Seu frontend virou uma camada de integração?
Como criar um bot para copy trade na Binance Spot com Node.js
 Luiz Fernando Duarte Junior
Quando o agente de IA vira funcionário: um problema de identidade
 Ramon Ribeiro
NET – Integração de IA no Backend com Microsoft.Extensions.AI
 John Calistro
Banco, busca, fila e vetores no Postgres: quando a simplicidade vira risco?
John Calistro