Banco, busca, fila e vetores no Postgres: quando a simplicidade vira risco?
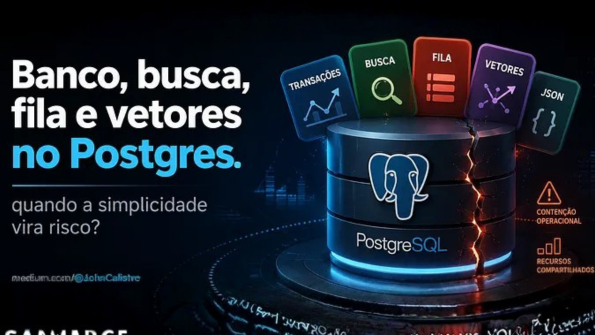
Uma aplicação nova precisa armazenar transações, aceitar dados flexíveis, pesquisar textos, executar tarefas assíncronas e oferecer busca semântica.
Dá para montar uma stack com banco de dados↳Banco de dados134 conteúdosSQL ou NoSQL: eis a questão!!Data · mar 2020Banco de dados: como organizar e dar segurança para milhões de dados de loteriasData · mai 20215 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → relacional, search engine, broker de mensagens, armazenamento de documentos e banco de dados vetorial. O desenho faz sentido, mas cada componente traz credenciais, backup, observabilidade↳Observabilidade11 conteúdosObservabilidade para APIs: os desafios e benefícios dessa abordagemDev (Back & Front) · jan 2025Falhas em Observabilidade afetam os Apps e a Segurança das OrganizaçõesDev (Back & Front) · nov 2023ADK Java 1.0: O Google quer que você pare de gambiarra Python no seu backendMarketing Tech · abr 2026Ver tudo em DevSecOps →, custo, sincronização e um jeito próprio de falhar.
Também dá para começar com PostgreSQL.
Essa escolha não é gambiarra. Para muitos produtos, é a decisão mais responsável. O PostgreSQL valida e indexa documentos com jsonb, além de oferecer full-text search.[1][2]
Com LISTEN e NOTIFY, ele sinaliza mudanças entre processos. O banco também permite coordenar consumidores com bloqueio de linhas e recebe busca vetorial por meio do pgvector.[3][4][5]
Até aqui, tudo bem. O problema costuma aparecer mais tarde, sem que ninguém tenha parado para decidir onde estavam os limites.
Uma coluna jsonb resolve um requisito flexível. Uma tabela de jobs evita a adoção imediata de um broker. A busca textual poupa outro cluster. O pgvector coloca o primeiro recurso de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → no ar. Separadamente, cada escolha parece pequena e fácil de reverter.
Alguns meses depois, o banco principal também responde por busca, fila, índice vetorial e um barramento informal de eventos. Ninguém reuniu o time para anunciar uma plataforma de dados. Ela cresceu dentro do banco, uma decisão conveniente por vez.
O Postgres não virou plataforma por acidente
A força do PostgreSQL vai além do SQL. Consistência transacional, extensibilidade e uma caixa de ferramentas madura resolvem boa parte das necessidades de uma aplicação moderna.
O jsonb armazena estruturas flexíveis com validação sintática, operadores próprios e suporte a índices. A documentação recomenda esse tipo para a maioria dos casos porque ele evita reprocessar o texto em cada consulta e pode ser indexado.[1]
O full-text search transforma documentos em representações pesquisáveis, consulta termos e ordena resultados. Para muitos produtos, isso adia ou elimina a necessidade de uma infraestrutura de busca separada.[2]
Uma tabela de jobs combinada com FOR UPDATE SKIP LOCKED permite que vários workers busquem trabalho sem esperar pelas linhas que outro worker já selecionou. Há uma ressalva importante: a documentação diz que SKIP LOCKED produz uma visão inconsistente dos dados e o indica para reduzir contenção em estruturas semelhantes a filas. Não é uma opção neutra para qualquer consulta.[4]
Com LISTEN e NOTIFY, processos conectados ao mesmo banco recebem sinais depois do commit. É um mecanismo simples e conveniente, mas a própria documentação o define como comunicação entre processos, com payload pequeno e uma fila interna de notificações. Isso é diferente de uma mensageria durável e completa.[3]
O pgvector mantém embeddings perto dos dados relacionais, suporta busca exata e aproximada e combina filtros SQL com similaridade vetorial.[5]
A capacidade técnica está comprovada. Resta decidir se todas essas funções devem dividir a mesma unidade operacional.

O ganho real de colocar mais coisas no mesmo banco
Discussões de arquitetura costumam somar a complexidade do componente novo e esquecer tudo o que ele obriga o time a integrar e operar.
Ao manter busca, fila, JSON e vetores no PostgreSQL, o time pode evitar:
- Sincronização entre o banco e um índice externo;
- Consistência eventual onde ela não traz benefício;
- Dual writes e rotinas de reconciliação;
- Mais um serviço para provisionar, atualizar e monitorar;
- Novas credenciais e políticas de acesso;
- Contratos de integração criados antes da hora;
- Uma tecnologia que ninguém no time sabe operar bem.
Há ainda uma vantagem difícil de reproduzir fora do banco: a mesma transação consegue alterar o estado do negócio e registrar o trabalho que virá depois. Um pedido e seu evento de outbox, por exemplo, podem ser persistidos atomicamente. Assim, não aparece aquela janela incômoda em que o pedido existe, mas a mensagem correspondente se perdeu entre dois sistemas.
Para um produto em descoberta, um time pequeno ou um workload moderado, essa simplicidade reduz risco e acelera a entrega.
O erro começa quando uma vantagem ligada ao contexto vira regra: “se cabe no Postgres, deve ficar no Postgres”.
A conta escondida não aparece no diagrama
No diagrama, banco, busca, fila e vetores podem ocupar quatro caixas ou uma só. A caixa única parece mais simples, mas o desenho não mostra como cada workload se comporta em produção.
O caminho transacional pede latência previsível e consistência. A busca textual pode trazer índices grandes, ranking e consultas caras. A fila produz polling, updates frequentes, retries e backlog. A busca vetorial usa memória e CPU para construir índices e calcular vizinhança. Já o JSON flexível acelera a evolução do produto, mas pode esconder esquemas instáveis e espalhar índices e expressões difíceis de otimizar.
Na mesma instância, essas funções dividem:
- CPU, memória, cache e I/O;
- Pool de conexões;
- Autovacuum e pressão de escrita;
- WAL, réplicas e janela de backup;
- Deploys de extensões e upgrades;
- Espaço em disco;
- Incidentes e manutenção programada;
- A equipe que fica de plantão.
Diminuir o número de componentes não faz os workloads ficarem parecidos. Só coloca todos eles para disputar os mesmos recursos.
A partir daí, o risco muda de forma. Em vez de “temos sistemas demais”, o time passa a lidar com uma consulta de similaridade, um pico de jobs ou a reconstrução de um índice degradando o caminho transacional que sustenta o produto.
O PostgreSQL expõe estatísticas de atividade, tabelas, índices, I/O, WAL e replicação. Essas métricas ajudam a enxergar a disputa, mas não isolam um workload do outro.[8]

JSON: flexibilidade local ou domínio sem contrato?
O jsonb funciona bem para a parte realmente variável do dado: preferências, metadados, payloads recebidos, configurações e atributos que aparecem só em algumas consultas.
A dificuldade começa quando ele vira a resposta automática para qualquer dúvida de modelagem.
Campos antes periféricos passam a participar de filtros críticos, joins, constraints e relatórios. Nesse momento, provavelmente já existe um esquema; ele só não foi declarado. O time compensa com índices de expressão, casts, validações na aplicação e convenções que vivem na cabeça de poucas pessoas. A flexibilidade que ajudou no início reaparece como custo de consulta, migração e governança.
Não é preciso banir JSON do banco. Quando um campo se torna parte estável do contrato do negócio, vale promovê-lo para o modelo relacional.
Busca: o índice perto do dado ou um produto de relevância?
A busca textual do PostgreSQL atende bem a catálogos internos, volumes moderados e consultas que combinam texto com filtros transacionais. Também funciona quando a relevância ainda não exige uma operação própria.
A situação muda quando a busca deixa de ser uma funcionalidade e ganha roadmap de produto.
Sinônimos do domínio, vários idiomas, tolerância avançada a erros, sinais de comportamento, regras de merchandising, testes de ranking e escala independente podem justificar um mecanismo especializado.
A decisão não deveria seguir a stack de outras empresas. Separar faz sentido quando a busca passa a ter SLO, ritmo de evolução e perfil de carga próprios.
Fila: coordenação transacional ou infraestrutura de mensageria?
Uma fila baseada em tabela pode resolver muito bem jobs internos. Ela é auditável, simples de consultar e participa da mesma transação que criou o trabalho.
Só que uma fila de produção envolve mais do que selecionar a próxima linha pendente. O time precisa definir:
- Como funcionam retries e backoff;
- Quando um worker é considerado morto e quem recupera o job;
- Como tratar processamento duplicado e idempotência;
- Como representar prioridade, agendamento e dead-letter;
- Qual é a política de retenção e limpeza;
- Como medir throughput, falhas e a idade do job mais antigo.
LISTEN/NOTIFY pode diminuir a latência do polling, mas as notificações são entregues entre transações, podem ser agrupadas quando repetem o mesmo payload na mesma transação e têm payload limitado. Se perder o sinal não pode significar perder o trabalho, o estado durável precisa continuar em uma tabela.[3]
Quando a fila é um detalhe interno e o volume está sob controle, o Postgres pode ser a opção mais simples. Quando ela conecta vários serviços e precisa de fan-out, replay, retenção longa e escala independente, a tabela começa a carregar responsabilidades de uma infraestrutura de mensageria.
Vetores: proximidade dos dados ou competição pelo banco principal?
Com o pgvector, embeddings ficam junto das entidades que representam. A aplicação evita uma sincronização inicial, combina filtros relacionais com similaridade e continua em um modelo operacional conhecido.[5]
Em muitos produtos, essa configuração vai atender por bastante tempo.
O limite não aparece em uma comparação genérica entre Postgres e bancos vetoriais. Ele aparece nos números e no comportamento do workload:
- Tamanho do corpus e ritmo de crescimento;
- Frequência de atualização dos embeddings;
- Latência e recall esperados;
- Custo de construção e manutenção dos índices;
- Filtros aplicados antes ou durante a busca;
- Concorrência com as transações do produto;
- Necessidade de escalar leitura vetorial sem escalar o banco inteiro.
Em vez de perguntar apenas quantos vetores o Postgres suporta, o time precisa medir o que esse workload faz com as transações que não têm relação com IA.
O problema não é concentração. É concentração sem limites
Um PostgreSQL central pode sustentar uma arquitetura intencional, observável e resiliente. Para chegar lá, cada função precisa ter seu próprio orçamento operacional, mesmo que todas usem a mesma tecnologia.
Antes de colocar mais uma responsabilidade no banco, vale responder:
- SLO: quais metas de latência, disponibilidade e recuperação essa função exige?
- Perfil de carga: onde ela pressiona mais, em leitura, escrita, CPU, memória, I/O ou conexões?
- Crescimento: que volume, ingestão e retenção esperamos em 6 e 18 meses?
- Isolamento: um pico nessa função pode afetar transações críticas?
- Observabilidade: conseguimos acompanhar fila, consultas, índices, locks, bloat, WAL e saturação por workload?
- Operação: quem investiga e corrige a degradação?
- Saída: como extrair os dados sem manter dual write para sempre nem exigir uma longa parada?
O particionamento ajuda tabelas grandes e padrões previsíveis, mas cobra planejamento e memória quando aplicado sem critério. A documentação recomenda testar o workload e usar contenção, em vez de assumir que mais partições sempre melhoram o sistema.[6]
Até os recursos nativos de escala pedem decisão e acompanhamento. O fato de estarem dentro do Postgres não elimina esse trabalho.

Quando manter no Postgres
Faz sentido manter uma função no PostgreSQL quando:
- A consistência transacional com os dados do negócio traz um ganho concreto;
- Volume e concorrência são moderados e previsíveis;
- O time conhece e opera PostgreSQL melhor do que a alternativa;
- Não há necessidade de escalar essa função separadamente;
- Seus SLOs são compatíveis com o banco principal;
- As métricas revelam contenção antes que ela vire incidente;
- Existe um caminho viável de extração se o contexto mudar.
Esse caminho de saída merece atenção. Uma decisão reversível continua simples por mais tempo. Sem fronteiras internas, contratos e uma trilha de mudança, a conveniência vira dependência estrutural.
Quando separar
A extração passa a fazer sentido quando a função:
- Domina CPU, memória, I/O, WAL ou conexões em períodos relevantes;
- Cresce ou retém dados em um ritmo muito diferente do transacional;
- Precisa de disponibilidade, latência ou recuperação independentes;
- Provoca incidentes em partes do produto que não dependem dela;
- Exige recursos especializados que já influenciam o roadmap;
- Tem equipe, permissões ou ciclos de mudança próprios;
- Não cabe mais em um teste realista dentro da janela operacional do banco.
Separar também cobra seu preço. Os dados atravessam uma nova fronteira e surgem atrasos de sincronização, reconciliação, duplicação e outros modos de falha. A decisão precisa comparar dois riscos concretos: a contenção que já existe e a complexidade distribuída que será criada.
Como extrair sem transformar prudência em reescrita
Não é preciso substituir tudo de uma vez.
O primeiro passo é deixar a responsabilidade visível dentro do PostgreSQL, com tabelas e schemas claros, interfaces definidas, métricas separadas e ownership conhecido.
Depois, o time precisa de um fluxo confiável para propagar mudanças. O padrão outbox grava a alteração do negócio e o evento na mesma transação; outro processo publica ou replica esse evento. A replicação lógica do PostgreSQL também transmite mudanças de conjuntos específicos de dados para assinantes e pode apoiar uma migração gradual, desde que o time conheça suas restrições e saiba operá-la.[7]
Sempre que possível, vale mover a leitura antes da escrita. Um índice de busca ou armazenamento vetorial externo pode ser reconstruído a partir da fonte de verdade. Durante a transição, atraso, divergência e fallback precisam aparecer nas métricas.
Dual write direto deveria ser a exceção e exige idempotência e reconciliação explícitas. Duas chamadas que quase sempre funcionam não formam uma transação distribuída.
A evidência operacional deve puxar a extração. Ansiedade arquitetural, sozinha, não é um bom motivo para reescrever o sistema.
Simplicidade também precisa de governança
O PostgreSQL assumiu o papel de plataforma porque combina consistência, extensibilidade e maturidade operacional para resolver problemas reais.
Aproveitar essa capacidade é uma escolha pragmática. O risco aparece quando o time adiciona responsabilidades sem medir a disputa por recursos, sem definir limites e sem preparar uma rota de saída. Nesse cenário, banco, busca, fila, JSON e vetores precisam crescer no mesmo ritmo, aceitar o mesmo SLO e dividir o mesmo domínio de falha.
Talvez essa combinação continue saudável por anos. Se isso acontecer, a arquitetura concentrada terá evitado uma quantidade enorme de complexidade desnecessária.
Se os workloads seguirem caminhos diferentes, ter começado com PostgreSQL não terá sido o erro. O erro terá sido tratar uma escolha feita para um contexto específico como uma regra permanente.
Quantas dessas funções podem falhar, escalar e evoluir juntas sem fazer o restante do produto pagar a conta? Essa é a pergunta que define o limite.
Fontes
[1] https://www.postgresql.org/docs/current/datatype-json.html — PostgreSQL — JSON Types
[2] https://www.postgresql.org/docs/current/textsearch.html — PostgreSQL — Full Text Search
[3] https://www.postgresql.org/docs/current/sql-notify.html — PostgreSQL — NOTIFY
[4] https://www.postgresql.org/docs/current/sql-select.html — PostgreSQL — SELECT e SKIP LOCKED
[5] https://github.com/pgvector/pgvector — pgvector — vector similarity search for Postgres
[6] https://www.postgresql.org/docs/current/ddl-partitioning.html — PostgreSQL — Table Partitioning
[7] https://www.postgresql.org/docs/current/logical-replication.html — PostgreSQL — Logical Replication
[8] https://www.postgresql.org/docs/current/monitoring-stats.html — PostgreSQL — Monitoring Statistics


.NET 11 e C# 15: Recursos e Otimizações no EF Core e LINQ
Boas Práticas de Segurança em APIs ASP .NET Core
O JWT Bearer Manual e o Bearer Token nativo da ASP.NET Core
 José Carlos Macoratti
Roteiro – Desenvolvedor Backend em 2026
José Carlos MacorattiMonolito Modular vs Microsserviços – O Melhor Ponto de Partida
José Carlos MacorattiO modelo não é o agente: o verdadeiro salto está no AI Harness.
 Cezar Taurion