Liquid Clustering supera ZOrder em três de quatro cargas, mostra benchmark no Delta Lake
Testes comparando Partitioning, ZOrder e Liquid Clustering no Delta Lake revelam que nenhuma estratégia de organização de dados vence sozinha, e que cada uma tem um ponto cego capaz de degradar consultas em produção sem ninguém perceber.

O que foi testado
Um benchmark publicado na InfoQ em 12 de outubro de 2026 comparou três formas de organizar dados em uma tabela Delta Lake: Partitioning, ZOrdering e Liquid Clustering. O autor, Kushal Kumar Vishwakarma, revisado por Renato Losio, rodou quatro tipos de consulta sobre um conjunto sintético de 50 milhões de registros para medir latência e volume de dados lidos em cada estratégia (fonte).
Segundo o autor, as perguntas por trás do benchmark vieram de problemas reais enfrentados ao arquitetar plataformas Delta Lake na TCS UK (setor aeroespacial civil) e na IBM, em projeto para a Shell Maritime, onde a escolha de layout afeta diretamente o cumprimento de SLA de pipelines e o custo de computação em nuvem↳Cloud30 conteúdosGerenciamento de infraestrutura multicloud com Kubernetes proporciona otimização e economiaDevSecOps · set 2021Vivo assina contrato para aquisição da IPNET e cresce em cloud computingDevSecOps · ago 20245 tendências da computação em nuvem para as empresasDevSecOps · abr 2022Ver tudo em DevSecOps →. A motivação declarada é que a maioria das comparações publicadas vem da própria Databricks ou parte de raciocínio teórico, sem medir o comportamento real das consultas.
As três estratégias, em poucas palavras
Para quem não lida com lakehouse no dia a dia, vale situar cada abordagem antes dos números:
- Partitioning divide fisicamente os dados em pastas por uma coluna (por exemplo,
txn_date), favorecendo varreduras sequenciais por intervalo. - ZOrder é um comando de otimização do Delta Lake que reordena os dados dentro dos arquivos com base em múltiplas colunas, melhorando a poda de arquivos quando o filtro bate exatamente com essas colunas.
- Liquid Clustering é a técnica mais recente do Delta Lake, que organiza os dados por uma curva de Hilbert e atualiza o clustering de forma incremental, sem exigir jobs manuais de
OPTIMIZEnem reescritas periódicas da tabela inteira.
As três formas de criar a tabela no benchmark seguem esse padrão:
# Partitioned
df.write.format('delta').partitionBy('txn_date').saveAsTable('lc_partitioned')-- ZOrdered
OPTIMIZE lc_zorder ZORDER BY (customer_id, region, txn_date)-- Liquid Clustered
CREATE TABLE lc_liquid
CLUSTER BY (customer_id, region, txn_date)
AS SELECT * FROM source_dataO desenho do experimento
O dataset simulava um ambiente de varejo com colunas como customer_id, txn_date, region, amount e product_cat, combinando distribuições uniformes e enviesadas. Os parâmetros de skew, como Zipf α = 1,2 para segmentos de cliente e um recorte de hot-spot de 80/20 por partição, não foram escolhidos arbitrariamente: o autor diz tê-los calibrado a partir de telemetria de produção, em que 20% dos segmentos de cliente concentram cerca de 80% do tráfego de consultas.
Os quatro cenários e quem venceu em cada um
O benchmark rodou quatro perfis de carga: busca pontual (point lookup), agregação por intervalo de tempo, filtro seletivo multicoluna e agregação ampla sobre todo o dataset.
| Tipo de carga | Melhor layout | Por quê |
|---|---|---|
| Point Lookup | Liquid Clustering | Localidade intra-arquivo reduz overhead de busca em disco |
| TimeRange Aggregation | Liquid Clustering | Localidade sequencial supera a dispersão de datas do ZOrder |
| MultiColumn Selective Filter | ZOrder | Poda de arquivos precisa, 10x menos dados lidos |
| Large Aggregation | Liquid Clustering | Localidade por curva de Hilbert vence em varreduras completas |
Os números de runtime e volume de dados lidos reforçam o padrão:
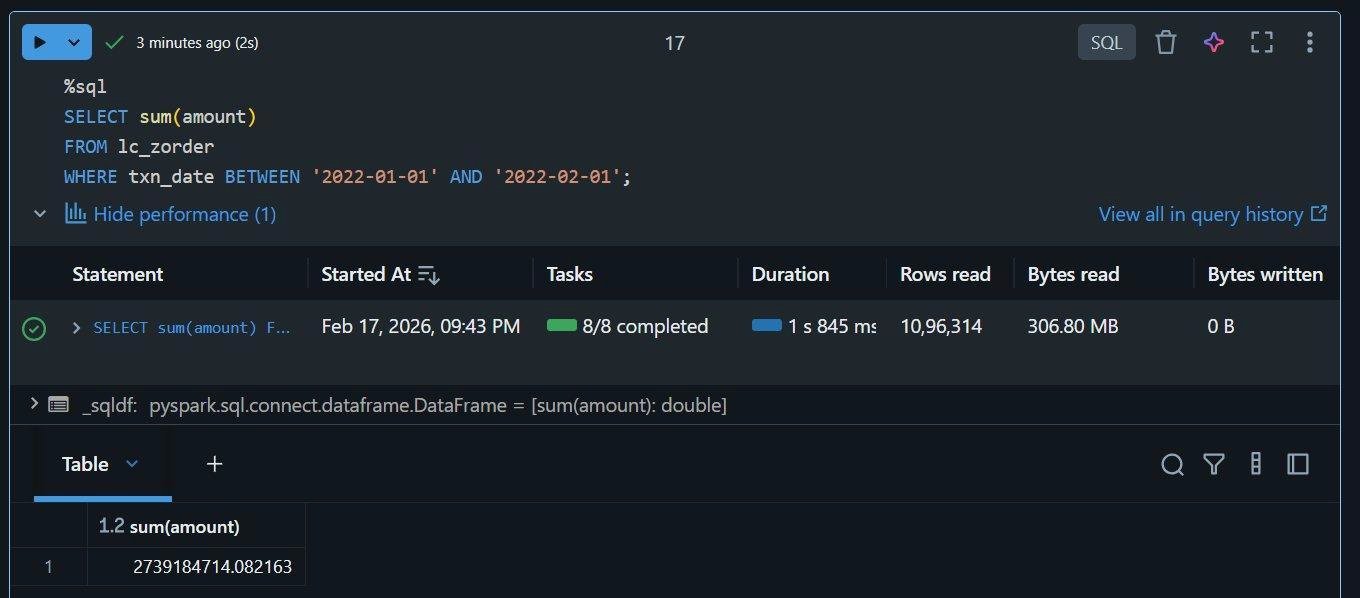
| Carga | Partitioning | ZOrder | Liquid Clustering |
|---|---|---|---|
| Point Lookup | 1,972s / 737,47 MB | 1,437s / 369,09 MB | 1,003s / 784,86 MB |
| TimeRange Aggregation | 1,038s / 449,69 MB | 1,845s / 306,80 MB | 0,659s / 449,19 MB |
| MultiColumn Filter | 0,622s / 128,09 MB | 0,615s / 59,03 MB | 2,967s / 639,95 MB |
As duas descobertas que contradizem o senso comum
O resultado mais chamativo do ponto de lookup é que o Liquid Clustering venceu lendo mais bytes que o ZOrder (784,86 MB contra 369,09 MB), mas ainda assim foi 49% mais rápido que a baseline particionada. A explicação do autor é que a organização por curva de Hilbert agrupa valores relacionados de customer_id dentro dos arquivos de forma mais eficiente, reduzindo o overhead de busca em disco mesmo lendo mais dados.
O segundo achado é uma falha oculta do ZOrder: quando a coluna de data entra como chave secundária ou terciária na expressão de clustering, como em ZORDER BY (customer_id, region, txn_date), consultas por intervalo de tempo ficaram 78% mais lentas que uma tabela simplesmente particionada por data. Os valores sequenciais de data acabam dispersos entre arquivos, destruindo a eficiência de range-scan que o particionamento oferece de graça.
No sentido inverso, quando o filtro da consulta bate exatamente com a chave do ZOrder, o Liquid Clustering perde feio: no cenário de filtro multicoluna, ele foi quase cinco vezes mais lento que o ZOrder, lendo dez vezes mais dados (639,95 MB contra 59,03 MB).
Suas principais consultas filtram, de forma consistente, pelas mesmas duas ou três colunas? Se a resposta for sim, use ZOrder nessas colunas. Caso contrário, escolha Liquid Clustering.
Do my top queries consistently filter on the same two or three columns? If the answer is yes, ZOrder those columns. Otherwise, choose Liquid Clustering.Kushal Kumar Vishwakarma, autor do benchmark na InfoQ
O guia de decisão prático
O autor resume a escolha em uma pergunta de diagnóstico: as consultas mais frequentes do seu time filtram sempre pelas mesmas duas ou três colunas, de forma estável? Se sim, ZOrder nessas colunas, com a mais seletiva listada primeiro, tende a vencer. Se não, ou se os padrões de consulta ainda estão mudando, Liquid Clustering é a escolha padrão recomendada, por vencer em três dos quatro cenários testados e eliminar a necessidade de agendar OPTIMIZE manualmente. Um script de apoio à decisão em Python↳Python56 conteúdosVSCode + Python + Alexa: Desenvolva e teste skills para alexa localmente com pythonDev (Back & Front) · out 2025Dominando decoradores em Python: um guia completo com exemplosDev (Back & Front) · jan 2025Desenvolvimento de software: diferenças entre Python, JavaScript e JavaGestão Dev & TI · nov 2024Ver tudo em Dev (Back & Front) →, junto com as queries usadas no benchmark, está disponível no GitHub citado pelo autor.
O que ainda falta medir
O próprio autor lista as limitações do estudo. O dataset é sintético, escolhido para garantir reprodutibilidade e evitar exposição de dados de cliente, mas datasets de produção carregam schema drift, sazonalidade de acesso e skew específico de domínio que podem mudar o resultado relativo entre os layouts. O benchmark também não mediu o custo de amplificação de escrita nem o overhead de computação para manter cada layout conforme novos dados chegam, embora o autor aponte que a abordagem incremental do Liquid Clustering deva ter custo de escrita menor que as reescritas periódicas do ZOrder.
Por que isso importa pra quem trabalha com dados no Brasil
Quem mantém pipelines Delta Lake em Databricks por aqui, seja em bancos, varejo ou seguradoras que processam grandes volumes transacionais, toma essa decisão de layout cedo e raramente revisita. O ponto prático do benchmark é que decisão de layout não é escolha única: times com consultas estáveis e previsíveis sobre poucas colunas ganham mantendo ZOrder, enquanto times com padrões de consulta variados, caso comum em plataformas de dados compartilhadas entre múltiplas equipes, tendem a sair ganhando ao migrar para Liquid Clustering.
O recado mais concreto é testável sem esperar nada: antes de travar uma estratégia de layout, rode as três principais consultas do seu workload contra Partitioning, ZOrder e Liquid Clustering numa amostra representativa dos seus próprios dados. Como mostram os números do benchmark, confiar apenas em bytes escaneados como proxy de performance pode levar à escolha errada, já que o layout que lê menos dados nem sempre é o mais rápido na prática.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Nvidia negocia comprar ou ampliar investimento na Reflection AI, diz FT
Segundo o Financial Times, a Nvidia estuda desde aportar mais capital até adquirir a Reflection AI, criadora do modelo aberto Beam, voltado a código e agentes.