RLS no PostgreSQL: benchmark mostra como a política de segurança pode custar de 0 a quase 2 segundos por query
Um benchmark detalhado em PostgreSQL 17.10 isola o que realmente encarece o row-level security: não é a ideia da política, é como ela busca o tenant, se consulta uma tabela de memberships e se usa funções não leakproof.
Row-level security (RLS) no PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → tem fama de vilão de performance, mas a fama raramente vem acompanhada de números. A consultoria Now-Next publicou em 30 de setembro e 1º de outubro de 2026 uma medição detalhada que isola exatamente onde o custo aparece, e onde não aparece. O teste rodou em PostgreSQL 17.10, container descartável, configuração padrão, cache quente, mediana de cinco execuções por cenário.
A tabela usada é a mesma de um estudo anterior da Now-Next sobre índices multi-tenant: 1.998.794 faturas distribuídas de forma bem desigual entre 1.000 tenants, o maior com 267.023 registros e o tenant mediano com 534. Esse desequilíbrio é proposital: é exatamente o cenário em que problemas de RLS se escondem em testes com dados pequenos e só aparecem em produção, com o maior cliente.
A política simples não custa nada
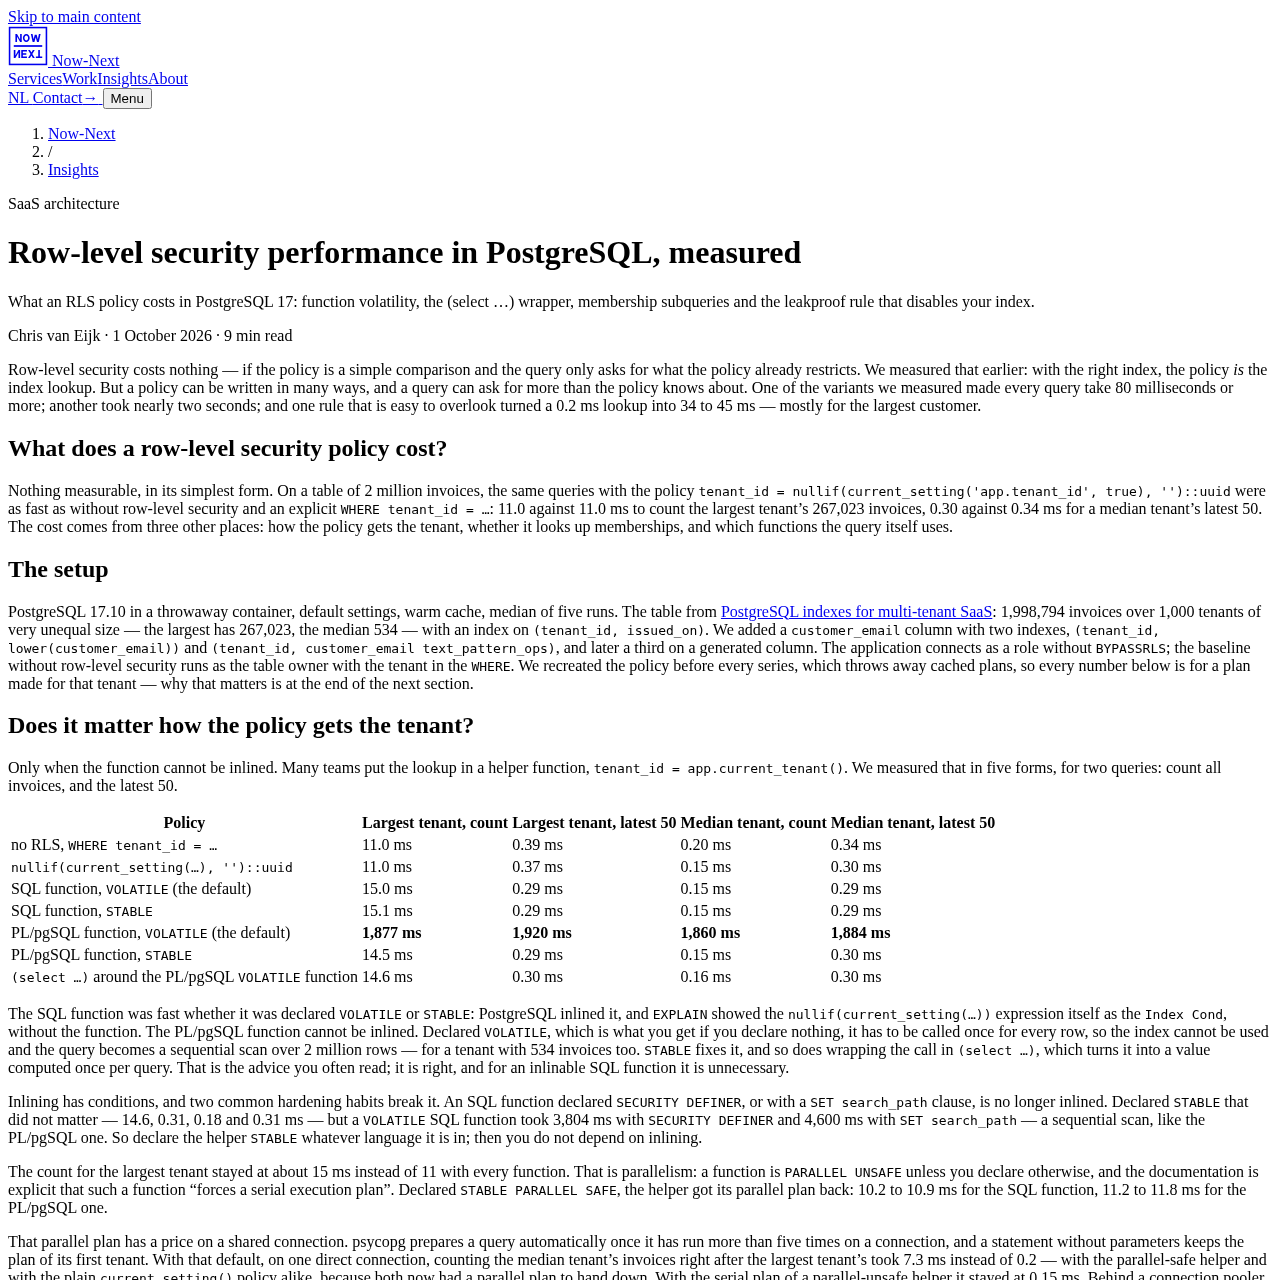
O primeiro resultado é também o mais tranquilizador. Com a política tenant_id = nullif(current_setting('app.tenant_id', true), '')::uuid, contar as 267.023 faturas do maior tenant levou 11,0 ms, exatamente igual à mesma consulta sem RLS com WHERE tenant_id = … explícito. Para o tenant mediano, buscar as últimas 50 faturas ficou em 0,30 ms contra 0,34 ms sem a política.
Em resumo: se a política é uma comparação direta contra um valor de sessão e a consulta já pede o que a política restringe, o planner usa a política como se fosse a própria condição WHERE, o índice em (tenant_id, issued_on) resolve tudo. O custo, segundo a Now-Next, vem de três outros lugares: como a política busca o tenant, se ela consulta uma tabela de memberships, e quais funções a própria consulta usa.
Quando a função do helper quebra o índice
Muitas equipes escondem a leitura do tenant atrás de uma função, algo como tenant_id = app.current_tenant(). O benchmark testou cinco variantes dessa função para as mesmas duas consultas:
| Política | Maior tenant, count | Maior tenant, últimas 50 | Mediano, count | Mediano, últimas 50 |
|---|---|---|---|---|
Sem RLS, WHERE tenant_id = … | 11,0 ms | 0,39 ms | 0,20 ms | 0,34 ms |
current_setting(…)::uuid direto | 11,0 ms | 0,37 ms | 0,15 ms | 0,30 ms |
| Função SQL, VOLATILE (padrão) | 15,0 ms | 0,29 ms | 0,15 ms | 0,29 ms |
| Função PL/pgSQL, VOLATILE (padrão) | 1.877 ms | 1.920 ms | 1.860 ms | 1.884 ms |
| Função PL/pgSQL, STABLE | 14,5 ms | 0,29 ms | 0,15 ms | 0,30 ms |
A função SQL foi rápida com VOLATILE ou STABLE porque o PostgreSQL consegue fazer inlining: o EXPLAIN mostra a expressão nullif(current_setting(…)) direto no Index Cond, sem rastro da função. Já a função PL/pgSQL nunca é inlined. Declarada VOLATILE, o padrão quando nada é declarado, ela precisa ser chamada linha a linha, o índice fica inútil e a consulta vira um sequential scan sobre os 2 milhões de registros, mesmo para um tenant com 534 faturas.
Declarar a função como STABLE resolve, e envolver a chamada em (select …) também resolve, porque isso transforma a chamada em um valor calculado uma única vez por consulta. É o conselho que já circula em listas de boas práticas de RLS, e ele está certo, só que é desnecessário quando a função é SQL simples e já inlineável.
Dois hábitos de hardening que quebram o inlining
O inlining tem condições, e duas práticas comuns de segurança o derrubam mesmo numa função SQL: declarar SECURITY DEFINER ou incluir uma cláusula SET search_path. Com STABLE, isso não importa, os números seguem em 14,6, 0,31, 0,18 e 0,31 ms. Mas uma função SQL VOLATILE com SECURITY DEFINER levou 3.804 ms, e com SET search_path, 4.600 ms: o mesmo sequential scan da função PL/pgSQL mal declarada.
A recomendação prática da Now-Next é direta: declare o helper STABLE, independentemente da linguagem. Assim a consulta não depende de um comportamento de inlining que qualquer segunda prática de hardening pode desativar sem aviso.
Há ainda um efeito colateral de paralelismo. Toda função é PARALLEL UNSAFE por padrão, e a documentação do PostgreSQL é explícita: isso "força um plano de execução serial". Por isso o count do maior tenant ficou em ~15 ms com qualquer função, em vez de 11 ms sem RLS. Declarando STABLE PARALLEL SAFE, o plano paralelo volta: 10,2 a 10,9 ms para a função SQL, 11,2 a 11,8 ms para a PL/pgSQL.
Esse plano paralelo tem um preço em conexão compartilhada: o psycopg prepara automaticamente uma query depois de cinco execuções na mesma conexão, e uma instrução sem parâmetros mantém o plano do primeiro tenant que a executou. Com isso, numa conexão direta, contar o tenant mediano logo depois do maior tenant levou 7,3 ms em vez de 0,2 ms, tanto com o helper paralelo-seguro quanto com a política simples por current_setting(), porque ambos agora tinham um plano paralelo para herdar. Atrás de um connection pooler, segundo a Now-Next, o efeito piora, medido separadamente num estudo sobre PgBouncer e RLS.
A subquery de membership custa caro sempre
Quando um usuário pode pertencer a vários tenants, é comum escrever a política consultando a tabela de memberships diretamente:
using (tenant_id in (
 select m.tenant_id from memberships m
where m.user_id = nullif(current_setting('app.user_id', true), '')::int))| Política | Maior tenant, count | Maior tenant, últ. 50 | Mediano, count | Mediano, últ. 50 |
|---|---|---|---|---|
| Tenant numa variável de sessão | 11,0 ms | 0,37 ms | 0,15 ms | 0,30 ms |
tenant_id in (select … memberships …) | 83–85 ms | 95–99 ms | 79–81 ms | 79–82 ms |
tenant_id = any (array(select …)) | 14,4 ms | 158 ms | 0,16 ms | 0,74 ms |
Com in (select …), o planner perde o valor único para buscar no índice e passa a checar a política linha a linha contra a lista de memberships, o tenant mediano, com 534 faturas, custa tanto quanto o maior, com 267.023: 80 ms para uma lista que levaria 0,30 ms. Reescrever como = any (array(select …)) corrige o count, mas piora a busca das últimas 50 do maior tenant (158 ms), porque o plano passa a trazer todas as linhas por um bitmap e ordená-las em vez de percorrer o índice de trás para frente.
A versão que funcionou bem em todos os casos foi resolver a associação uma única vez, no início da requisição, e colocar o tenant escolhido numa variável de sessão, a política volta a comparar contra um valor só. A checagem de pertencimento sai da política e vai para o código que define a variável: uma consulta por requisição, não uma por linha.
O problema das funções não leakproof
O caso mais traiçoeiro do benchmark envolve lower() e LIKE, que não são leakproof. A documentação do PostgreSQL explica por quê:
O sistema aplicará as condições das políticas de segurança e das views de barreira de segurança antes de qualquer condição fornecida pelo usuário na própria consulta que contenha funções não leakproof, para evitar a exposição inadvertida de dados.
The system will enforce conditions from security policies and security barrier views before any user-supplied conditions from the query itself that contain non-leakproof functions, in order to prevent the inadvertent exposure of data.Documentação oficial do PostgreSQL 17, seção CREATE FUNCTION
Na prática: uma busca por lower(customer_email) = lower($1) que é instantânea sem RLS (0,21 ms no maior tenant, 0,19 ms no mediano) usa o índice só para filtrar o tenant sob a política, e depois avalia lower() linha a linha em todas as faturas desse tenant. O EXPLAIN mostrou Index Cond apenas em tenant_id, com o e-mail virando Filter e 89.005 linhas descartadas em cada um de três processos paralelos, as outras 267.015 linhas do maior tenant.
O resultado: 34 a 45 ms no maior tenant contra 0,38–0,40 ms no mediano, a mesma consulta que levava 0,2 ms vira um problema que só o cliente maior sente, e que um teste com tenants pequenos jamais revela. Adicionar tenant_id = $1 explicitamente na query não ajuda: ficou em 44,8 ms, porque a igualdade de uuid já estava sendo usada, o problema é a outra condição.
A correção real é tornar a condição leakproof. Uma coluna gerada armazenando lower(customer_email), indexada junto com tenant_id, trouxe o tempo de volta a 0,25 ms. Para buscas por prefixo com LIKE, os operadores de text_pattern_ops (~>=~ e ~<~) são leakproof, e escrever a faixa manualmente derrubou 22 ms para 0,30 ms. Marcar o próprio lower() como leakproof é tecnicamente possível, mas exige superusuário e é uma promessa sobre uma função de terceiros, a Now-Next descarta essa saída.
Como auditar isso no seu banco
O material traz duas checagens que qualquer DBA deveria rodar antes de confiar numa política de RLS em produção:
- Buscar políticas cuja expressão chama uma função
VOLATILE, cruzandopg_policiescompg_procporprovolatile = 'v', toda política encontrada aí merece ser declaradaSTABLE. - Rodar
EXPLAINnas telas mais lentas conectado como o papel da aplicação, não como dono da tabela. Uma condição que aparece comoIndex Condpara o dono e viraFilterpara a aplicação é exatamente este problema de leakproof.
A própria Now-Next lista o que ficou fora do escopo: PostgreSQL 18, cache frio, tabelas maiores que a memória, políticas com WITH CHECK em escritas e modelos de membership mais complexos com papéis por tenant. As medições vieram de uma única máquina com configuração padrão, leia-as como proporções, não como SLA. Para quem decide arquitetura multi-tenant agora, a lição é menos sobre descartar RLS e mais sobre tratá-lo como qualquer outra cláusula WHERE: o plano de execução, não a intenção da política, é quem manda.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Disco Azure acima de 4 TiB desliga cache e engana quem otimiza Postgres
Disco Azure acima de 4 TiB desliga cache e engana quem otimiza Postgres