Toda SaaS com mais de um cliente trava seis decisões no PostgreSQL
Um levantamento do blog Now-Next mediu o que faltava nesse debate: quanto custa restaurar um tenant sozinho e em que ponto exato o schema-per-tenant quebra o backup.
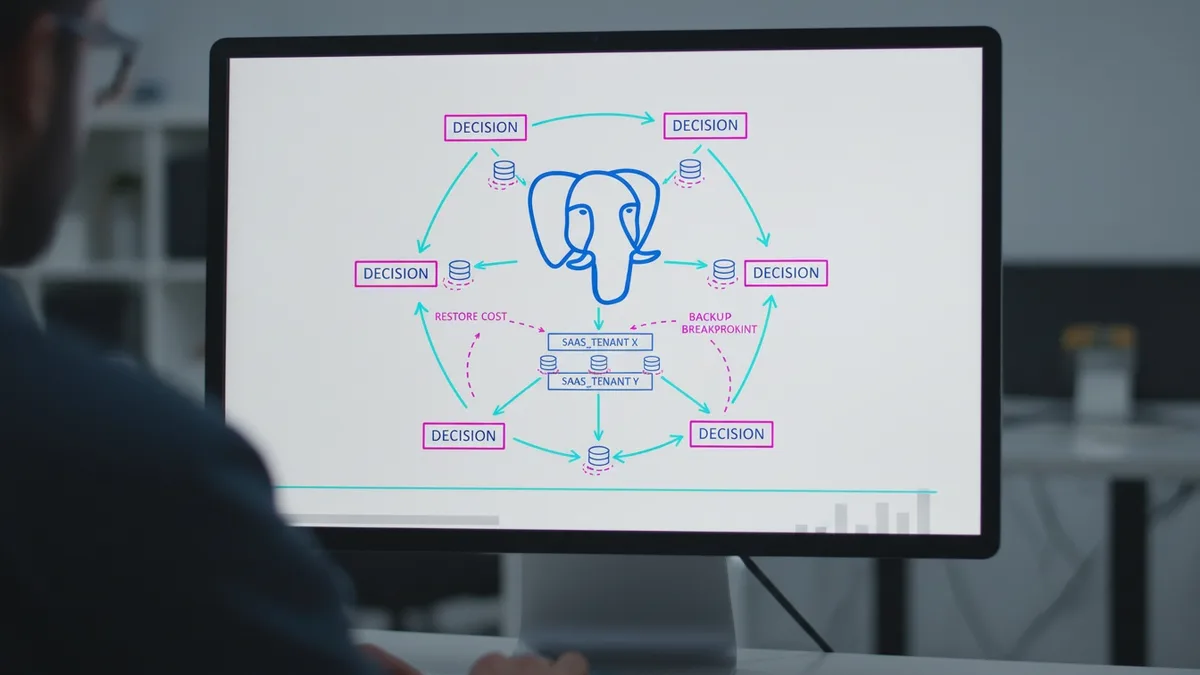
Um levantamento do blog Now-Next mediu o que faltava nesse debate: quanto custa restaurar um tenant sozinho e em que ponto exato o schema-per-tenant quebra o backup.
Todo produto SaaS que passa a ter mais de um cliente na mesma base de dados trava, sem perceber, seis decisões de design no PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data →. Quatro delas o mercado já discute (isolamento, separação, índices, tipo de coluna para dinheiro). As outras duas quase nunca aparecem em artigo nenhum porque exigem medição, não opinião: quanto custa restaurar um único tenant, e em que ponto o modelo schema-per-tenant deixa de escalar. É exatamente isso que o blog Now-Next foi medir e publicou no Planet PostgreSQL, com testes rodados em 21 de setembro de 2026 sobre PostgreSQL 17.11 em configuração padrão.
O recorte interessa a quem constrói SaaS multi-tenant desde a primeira migration, porque das seis decisões só duas são reversíveis sem dor depois. As outras quatro são decisões de schema que exigem migração sobre dados de produção para desfazer, e é por isso que elas pertencem à primeira semana do projeto, não ao segundo ano, quando já existem clientes de verdade dependendo do resultado.
Isolamento: banco, schema ou coluna tenant_id
A primeira decisão é o modelo de isolamento: um banco por tenant, um schema por tenant, ou tabelas compartilhadas com uma coluna tenant_id. Segundo a análise, a escolha quase sempre recai sobre tabelas compartilhadas: é o modelo mais barato de operar e escala mais do que a maioria das equipes espera. Banco por tenant só se justifica quando um cliente exige contratualmente sua própria instância ou precisa escolher seu próprio ponto de recuperação. Schema por tenant parece o meio-termo óbvio e raramente é, a razão aparece mais adiante, na decisão seis, e é a parte mais contraintuitiva do artigo.
Essa decisão não é revisável sem migração completa sobre os dados de todos os tenants. Escolher errado aqui não é um bug de performance, é reconstruir o schema inteiro em produção.
Separação não é a coluna, é o filtro
Com tabelas compartilhadas, o tenant_id não é a separação: o filtro sobre ele é. Um filtro esquecido é vazamento de dados de um cliente para outro. A saída é mover esse filtro para dentro do banco com row-level security, usando ENABLE ROW LEVEL SECURITY e, crucialmente, FORCE ROW LEVEL SECURITY, sem o FORCE, o dono da tabela ignora a própria política, e é justamente a conta de aplicação que costuma ser dona das tabelas.
O ponto que a análise destaca é que RLS é mais fácil de estar desligado do que ligado: um contexto de tenant vazio se torna '' em vez de NULL depois de um RESET, e uma chave estrangeira simplesmente não passa pela política. São falhas silenciosas, não erros que aparecem em log.
Índice: tenant_id na frente do composto
A terceira decisão é sobre índices, e é a única das seis ajustável sem dor num produto em produção, via CREATE INDEX CONCURRENTLY. A regra é simples: tenant_id vai na frente de todo índice composto usado para ler dados do tenant. O motivo não é só velocidade, é o que faz o RLS não custar nada extra. No teste, sobre 200 mil faturas das quais 2.003 pertenciam a um tenant, a condição da política aparece no plano de execução como Index Cond dentro de um Bitmap Index Scan, com o WHERE da própria query rodando depois, como Filter. Ou seja: a política de segurança some no plano, ela não soma um filtro adicional.
Dinheiro: numeric ou bigint, nunca ponto flutuante
A quarta decisão, parcialmente reversível, é o tipo de coluna para valores monetários. A recomendação é numeric com precisão e escala explícitas para a maioria dos produtos, ou um número inteiro de centavos em bigint quando os valores são principalmente somados e trafegam de e para um provedor de pagamento. Ficam fora real e double precision, que não são exatos, e o tipo money, que não guarda fração de centavo e amarra suas casas decimais à configuração lc_monetary do servidor, um detalhe que muda comportamento dependendo de onde o banco está instalado.
O que custa restaurar um tenant sozinho
Aqui está a parte que a maioria dos artigos sobre multi-tenant nunca mede: o que fazer quando um cliente liga dizendo que algo foi apagado, ou quando um cliente sai e pede os dados de volta. pg_dump, mesmo na versão 17.11, tem --table, --exclude-table e --filter, mas todos selecionam objetos, não linhas, não existe --where. Com tabelas compartilhadas, o backup de um único tenant não existe como ferramenta pronta; é preciso escrevê-lo.
A boa notícia é que escrever esse export é rápido: numa base com 200 mil faturas e 200 mil linhas de fatura espalhadas por 100 tenants, exportar as 2.000 faturas e 2.000 linhas de um único tenant levou 0,10 segundo com três comandos COPY. Recarregar levou 0,15 segundo. O truque prático, sugerido no artigo, é gerar os comandos de exportação a partir do catálogo:
select format('\copy (select * from %I where tenant_id = :tenant) to ''/tmp/%s.csv'' csv',
 table_name, table_name)
from information_schema.columns
where column_name = 'tenant_id' and table_schema = 'public'
order by table_name;
E, em seguida, perguntar o que realmente importa: quais tabelas ficam fora desse export, porque não têm tenant_id, no teste, a única tabela fora foi a que descreve o próprio tenant, resultado esperado. Qualquer outro nome que aparecer nessa lista é uma tabela que alguém precisa conseguir explicar.
A surpresa: apagar custa 182 vezes mais que restaurar
O dado que quebrou a expectativa dos autores foi outro: apagar aquele mesmo tenant (2.000 faturas e 2.000 linhas, dentro de tabelas com 200 mil linhas) levou 21,8 segundos, medidos duas vezes. Carregar de volta havia levado 0,15 segundo.
A causa não está nas linhas, está numa chave estrangeira sem índice. invoice_lines.invoice_id referencia invoices.id, e a tabela tinha índice em tenant_id e na própria chave primária, mas não em invoice_id. Para cada fatura apagada, o PostgreSQL precisa varrer toda a tabela invoice_lines para checar se alguma linha ainda referencia aquele id. Duas mil vezes, sobre duzentas mil linhas. A documentação do PostgreSQL avisa isso explicitamente: a declaração de uma foreign key não cria automaticamente um índice na coluna que referencia, porque nem sempre é necessário e há várias formas de indexar. Neste caso, era necessário e ninguém tinha percebido, porque nenhuma consulta de leitura do produto precisava desse índice.
Criar o índice levou 0,14 segundo. O mesmo delete depois, 0,12 segundo, de 21,8 segundos para 0,12, um fator de 182 vezes, através de um índice que nenhuma query de leitura pedia. É exatamente o tipo de custo que aparece na noite em que um cliente liga, e a checagem para achar chaves estrangeiras sem índice correspondente pode ser feita antes desse dia, consultando pg_constraint e pg_index.
Com banco por tenant ou schema por tenant, essa pergunta inteira desaparece: apagar um tenant é DROP DATABASE ou DROP SCHEMA ... CASCADE, e no teste isso levou 0,10 segundo para um schema com dez tabelas. É a vantagem real desses dois modelos, e a única que a análise conseguiu medir de forma honesta.
Onde o schema-per-tenant quebra
Schema por tenant costuma vir recomendado com a ideia de que o PostgreSQL lida bem com "alguns milhares de schemas". Esse número circula sem medição embaixo, e foi isso que os autores testaram: schemas com dez tabelas cada, subindo até 2.000 schemas (20.000 tabelas) no PostgreSQL 17.11 com configuração padrão.
O resultado não é que fica lento, cada etapa cresceu de forma linear, e uma migração via ALTER TABLE sobre 2.000 tenants custou pouco mais de um segundo. O resultado é que o backup para de funcionar. Em 1.200 schemas, pg_dump --schema-only ainda funcionava. Em 1.300 schemas (algo entre 12.068 e 13.068 tabelas), ele falhava com:
pg_dump: error: query failed: ERROR: out of shared memory
HINT: You might need to increase "max_locks_per_transaction".
O motivo está na documentação: a tabela de locks compartilhados tem espaço para max_locks_per_transaction objetos por processo de servidor, e pg_dump trava cada tabela que exporta dentro de uma única transação. Com os padrões (max_locks_per_transaction 64, max_connections 100), há espaço para cerca de 6.400 objetos, número que não é exato porque depende de configuração e do que mais o servidor está fazendo, o que torna o limite real difícil de planejar com antecedência.
E o conserto é mais caro do que parece: max_locks_per_transaction só pode ser alterado na inicialização do servidor. No teste, um ALTER SYSTEM SET max_locks_per_transaction = 256 deixou pending_restart marcado como verdadeiro, e um pg_reload_conf() não mudou nada, o mesmo pg_dump voltou a falhar até o banco ser reiniciado. Corrigir o backup, portanto, exige reiniciar o banco de produção, o que numa plataforma gerenciada significa negociar uma janela de manutenção com clientes na mesma noite em que se descobriu que não havia backup.
Quatro consultas para rodar hoje
A análise fecha com um roteiro de quinze minutos que qualquer time pode aplicar na base atual: quais tabelas com coluna de tenant não têm política de RLS; se o FORCE está ativo e a role de aplicação não é a dona das tabelas; quais tabelas ficam fora de um export por tenant; e quais chaves estrangeiras não têm índice na coluna que referencia. As duas últimas, segundo os autores, praticamente nunca são feitas, e foi rodando exatamente essa checagem que encontraram o índice ausente que separava 0,12 segundo de 21,8 segundos.
Para quem projeta uma SaaS multi-tenant do zero, o recorte prático é este: das seis decisões, isolamento e enforcement de separação exigem escolha correta na primeira migration, porque corrigir depois é reconstruir schema sobre dados reais; índice e tipo monetário toleram ajuste incremental; e restaurar ou apagar um tenant, além da escala de schemas, são operações que só revelam seu custo real sob medição, não sob suposição de que "o PostgreSQL aguenta".
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
PostgreSQL: max_parallel_workers não faz o que o nome sugere
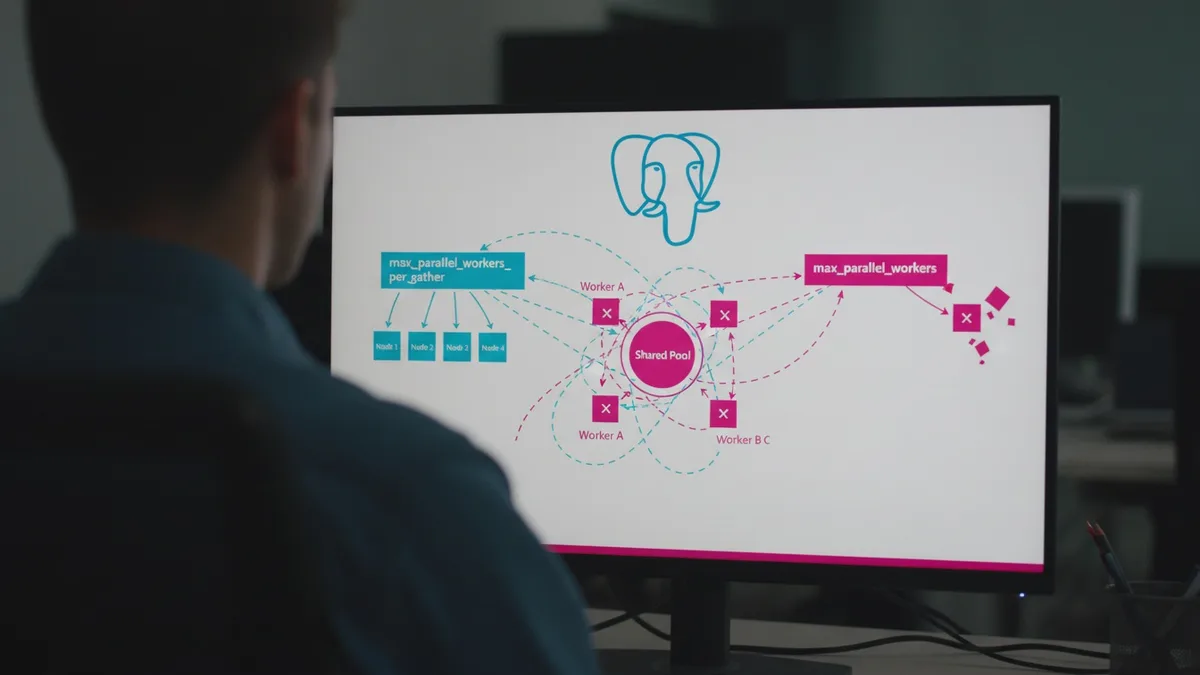
Christophe Pettus destrincha dois GUCs de paralelismo que todo DBA configura errado ao menos uma vez: um governa por nó do plano de execução, o outro disputa um pool compartilhado sem avisar ninguém.