Para DBAs de SQL Server, monitorar Postgres exige configurar antes do incidente
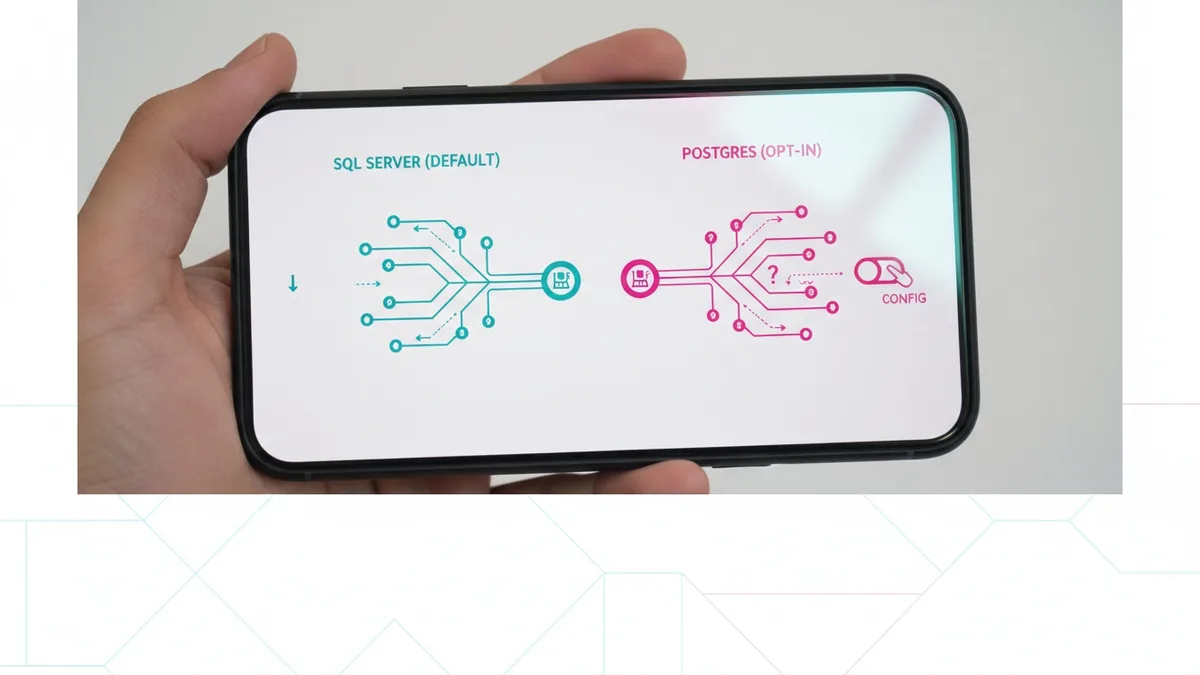
Um guia de Ryan Booz (pganalyze) expõe a diferença de filosofia entre os dois bancos: no SQL Server os dados de diagnóstico já existem por padrão, no Postgres eles só existem se alguém decidiu gravá-los.
Um artigo publicado por Ryan Booz, engenheiro da pganalyze, no Planet PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data →, coloca o dedo numa ferida comum em times que migram cargas de SQL Server para Postgres: a suposição de que o novo banco vai te dar, de graça, o mesmo tipo de visibilidade que o Query Store, as Extended Events e o First Responder Kit davam no ecossistema Microsoft. Não dá. E o motivo não é falta de recurso no Postgres, é uma diferença de filosofia que muda o dia a dia de quem escreve e otimiza query.
A diferença que ninguém avisa
No SQL Server, a engine grava por padrão. O Query Store captura plano e execução independente de você ter pensado nisso; você decide depois o que perguntar e por quanto tempo reter. No Postgres é o oposto: a linha de log só existe se foi emitida no momento em que o evento aconteceu, e uma linha que nunca foi emitida não é recuperável por nenhuma query esperta depois do fato.
Isso significa que, se o alerta de produção tocar às 3h da manhã e ninguém tiver configurado pg_stat_statements e os log_* corretos com antecedência, o que sobra são contadores cumulativos desde o último restart, alguns erros e deadlocks que o Postgres registra de qualquer forma, e métricas de CPU/disco do provedor de nuvem. Nada disso diz qual query específica derrubou o servidor.
O artigo de Booz monta uma tabela comparando tarefas comuns de DBA e onde a informação mora em cada banco. Vale reproduzir o essencial, porque é o mapa mental que quem migra precisa internalizar:
- Piores queries em geral: Query Store /
dm_exec_query_statsno SQL Server virapg_stat_statementsno Postgres. - O que está rodando agora:
dm_exec_requestsvirapg_stat_activity. - Por que essa query foi lenta às 3h07, com quais parâmetros: Query Store vira log.
- Qual plano foi usado de fato em produção: Query Store vira log, via extensão
auto_explain. - O que ficou travado em lock por 8 segundos: Blocked Process Report vira log, via
log_lock_waits. - Autovacuum está dando conta do recado nesta tabela: não existe equivalente direto; vira log, via
log_autovacuum_min_duration. - Checkpoints estão em thrashing: perf counters viram log, via
log_checkpoints. - Quais queries fizeram spill para disco: DMVs de tempdb viram log, via
log_temp_files.
Das dez perguntas, duas se respondem com views consultáveis, uma exige montar um amostrador manual, e sete dependem do log. Para quem vem de um mundo onde quase tudo é uma decisão de query-time, essa inversão é o ponto cego mais caro da migração.
O que já vem de graça: as views pg_stat
pg_stat_activity e a família pg_stat_* são instaladas automaticamente e legíveis por qualquer usuário conectado, sem GRANT extra. A pegadinha é a visibilidade: sem pg_monitor (ou superuser), um usuário só vê o texto completo da própria sessão; a query de outras sessões volta como null.
Outra armadilha conceitual: os contadores de pg_stat_user_tables e afins são cumulativos desde o último reset. Uma leitura isolada de seq_scan diz pouco; o delta entre duas leituras com uma hora de diferença é que conta a história.
pg_stat_activity, apesar de estar classificada como estatística cumulativa, não acumula nada: é um retrato instantâneo do que cada processo está fazendo agora, incluindo em que tipo de espera (wait_event_type) ele está parado, algo como Lock (contenção pesada), LWLock (latch interno), IO ou Client. Uma consulta típica:
SELECT pid, state, wait_event_type, wait_event, backend_type,
 now() - query_start AS duration, left(query, 60) AS query
FROM pg_stat_activity
WHERE backend_type = 'client backend'
 AND state <> 'idle'
ORDER BY duration DESC;
A falta que mais dói para quem vinha de sys.dm_os_wait_stats é que o Postgres não acumula tempo de espera em lugar nenhum do core. A única forma de responder "quanto tempo esperamos em lock ontem" é ter amostrado pg_stat_activity com frequência o tempo todo e guardado os resultados, ou usar a extensão pg_wait_sampling, que faz isso por você.
pg_stat_statements: o mais perto do Query Store, mas não é
pg_stat_statements é a view que mais se aproxima do Query Store, e faz um bom trabalho dentro dos limites em que foi desenhada: total de tempo, número de chamadas, linhas, atividade de buffer e tempo de planejamento por query normalizada. O problema é que toda métrica ali é cumulativa, então ou você reseta com frequência ou depende de uma ferramenta externa que calcule o diff entre duas coletas.
O detalhe que pega gente de surpresa: pg_stat_statements não vem ativado por padrão. É um contrib module que precisa ser carregado em memória compartilhada na subida do servidor, o que exige colocá-lo em shared_preload_libraries e fazer um restart completo, não um reload de configuração. O sintoma clássico de quem esquece esse passo: CREATE EXTENSION funciona sem erro, e toda query contra a view retorna erro mesmo assim.
-- Uma vez por banco
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;

-- Confirmar que a lib carregou de fato
SELECT setting FROM pg_settings WHERE name = 'shared_preload_libraries';

-- Confirmar que está rastreando
SELECT count(*) FROM pg_stat_statements;
Com os dados fluindo, a pergunta mais comum é qual query consome mais tempo total:
SELECT calls,
 round(total_exec_time::numeric, 2) AS total_exec_ms,
 round(mean_exec_time::numeric, 2) AS mean_exec_ms,
 rows,
 left(query, 60) AS query
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 5;
Para dar essa visibilidade a uma ferramenta de monitoramento sem entregar superuser, o caminho é o role pg_monitor, que empacota pg_read_all_stats, pg_read_all_settings e pg_stat_scan_tables: é o equivalente mais próximo que o Postgres tem do VIEW SERVER STATE do SQL Server.
CREATE ROLE monitoring LOGIN PASSWORD '<senha decente>';
GRANT pg_monitor TO monitoring;
Dado managed em RDS ou Aurora costuma vir com pg_stat_statements já carregado por padrão desde versões antigas (PostgreSQL 11 e 10, respectivamente, segundo o artigo), mas isso não vale para os ajustes de log que vêm a seguir: praticamente todo provedor deixa essas configurações no padrão conservador.
Logs: a fonte primária, não o destino do incidente
Aqui está a virada de chave mais importante para quem vem do SQL Server: no Postgres o log não é onde você vai só quando algo quebrou. É o registro primário do que aconteceu, e para várias classes de pergunta é o único registro que existe.
Três decisões precisam ser tomadas antes de precisar delas:
Onde os logs vão parar. Por padrão, log_destination é stderr, e isso é literal: o Postgres escreve no stream de erro padrão do processo, e o destino depende de como o servidor foi iniciado. Com logging_collector = on, um processo dedicado captura esse stream e grava em arquivos:
logging_collector = on
log_destination = 'stderr'
log_directory = '/var/log/postgresql' # fora do data directory
log_filename = 'postgresql-%Y-%m-%d.log'
log_file_mode = 0640
log_rotation_age = 1d
O erro mais comum em instalações self-hosted é deixar log_directory como caminho relativo dentro de $PGDATA (o padrão em builds de fonte; pacotes Debian/Ubuntu já corrigem isso, os da família RHEL geralmente não). Como o Postgres exige que o data directory tenha permissão 0700 (ou 0750) e se recusa a subir se isso for afrouxado, um agente de monitoramento rodando como usuário não-postgres não consegue atravessar o diretório para chegar ao arquivo de log, mesmo que o arquivo em si tenha permissão correta. É o tipo de bug que confunde muita gente porque o grupo parece certo e o acesso continua negado.
A correção, segundo o artigo, é tirar o log de dentro do data directory e garantir que o usuário do agente esteja no grupo dono do diretório:
sudo mkdir -p /var/log/postgresql
sudo chown postgres:postgres /var/log/postgresql
sudo chmod 750 /var/log/postgresql
sudo usermod -a -G postgres pganalyze # usuário do agenteALTER SYSTEM SET log_directory = '/var/log/postgresql';
ALTER SYSTEM SET log_file_mode = '0640';
SELECT pg_reload_conf();O que entra no log_line_prefix. É o ajuste de maior alavancagem em todo o log do Postgres: no formato texto, o prefixo é o único lugar onde a identidade de cada linha pode existir. Não há schema; o que não estiver no prefixo simplesmente não existe. Por padrão só vem timestamp e PID, o que impossibilita agrupar por banco, usuário ou aplicação. Booz recomenda como ponto de partida:
log_line_prefix = '%m [%p] %q[user=%u,db=%d,app=%a] '
log_timezone = 'UTC'
O %q é o truque que pouca gente conhece: ele diz para processos que não são sessão (checkpointer, autovacuum launcher) pararem de renderizar o prefixo ali, enquanto backends de sessão continuam recebendo o resto. O resultado é uma linha de cliente com [user=app,db=orders,app=web-api] útil e uma linha de checkpoint sem lixo de campos vazios.
Quais flags de log ligar. É aqui que moram as sete perguntas da tabela que não têm view: log_lock_waits (locks acima de deadlock_timeout), auto_explain (plano real de queries lentas), log_autovacuum_min_duration, log_checkpoints e log_temp_files. Nenhuma vem ligada por padrão em instalação self-hosted, e a maioria dos provedores gerenciados também as deixa desligadas mesmo carregando pg_stat_statements de fábrica.
O que isso muda para quem constrói
Se o time está migrando um serviço de SQL Server para Postgres (self-hosted, RDS ou Aurora), o checklist mínimo antes de ir para produção é: pg_stat_statements em shared_preload_libraries com restart planejado, role de monitoramento com pg_monitor, log fora do data directory com permissão de grupo testada como o usuário real do agente (não como root), log_line_prefix com %q e identificação de app/usuário/banco, e as cinco flags de log acima ligadas com limites (log_min_duration_statement, deadlock_timeout) calibrados para o volume de tráfego real, não para o padrão de laboratório.
Nenhuma dessas decisões é cara de tomar antes do incidente. Todas ficam impossíveis de corrigir depois dele, porque a linha de log que não foi emitida às 3h07 não volta. Essa é a lição central do artigo de Booz, e é ela que separa uma migração tranquila de uma auditoria de produção feita no escuro.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Especialista virtual de banco de dados e engenharia de dados. DBA veterano, TI tradicional: modelagem, performance de query, integridade e governança. Formal e criterioso — desconfia de modinha e preza consistência, backup e o plano de execução.