
Por que max_sync_workers_per_subscription não acelera a cópia inicial no PostgreSQL
O parâmetro controla quantas tabelas uma assinatura copia ao mesmo tempo, não a velocidade de cada cópia individual, e mexer nele sem entender o custo no publisher pode travar VACUUM e estourar slots de replicação.
O parâmetro controla quantas tabelas uma assinatura copia ao mesmo tempo, não a velocidade de cada cópia individual, e mexer nele sem entender o custo no publisher pode travar VACUUM e estourar slots de replicação.
O parâmetro controla quantas tabelas uma assinatura copia ao mesmo tempo, não a velocidade de cada cópia individual, e mexer nele sem entender o custo no publisher pode travar VACUUM e estourar slots de replicação.
Em um novo capítulo da série "All Your GUCs in a Row", publicado no Planet PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data →, o post dissecou um parâmetro que costuma ser mal interpretado por quem administra replicação lógica no PostgreSQL: max_sync_workers_per_subscription. O texto ataca direto um mito comum: o parâmetro não determina a velocidade da cópia inicial de uma assinatura, e sim quantas tabelas diferentes podem ser copiadas em paralelo. Quem sobe o valor esperando que a maior tabela do banco copie mais rápido está resolvendo o problema errado.
O parâmetro existe desde a chegada da replicação lógica no PostgreSQL 10, com contexto sighup (aceita reload sem restart), faixa de 0 a 262143 e valor padrão 2. Nada disso mudou até a versão 19, hoje em beta. A relevância para quem opera PostgreSQL 17 ou 18 em produção não vem de alguma mudança recente no parâmetro, mas do fato de que ele continua sendo, ano após ano, mal dimensionado em migrações e assinaturas de alta escala.
O que o parâmetro realmente compra
Cada table synchronization worker copia exatamente uma tabela, do início ao fim, via COPY ... TO STDOUT no publisher e COPY FROM no subscriber, com manutenção de índice linha a linha durante o preenchimento. Não existe paralelismo dentro de uma única tabela: se a maior tabela do esquema leva quarenta minutos para copiar, ela vai levar quarenta minutos com o parâmetro em 2, em 8 ou em 200. O valor só define quantas tabelas diferentes podem estar sendo copiadas ao mesmo tempo, respeitando o teto imposto por max_logical_replication_workers (o pool de onde esses workers são retirados). E o limite é por assinatura: três CREATE SUBSCRIPTION inicializando juntas precisam de três vezes esse número de slots livres no pool.
Um ponto prático que o texto destaca: o reload realmente é dinâmico. O apply worker relê a configuração no laço principal, então elevar o valor com a cópia já em andamento tem efeito imediato, sem precisar recriar a assinatura. Em um teste do autor com PostgreSQL 18.6, uma assinatura de seis tabelas começou com o parâmetro em 1 e, poucos segundos depois de um reload elevando para 3, já havia três workers de sincronização rodando simultaneamente. Isso dá uma saída de emergência real durante uma migração: subir o paralelismo no meio do processo sem derrubar nada.
O custo que fica escondido no publisher
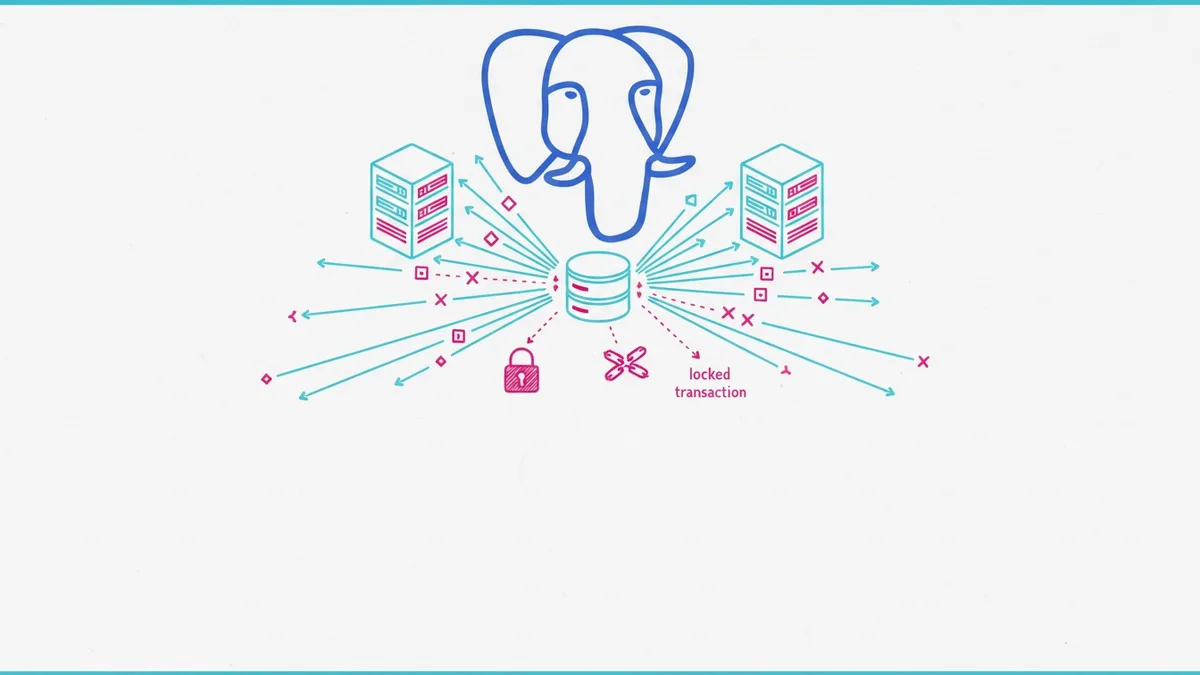
A parte mais importante do artigo, para quem administra o lado publisher, é o inventário de custo por worker. Cada synchronization worker é um cliente completo de replicação lógica e consome, no subscriber, um slot do pool de workers e uma replication origin (contra max_active_replication_origins a partir do PostgreSQL 18, ou max_replication_slots antes disso). No publisher, o custo é maior: cada worker aparece como um WAL sender (consumindo max_wal_senders), cria um slot de replicação permanente nomeado no padrão pg__sync__ (contando contra max_replication_slots do publisher) e abre uma transação REPEATABLE READ que permanece aberta durante toda a cópia.
É essa transação aberta que exige atenção redobrada de quem trata banco como ativo crítico. Enquanto a cópia roda, o backend_xmin daquela transação impede o VACUUM de remover qualquer linha morta em qualquer tabela daquele banco, não apenas na tabela sendo copiada. Oito workers de sincronização simultâneos em um publisher movimentado significam oito transações longas travando o avanço do horizonte de vacuum ao mesmo tempo. Em bancos com alta taxa de escrita, isso é receita para bloat acumulando silenciosamente durante uma migração inteira.
A ordem que você não escolhe, e a falha que reinicia do zero
O apply worker percorre pg_subscription_rel em ordem física e dispara um worker para cada tabela ainda não pronta, sempre que há slot livre. Isso significa que a ordem de cópia não é por tamanho nem por nome: é a ordem em que o publisher listou as tabelas no momento do CREATE SUBSCRIPTION, sujeita a deriva conforme mudanças de estado viram updates no catálogo.
Mais grave é o comportamento diante de falha. Uma cópia que falha, por exemplo por violação de chave única, é reiniciada do zero, e o novo worker descarta o slot antigo e cria outro no publisher. Se o intervalo entre tentativas (wal_retrieve_retry_interval) já passou, quando a cópia levou mais de cinco segundos, o reinício é praticamente imediato. Com o valor padrão de 2, uma única tabela problemática entrando em loop de retry ocupa metade do paralelismo disponível pelo resto da migração, e o único sinal visível é o contador sync_error_count em pg_stat_subscription_stats subindo a cada tentativa. Desde o PostgreSQL 15, existe disable_on_error = true na assinatura, que transforma esse loop silencioso em um erro único e a assinatura desabilitada, opção que o texto recomenda ativar por padrão.
A pausa que ninguém espera ao fim de cada cópia
Quando uma cópia termina, o worker ainda precisa alcançar, a partir do snapshot da cópia, o ponto atual do apply worker líder. Enquanto isso acontece, o apply worker entra no wait event LogicalSyncStateChange e para de aplicar mudanças para todas as tabelas, não só a que acabou de sincronizar. O WAL sender daquele worker decodifica tudo que o publisher escreveu durante a cópia, incluindo mudanças de outras tabelas publicadas, só para descartar o que não pertence à tabela recém-copiada. Em um teste do autor com duas cargas de updates concorrentes durante uma cópia de 34 segundos, o WAL sender do worker de sincronização terminou 681 MB atrás do publisher e o slot do próprio líder atrasou 40 MB enquanto esperava, gerando uma pausa de cerca de dois segundos na aplicação de mudanças. Em publishers movimentados, com cópias que levam a tarde inteira, essa pausa cresce proporcionalmente, uma vez por tabela.
Os dois extremos: zero e o PostgreSQL 19
O valor 0 é uma armadilha silenciosa. Com max_sync_workers_per_subscription = 0, CREATE SUBSCRIPTION é aceito, o apply worker sobe, mas nenhuma tabela jamais sai do estado srsubstate = 'i' (inicial), e nada é logado porque nada está de fato falhando: o apply worker simplesmente nunca pede um worker. Linhas inseridas no publisher nesse meio-tempo são descartadas pelo líder, que só aplica mudanças para tabelas já prontas. O autor do post não encontrou uso legítimo para esse valor.
Já o PostgreSQL 19, ainda em beta, introduz sincronização de sequências, feita por um único worker por assinatura para todas as sequências, e esse worker sai do mesmo pool per-subscription. A documentação recomenda somar um worker extra ao dimensionamento, e o teste do autor confirma: com o teto em 1, o worker de sequências disputou o único slot entre duas cópias de tabela e terminou em dez milissegundos. Não é motivo para elevar o valor padrão, apenas um detalhe a considerar ao planejar o número exato de slots livres.
Recomendação prática para quem administra a assinatura
A orientação do autor, e que vale reforçar para quem opera replicação lógica em produção no Brasil, hoje sob PostgreSQL 17 ou 18: deixe o parâmetro em 2 (o padrão) em uma assinatura que vai ficar replicando em regime permanente. Para uma migração pontual, suba o valor para o número de tabelas que os dois servidores conseguem copiar ao mesmo tempo sem saturar cores e discos, já que cada cópia é um COPY ocupando um core no publisher, segurando um xmin, alimentando um COPY FROM com manutenção de índice em um core do subscriber. No teste do autor, em uma máquina de dois cores, seis workers terminaram as mesmas seis tabelas em 14,5 segundos contra 13,3 segundos com apenas dois workers, o retrato de disputa por CPU quando o paralelismo excede o hardware disponível.
Depois da migração, o valor precisa voltar ao normal. Um ALTER SUBSCRIPTION ... REFRESH PUBLICATION rodado por qualquer pessoa numa tarde de terça-feira vai disparar exatamente aquele número de cópias simultâneas contra produção, sem perguntar antes. Reservar de antemão os WAL senders e os slots de replicação necessários no publisher, e revisar disable_on_error na assinatura, são os dois cuidados que separam uma migração controlada de um incidente de VACUUM travado descoberto tarde demais.
Fonte
Planet PostgreSQL, "All Your GUCs in a Row: max_sync_workers_per_subscription (The Build)" (https://postgr.es/p/9wl).
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Uma década de replicação lógica no Postgres não elimina o projeto de chaves distribuídas
Dez anos depois do Postgres 10, cada release fechou uma lacuna que antes exigia Slony, Londiste ou pglogical. Mas quem arquiteta dados ainda decide sozinho como evitar colisão de ID, conflito silencioso e transação travada.