PostgreSQL 19 ganha extensão que roda SPARQL sem precisar de um segundo banco
A extensão pg_knowledge_base embute o motor SPARQL do Oxigraph dentro do PostgreSQL 19, guardando triplas em tabelas comuns e lendo tabelas existentes como RDF via R2RML, tudo sob a mesma transação.

A extensão pg_knowledge_base embute o motor SPARQL do Oxigraph dentro do PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → 19, guardando triplas em tabelas comuns e lendo tabelas existentes como RDF via R2RML, tudo sob a mesma transação.
Quatro bancos não bastavam
No post anterior de Igor Suhorukov, publicado no Planet PostgreSQL, um amigo dele mantinha quatro bancos de dados em produção. Pedir a esse time um grafo de conhecimento, ele escreve, é fácil adivinhar o quinto sistema: um triple store para SPARQL.
O padrão é conhecido por qualquer DBA que já sustentou uma base de conhecimento ao lado de um banco relacional. Os fatos que o grafo precisa já estão em tabelas do PostgreSQL, então um job de ETL copia tudo como triplas, e a cópia envelhece assim que o job termina. Dois bancos significam dois modelos de segurança, dois cronogramas de backup, dois procedimentos de failover e nenhuma transação que cubra uma linha e uma tripla ao mesmo tempo.
Foi esse problema que Suhorukov atacou com o pg_knowledge_base, uma extensão para o PostgreSQL 19 que roda o motor SPARQL do Oxigraph dentro do próprio servidor, sem alterar o core.
Oxigraph embutido, sem threads próprias
Oxigraph é um banco de grafos e toolkit RDF escrito em Rust↳Rust7 conteúdosDesmistificando Rust: a linguagem segura e rápida que você precisa conhecerDev (Back & Front) · out 2024Como criar seu primeiro Programa em Rust com Solana PlaygroundDev (Back & Front) · mai 2026Rust no ranking: a segurança de memória perdeu a guerra corporativa?Marketing Tech · abr 2026Ver tudo em Dev (Back & Front) →.
Um banco de dados de grafos em conformidade, seguro e rápido.
a compliant, safe, and fast graph databaseObjetivo declarado do projeto Oxigraph
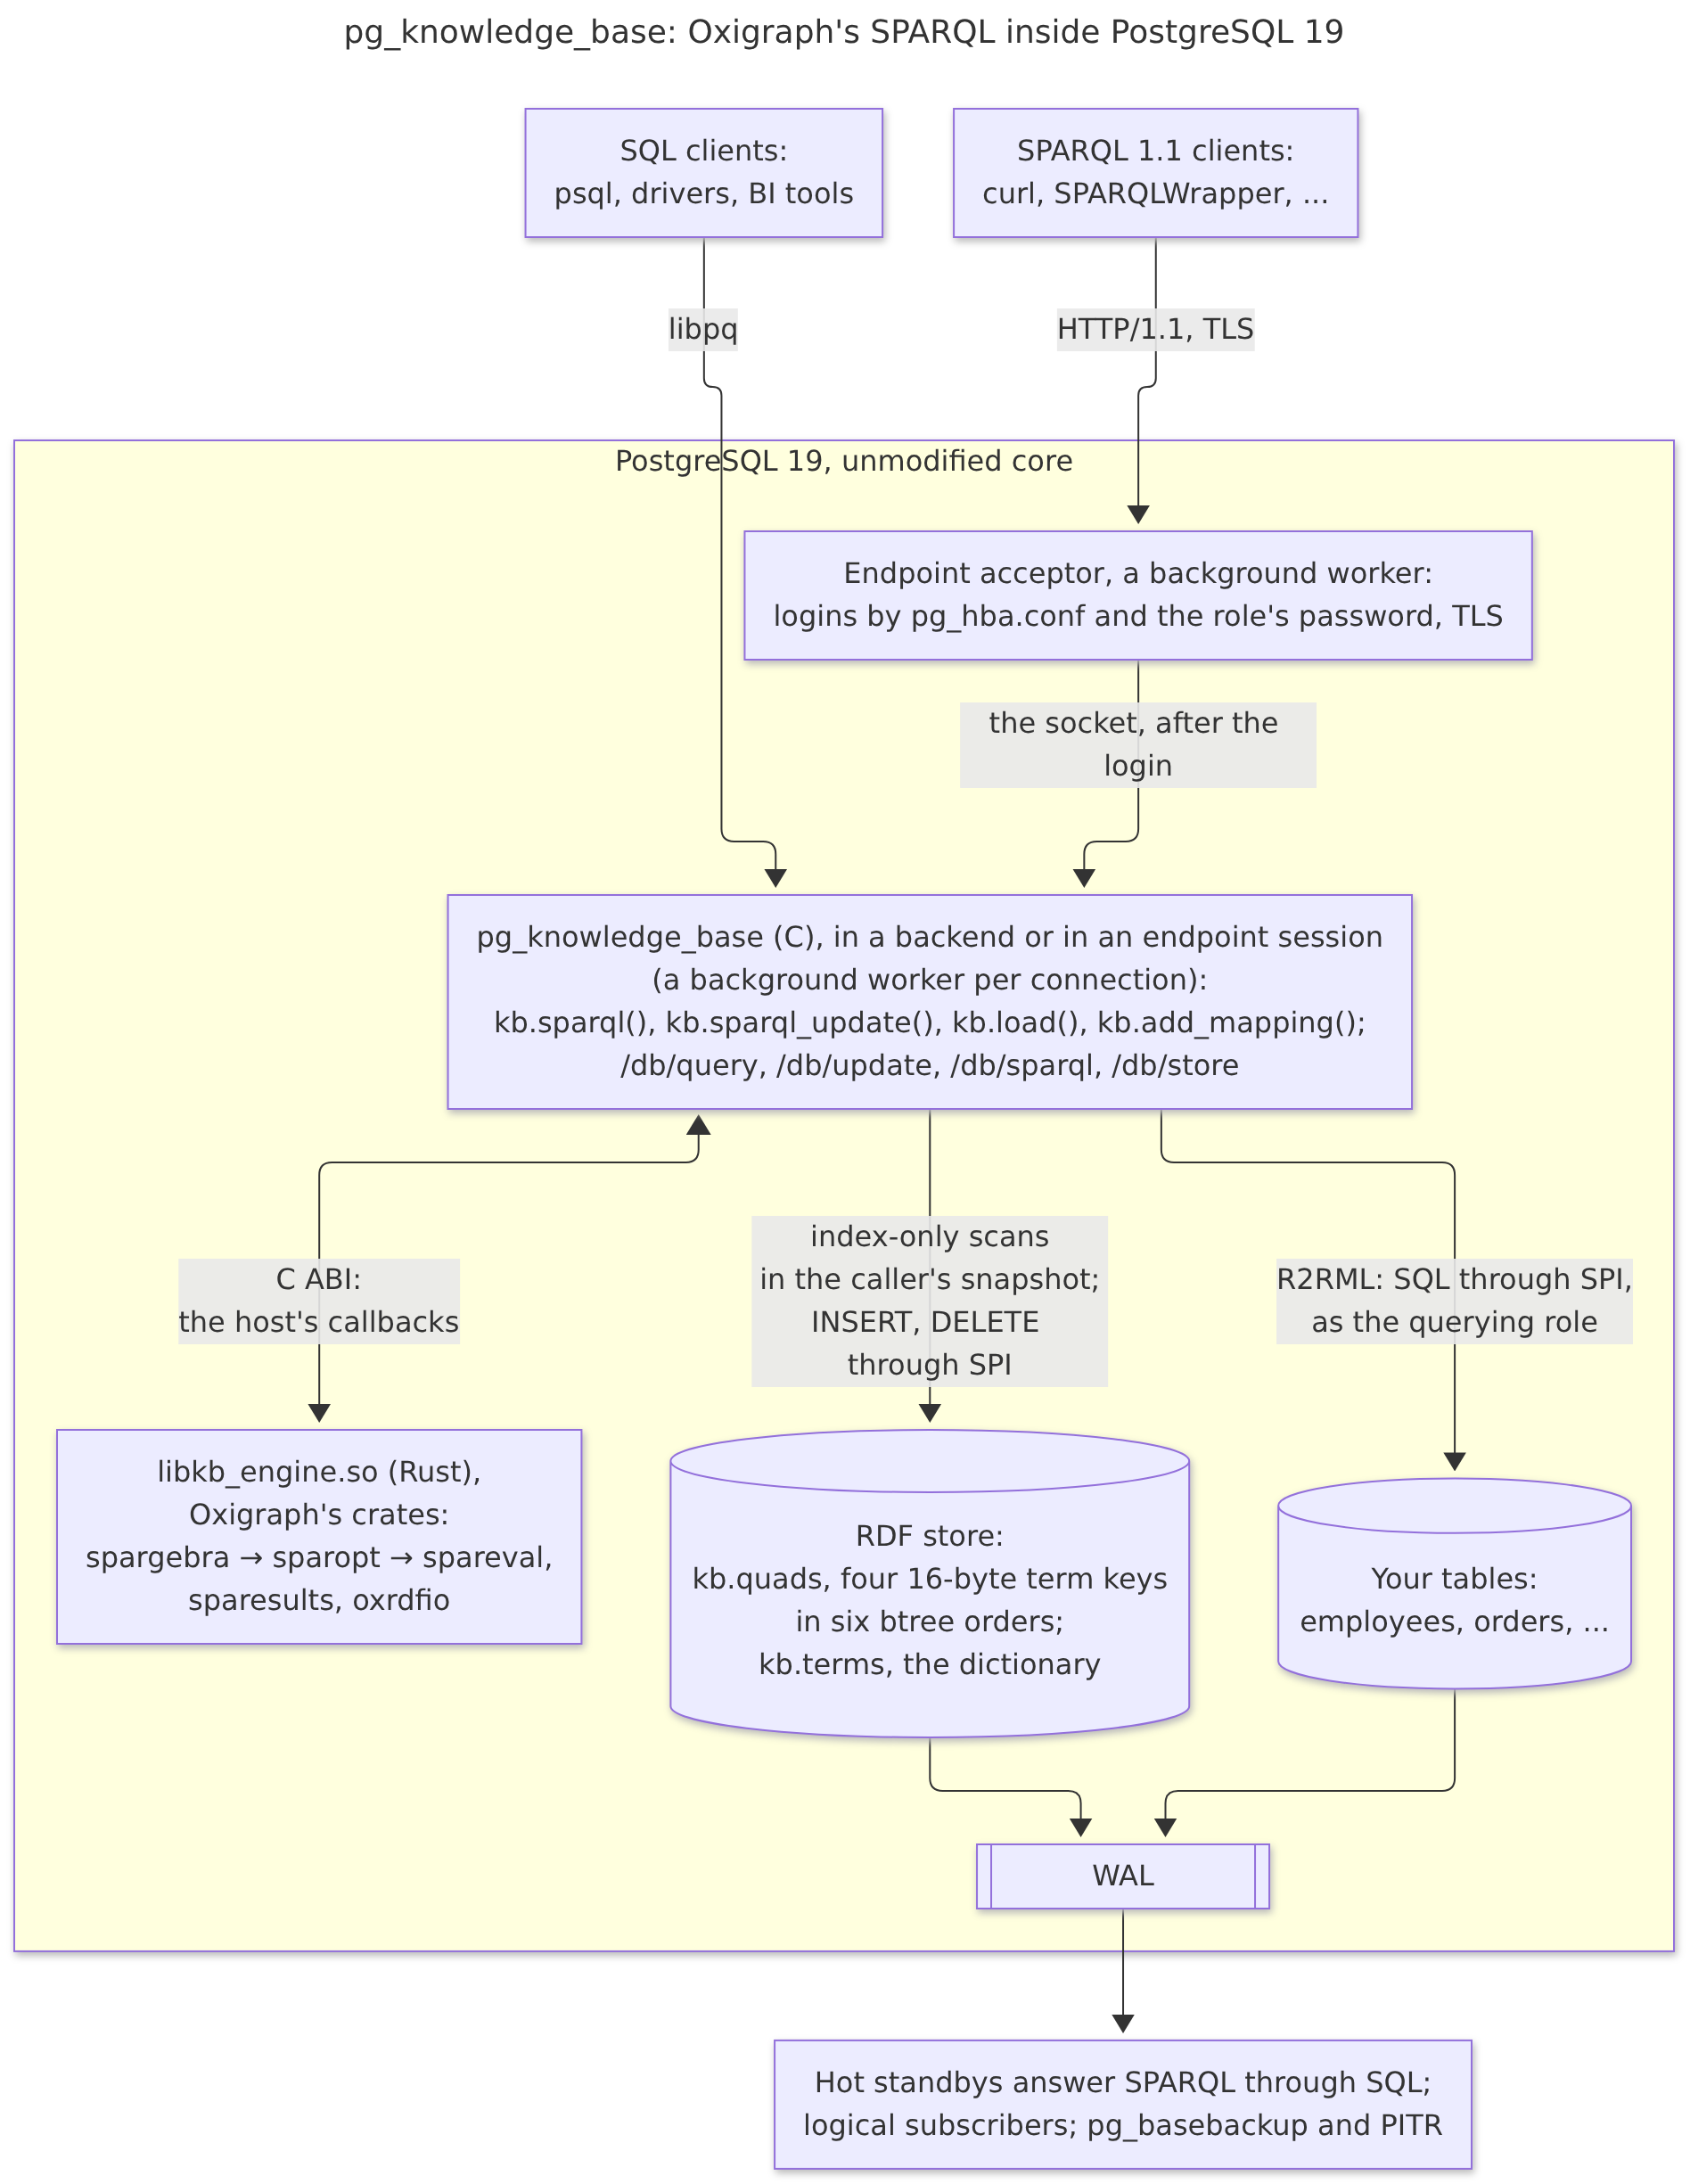
O que importa para embutir o motor é que sua pilha de consulta é dividida em crates pequenos: spargebra faz o parsing de SPARQL, sparopt otimiza, spareval avalia, e sparesults/oxrdfio cuidam dos formatos de resultado e RDF. Como spareval avalia sobre qualquer coisa que implemente sua trait QueryableDataset, o pg_knowledge_base reaproveita parser, otimizador e avaliador do Oxigraph e troca só o armazenamento: tabelas do PostgreSQL no lugar do RocksDB.
Na prática, libkb_engine.so é uma biblioteca Rust compilada a partir dos crates do Oxigraph atrás de uma ABI C; a extensão em si é C. Um backend carrega a biblioteca na primeira chamada SPARQL, e o motor roda na thread do próprio backend, sem iniciar threads próprias. Ele só alcança o PostgreSQL por callbacks (varrer o store, resolver termos, gravar quads, rodar o SQL do R2RML), cada uma dentro de PG_TRY, para que um erro do PostgreSQL nunca suba por dentro do Rust, e todo ponto de entrada captura panics, para que um panic do Rust nunca suba por dentro do C.
Manter o motor original mantém as respostas: dos testes W3C de SPARQL 1.1 (query e update), 990 passam e nenhum falha. Outros 11 divergem do esperado exatamente como o próprio store do Oxigraph diverge, principalmente porque literais tipados são mantidos como valores ("01"^^xsd:integer volta como 1), e 6 são pulados, como no test runner do próprio Oxigraph. Os testes W3C de R2RML e Direct Mapping passam 95 de 95.
Vale registrar, para quem audita código de infraestrutura crítica: Suhorukov diz que, como em suas extensões anteriores, foi o Claude Code quem escreveu a implementação, enquanto ele tomou as decisões de arquitetura e checou os resultados. Para uma peça que toca diretamente a camada de armazenamento, isso não dispensa revisão de código tradicional antes de qualquer produção.
As triplas moram em tabelas de verdade
O store é feito de tabelas comuns. kb.quads guarda cada quad (g, s, p, o) como quatro chaves de termo de 16 bytes em seis ordens btree, a versão do PostgreSQL para as nove ordenações que o Oxigraph mantém no RocksDB.
A chave é calculada a partir do próprio termo: números, datas e strings curtas ficam inline, enquanto IRIs e valores mais longos viram um SipHash de 120 bits cujo texto fica no dicionário kb.terms. Constantes de uma consulta já chegam como chaves, sem lookup, e o motor faz os joins nessas chaves. As varreduras index-only rodam no snapshot de quem chamou, então o SPARQL enxerga exatamente o que a instrução SQL ao redor enxerga. A memória é limitada por kb.engine_memory_limit, e um cancelamento ou statement_timeout para o motor como pararia qualquer consulta normal.
Uma consulta, duas fontes de dados
O exemplo que Suhorukov usa no post é direto: uma tabela employees representa dados que já existem, e uma taxonomia SKOS de habilidades representa o conhecimento novo. Depois de CREATE EXTENSION pg_knowledge_base, kb.load() lê Turtle, N-Triples, N-Quads, TriG, RDF/XML, JSON-LD e N3 para carregar a taxonomia nas tabelas internas.
Um mapeamento R2RML, registrado com kb.add_mapping(), descreve a tabela employees como RDF, ligando foaf:name e ex:dept às colunas correspondentes. Nada é copiado: a partir daí, toda consulta SPARQL lê a tabela ao lado do store, não uma cópia dela.
Com isso, uma única consulta pode atravessar skos:broader* na taxonomia guardada como triplas e, no mesmo WHERE, puxar foaf:name e ex:dept da tabela employees via kb.sparql(). Um detalhe de execução interessante: quando um padrão fixa ?person em um IRI como <http://example.com/emp/1>, o motor inverte o template do mapeamento e lê a linha pela chave primária, com id = 1. Esse SQL roda como o papel que fez a chamada, então privilégios e row-level security da tabela valem também para SPARQL. Renomear Alice na tabela faz a próxima consulta SPARQL devolver o nome novo, sem reprocessar nada.
SPARQL dentro do SQL, e uma transação só
kb.sparql() é uma função que retorna conjunto de linhas, então seu resultado participa de JOIN, GROUP BY ou vira base de uma view comum. No exemplo do post, uma consulta SPARQL que localiza quem tem qualquer habilidade sob ex:Databases é unida à tabela employees para agrupar por departamento e listar e-mails com string_agg.
Mais relevante para quem sustenta esse tipo de base é kb.sparql_update(), que roda uma atualização SPARQL dentro da transação de quem chamou. No exemplo, Carol muda de departamento na tabela e ganha uma nova habilidade na base de triplas, dentro do mesmo BEGIN/COMMIT: a linha e a tripla são gravadas juntas, ou nenhuma das duas é. Um ROLLBACK ali desfaz as duas. É exatamente a lacuna que a arquitetura de dois bancos deixa aberta, resolvida pelo jeito mais chato e mais certo: pelo gerenciador de transações que já existe.
Endpoints HTTP, login do PostgreSQL
Clientes SPARQL não falam libpq, então a extensão também expõe o SPARQL 1.1 Protocol e o Graph Store Protocol. Caminhos, parâmetros, negociação de conteúdo e códigos de status são os do servidor do Oxigraph, cujo código de protocolo foi portado para o motor, exceto que cada caminho começa com um nome de banco: http://localhost:7878/query do Oxigraph vira https://db:7878/company/query, ao lado de /company/update, /company/sparql e /company/store.
Um background worker aceita a conexão e checa o login contra pg_hba.conf e a senha do papel, do mesmo jeito que o PostgreSQL checa um backend comum; outro background worker assume o socket. Usuários do endpoint são papéis comuns, com GRANT comuns sobre kb.quads, kb.terms, kb.graphs e a tabela mapeada. Cada requisição é uma transação, visível em pg_stat_activity e cancelável com pg_cancel_backend(); erros carregam o SQLSTATE num cabeçalho X-SQLSTATE, e um reload liga ou desliga o endpoint sem reiniciar o servidor.
Réplicas, assinantes e backup sem mudar nada
O store é feito de tabelas heap e índices btree, então toda escrita SPARQL passa pelo WAL. Suhorukov diz ter checado os exemplos do post numa primária, numa réplica de streaming e num assinante lógico.
- Um hot standby responde
kb.sparql()como a primária, triplas de R2RML incluídas, já que os mapeamentos e as tabelas mapeadas também replicam;kb.sparql_update()ali falha como qualquer escrita falharia. - O endpoint sobe onde escritas são aceitas: fica mudo num standby e volta depois de um
pg_ctl promote, com os mesmos caminhos, papéis e senhas. - Replicação lógica leva a base de conhecimento para outro cluster publicando
kb.quads,kb.terms,kb.graphs,kb.mappingse as tabelas mapeadas; a identidade de réplica dekb.quadsé seu índice único, mesmo depois que uma carga em massa o reconstrói. pg_dump,pg_restore,pg_basebackupe recuperação point-in-time tratam o store como qualquer tabela.
Para quem administra banco, esse é o ganho que realmente importa: não existe um segundo plano de recuperação de desastre para aprender nem auditar.
O preço: carga mais lenta, disco mais pesado
Como o pg_knowledge_base e o servidor do Oxigraph avaliam com o mesmo spareval, comparar os dois mede basicamente o armazenamento. Suhorukov rodou 14 consultas sobre um dataset no formato do Berlin SPARQL Benchmark, com 3.577.116 triplas, comparando o servidor do Oxigraph com RocksDB, o endpoint da extensão e SQL puro, em uma máquina ociosa de 32 núcleos com um build beta do PostgreSQL 19 com assertions:
| Consulta | Oxigraph | Endpoint | SQL |
|---|---|---|---|
| triplas de um produto | 0,54 ms | 0,65 ms | 0,14 ms |
| produtos com um atributo, filtrados, ordenados, top 10 | 14,9 ms | 2,81 ms | 2,58 ms |
| toda oferta agrupada pelo país do vendedor | 9.764 ms | 1.174 ms | 1.203 ms |
Consultas pontuais levam décimos de milissegundo nos dois servidores, e um décimo disso via SQL puro. Planos que são laços aninhados de buscas por índice rodam de 4 a 8 vezes mais rápido no PostgreSQL, cujo shared_buffers manteve o store inteiro em memória, enquanto o Oxigraph rodou com o cache padrão de 32 MB do RocksDB (sua CLI não expõe como aumentar esse valor).
O custo aparece na carga e no disco: carregar as 3,5 milhões de triplas levou 43,8 segundos em uma transação (19,1 segundos com bulk => true) contra 1,5 segundo do carregador em massa do RocksDB com 16 threads. Em disco, o store ocupou 1.613 MB (1.338 MB depois de uma carga em massa) contra 324 MB do RocksDB, porque os índices btree não têm a compressão de prefixo e o LZ4 do RocksDB.
Suhorukov argumenta que um table access method próprio ajudaria pouco: substituiria só o heap, cerca de um quinto do tamanho total, e teria que reconstruir do zero o MVCC, o WAL, a replicação e o VACUUM que o heap já dá de graça. Chaves mais estreitas ou páginas de índice com compressão de prefixo seriam, na avaliação dele, a correção mais barata.
O que ainda falta
- R2RML é lido padrão por padrão: joins,
FILTERe agregações sobre tabelas mapeadas rodam dentro dospareval, não como uma única consulta SQL (diferente do que faz o Ontop), e atualizações SPARQL nunca escrevem nas tabelas mapeadas. - Não há federação
SERVICE, e o endpoint fala só HTTP/1.1 com autenticação básica. - Row-level security funciona nas tabelas mapeadas, mas não em
kb.quads. - Literais tipados são mantidos como valores, igual ao store nativo do Oxigraph.
- O store ainda não entrega estatísticas ao otimizador: o fork do Oxigraph mantido por Suhorukov já reordena joins por custo a partir de estatísticas do dataset, mas o store do pg_knowledge_base ainda não as produz.
Vale trocar o triple store por isso?
A proposta faz mais sentido quando o grafo de conhecimento é dado satélite, fortemente acoplado a tabelas relacionais: uma taxonomia de habilidades, uma ontologia de produto, fatos que alimentam uma aplicação de LLM↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI →, em volume moderado. Nesse cenário, a extensão elimina de verdade um pedaço inteiro de infraestrutura: modelo de segurança duplicado, cronograma de backup duplicado, e a janela de defasagem de um ETL que nunca termina de copiar.
Para cargas que exigem um banco de grafos dedicado em escala, com cargas em massa frequentes ou datasets em que cada byte em disco pesa, o Oxigraph sobre RocksDB (ou outro triple store dedicado) ainda ganha disparado em tempo de carga e espaço ocupado. A decisão, para quem administra banco, deveria começar pela dependência de consistência transacional entre o grafo e o resto do esquema, não pela lista de recursos SPARQL suportados.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Awide Polar separa compute e storage no PostgreSQL e mira HTAP sem ETL
A Awide Labs abriu o código do Awide Polar, fork do PostgreSQL 17 derivado do PolarDB da Alibaba. A proposta é desacoplar armazenamento de processamento e rodar cargas transacionais e analíticas sobre o mesmo dado, sem pipeline de ETL.