Otimização de folios no kernel Linux pode gerar rajadas de I/O em clusters Galera/PXC
Um case publicado pela Percona mostra como a adoção de large folios pelo kernel Linux, combinada com o uso de mmap() pelo cache do Galera, pode multiplicar a escrita em disco sem que nenhuma configuração do MySQL tenha mudado.
Um case publicado pela Percona mostra como a adoção de large folios pelo kernel Linux↳Linux34 conteúdosKali Linux em um Servidor VPS: como, quando e por que usar?DevSecOps · dez 2024Construindo um Windows Service ou Linux Daemon com Worker Service & .NET Core – Parte 2Dev (Back & Front) · jul 2020Criando uma WebApi utilizando .NET, Linux e VSCodeDev (Back & Front) · ago 2019Ver tudo em DevSecOps →, combinada com o uso de mmap() pelo cache do Galera, pode multiplicar a escrita em disco sem que nenhuma configuração do MySQL↳MySQL8 conteúdosMySQL + Adminer + Docker Compose: montando rapidamente um ambiente para usoData · abr 2019Banco de dados MYSQL no PHPStormDev (Back & Front) · jul 2019Criando um ambiente de desenvolvimento PHP mínimo com Docker – Parte 3Dev (Back & Front) · out 2019Ver tudo em Data → tenha mudado.
A Percona publicou nesta sexta-feira (16 de outubro de 2026) um relato de caso assinado por Przemysław Malkowski que vale a atenção de quem opera Percona XtraDB Cluster (PXC) ou qualquer outro cluster Galera. O gatilho foi um upgrade aparentemente trivial: a versão do PXC subiu de 5.7 para 8.0 num cliente da consultoria. A carga de trabalho não mudou, as configurações do MySQL não mudaram, mas todos os nós do cluster passaram a exibir rajadas esparsas, porém regulares, de escrita massiva em disco.
O detalhe que tornou o caso intrigante é que as estatísticas de workload do próprio MySQL, reunidas durante essas rajadas, não explicavam o volume delas de forma alguma.
Onde o tempo de disco estava sendo gasto
A investigação usou pidstat e iostat para confirmar que o próprio processo mysqld era a origem das escritas excessivas. Cavando mais fundo, as threads responsáveis apareceram: a Galera receiver thread (que recebe o replication stream), as connection threads no nó escritor e as applier threads nos nós secundários. Havia uma disparidade enorme entre o que o InnoDB escrevia (redo, undo, tablespace) e o que era contabilizado nas threads do Galera.
Um breakdown por thread, para uma rajada de poucos segundos, mostrou a distribuição a seguir:
| Grupo de threads | Escrita contabilizada | Participação |
|---|---|---|
| applier (threads de aplicação de write-sets) | 13,0 GB | 61% |
| galera_recv-0 (receiver thread) | 5,2 GB | 24% |
| ib_pg_flush* (page cleaners do InnoDB) | 2,0 GB | 9% |
| ib_log_writer (redo log) | 0,76 GB | 4% |
| Galera_srvc (serviço do Galera) | 0,29 GB | 1% |
A hipótese inicial foi que transações alterando uma única coluna estivessem inflando os eventos de binlog por causa de colunas blob/text/json grandes, já que binlog_row_image=full aplica o formato ROW tanto ao write-set do Galera quanto ao binlog. Mas a análise do binlog com a ferramenta binlogsum mostrou volume moderado e completamente plano, sem relação com as rajadas.
O vilão: mmap() e as folios grandes do kernel
O ponto de virada veio quando se percebeu que o upgrade do PXC havia vindo acompanhado de um upgrade do sistema operacional: de Debian 11, com kernel Linux 5.10 LTS, para Debian 12, com kernel 6.1 LTS. Não havia mudança no código do plugin Galera nem nas extensões wsrep que explicasse o comportamento, então a suspeita migrou para o gcache, o arquivo de cache de write-sets do Galera, e para a forma como o kernel passou a tratá-lo.
A explicação está em um recurso chamado large folios, introduzido no kernel 5.16 para lidar com grandes volumes de dados em máquinas com bastante RAM e disco. O suporte a folios grandes no page cache chegou primeiro ao sistema de arquivos XFS, no kernel 5.18, e o cluster afetado mantinha o gcache justamente numa partição XFS.
Em resumo: diferente de qualquer outro arquivo de dados ou log do MySQL (exceto a storage engine TempTable), o cache do Galera não usa o caminho write()/pwrite(). Ele usa mmap(). Esse detalhe de implementação, que existe desde a origem do Galera, é o que faz o cache reagir de forma muito diferente à evolução do kernel.
Em kernels mais recentes (5.18 a 6.5), escritas via write()/pwrite() também sofriam algum efeito das folios grandes, mas o InnoDB normalmente usa O_DIRECT para os tablespaces (não passa pelo page cache) e o redo log e o binlog fazem appends pequenos, que geram folios de ordem zero (4 KB). No kernel 6.6, um patch introduziu rastreamento de dirty por bloco: o iomap passou a registrar os blocos de filesystem sobrepostos, em vez de marcar a folio inteira como suja. Isso beneficiou diretamente quem escreve via write()/pwrite().
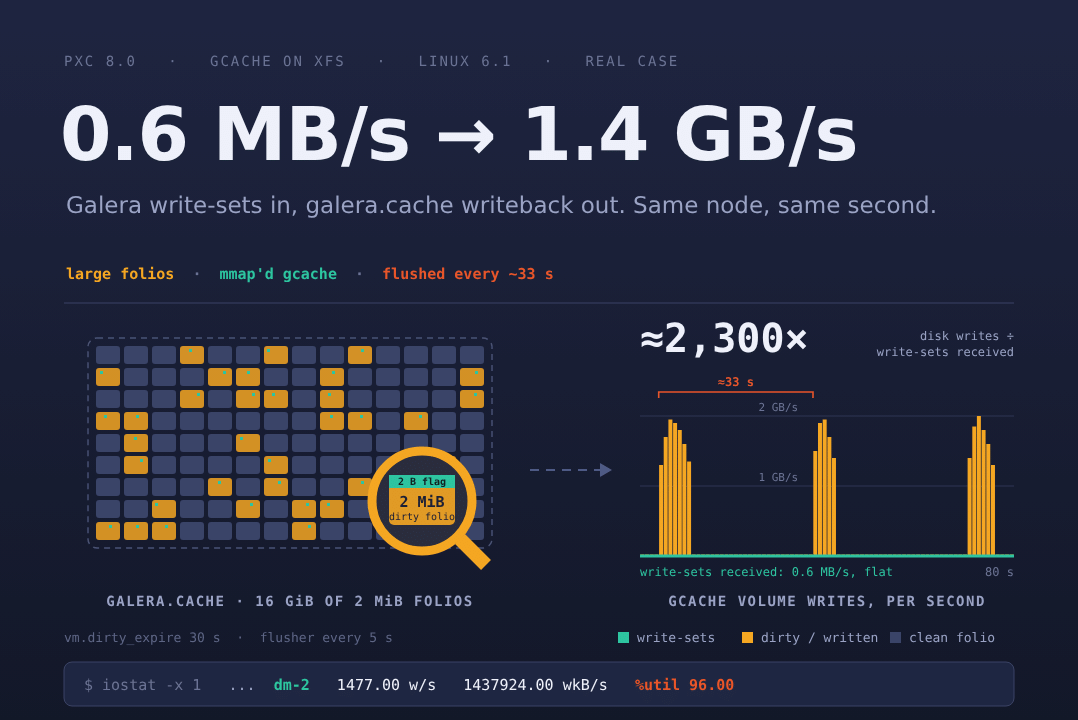
O caminho mmap(), porém, não tem como se beneficiar dessa melhoria. Qualquer atualização via memory mapping marca a folio inteira como dirty, então o writeback do page cache sincroniza a folio completa (até 2 MB) em vez do bloco exato de 4 KB que de fato mudou. Uma escrita pequena e aleatória num arquivo mapeado por mmap() pode, assim, disparar uma rajada de I/O desproporcional.
Não sou um especialista em kernel Linux, então espero que não haja erros demais.
I am not a Linux kernel expert, so I hope there are not too many errors.Przemysław Malkowski, Percona
Por que o cache do Galera sofre mais que o InnoDB
Três fatores combinados tornam o gcache um alvo particularmente exposto a esse fenômeno. Primeiro, o tamanho: o cache padrão é de 128 MB, mas na prática costuma ser configurado bem maior para garantir cobertura suficiente de IST (Incremental State Transfer). Segundo, o padrão de acesso: além dos appends sequenciais de novos write-sets, há muitas atualizações pequenas e aleatórias que marcam entradas como RELEASED quando a transação já foi aplicada e o espaço pode ser reaproveitado.
O terceiro fator é o readahead do dispositivo de armazenamento. Quando os dados do MySQL, junto com o galera.cache, ficam num array RAID, o kernel Linux costuma aumentar automaticamente o read_ahead_kb proporcionalmente à geometria do array e ao optimal_io_size anunciado pelo dispositivo. Isso vale tanto para RAID por software quanto, em muitos casos, para stacks com dm/LVM. Readahead maior gera folios maiores, e foi exatamente isso que aconteceu no caso do cliente da Percona.
Há ainda um gatilho adicional: durante o startup de um nó PXC, o arquivo gcache inteiro é varrido sequencialmente no processo de recovery (habilitado por padrão), o que pode popular de imediato grandes áreas de page cache em folios já maximizadas.
A periodicidade das rajadas também tem explicação mecânica. O kernel verifica a cada dirty_writeback_centisecs (5 segundos por padrão) se os dados sujos de um inode já ultrapassaram o dirty_expire_centisecs (30 segundos por padrão). As rajadas observadas no cliente, de aproximadamente 33 segundos, são consistentes com essa combinação de timers, ainda que eles não garantam um período fixo de flush.
Os contornos possíveis
Atualmente não existe correção do lado do kernel para o caminho mmap() especificamente, e o problema não é exclusivo do Galera: qualquer aplicação que use arquivos mapeados por memória está sujeita ao mesmo efeito. A lista de workarounds reportada pela Percona inclui:
- Usar EXT4 em vez de XFS, quando a versão do kernel permitir: o suporte a folios chegou ao EXT4 só no kernel 6.16, bem mais tarde que no XFS (5.18). Foi essa a solução aplicada no caso do cliente.
- Reduzir o
read_ahead_kbdo dispositivo de bloco, ao custo de desempenho potencialmente menor em leituras sequenciais, limitando o tamanho máximo das folios grandes. - Modificar a aplicação para usar a dica
madvise(MADV_RANDOM)nas chamadas demmap(), desabilitando efetivamente o readahead por acesso aleatório forçado. - Trocar
mmap()porpwrite()em kernels 6.6 ou superiores, já que o rastreamento de dirty por bloco só beneficia esse caminho. - Compilar um kernel customizado sem suporte a THP (
CONFIG_TRANSPARENT_HUGEPAGEdesabilitado), já que folios grandes não são criadas sem THP disponível. Vale o alerta: desabilitar THP só via GRUB não é suficiente para desabilitar as folios grandes.
A Percona reportou o problema no rastreador do PXC, no ticket PXC-5340, mas a solução estrutural depende de mudanças no próprio Galera (abandonar mmap()) ou de evolução do kernel para tratar o caso de memory-mapped files com a mesma granularidade já disponível para write()/pwrite().
Como saber se seu cluster está exposto
Para quem administra PXC, MariaDB Galera Cluster ou qualquer binário derivado, vale fazer essa checagem antes do próximo upgrade de sistema operacional, não depois de um incidente em produção:
- Confira a combinação kernel + filesystem: XFS em 5.18 ou superior, ou EXT4 em 6.16 ou superior, já habilitam folios grandes.
- Leia o readahead do dispositivo com
cat /sys/block/<dev>/queue/read_ahead_kbeoptimal_io_size. - Verifique mapeamentos grandes olhando
FilePmdMappedem/proc/meminfo, ou osmapsdo processomysqldpara o mapeamento do gcache, além do contadorthp_file_mappedsubindo em/proc/vmstat. - Acompanhe o
iostatpor rajadas a cada 30 a 35 segundos (salvo configuração diferente devm.dirty_expire_centisecsevm.dirty_writeback_centisecs), compidstat -dmostrando cargas em múltiplos de até 2 MB por thread.
Um problema maior que o Galera
O efeito das folios grandes sobre arquivos mapeados por memória não é exclusividade do Galera. O mesmo artigo cita relatos de pressão de I/O excessiva no journal do systemd, cuja causa raiz segue mal compreendida mesmo dentro da própria comunidade systemd, além de um caso separado envolvendo RocksDB, em que misturar workloads de escrita ativa usando page cache com O_DIRECT ao mesmo tempo gerou stalls inesperados.
Para quem projeta ou opera sistemas de armazenamento, a lição estrutural é clara: uma otimização de kernel pensada para cargas sequenciais com RAM e disco abundantes pode se tornar um multiplicador de I/O justamente nos padrões de acesso aleatório e pequeno que caracterizam caches de replicação como o do Galera. Antes de qualquer upgrade combinado de banco de dados e sistema operacional, vale a pena mapear que caminho de I/O cada componente crítico usa, e não presumir que uma melhoria genérica do kernel beneficia igualmente todo o stack.
Fonte: Percona Database Blog
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
PostgreSQL: o parâmetro plan_cache_mode decide entre plano genérico e plano customizado
O GUC plan_cache_mode permite forçar o PostgreSQL a sempre replanejar ou a sempre reusar o mesmo plano de execução. Um artigo recente de Christophe Pettus mostra onde isso ajuda e onde quebra, com números de PostgreSQL 18.6 e 19 beta 4.