Ferramenta web inspeciona pg_dump do PostgreSQL sem restaurar em servidor
O PostgreSQL Dump Viewer replay o arquivo de backup dentro do navegador para checar tabelas, chaves estrangeiras e rodar SQL de leitura antes de qualquer restore de verdade.
O PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → Dump Viewer replay o arquivo de backup dentro do navegador para checar tabelas, chaves estrangeiras e rodar SQL de leitura antes de qualquer restore de verdade.
O PostgreSQL Dump Viewer replay o arquivo de backup dentro do navegador para checar tabelas, chaves estrangeiras e rodar SQL de leitura antes de qualquer restore de verdade.
Quem administra PostgreSQL em produção conhece a cena: chega um arquivo .dump ou .sql.gz de origem duvidosa, e a única forma confiável de saber o que tem dentro é subir um servidor, criar um banco vazio, rodar pg_restore e esperar. Se o arquivo for grande, isso significa minutos (às vezes horas) de espera só para responder uma pergunta simples: é o backup certo? Tem a tabela que eu preciso? Qual schema está aí dentro?
Um post recente no Planet PostgreSQL descreve uma ferramenta que ataca exatamente esse gargalo: o PostgreSQL Dump Viewer, um serviço gratuito que abre um dump do PostgreSQL sem precisar de servidor algum, restaurando o conteúdo dentro de um PostgreSQL real que roda inteiramente na aba do navegador.
O problema que a inspeção tradicional não resolve bem
Hoje, sem um servidor, as opções são limitadas. pg_restore e um grep bem colocado conseguem listar as tabelas do arquivo e até exibir linhas de uma tabela como texto bruto, se o dump for em formato plain SQL. Mas nenhuma das duas ferramentas filtra, ordena ou faz join. Não dá para responder "quantos clientes ativos existem nesse dump" ou "essas duas tabelas realmente têm a foreign key que eu esperava" sem subir o dado de verdade em algum lugar que entenda SQL.
O post separa bem os dois problemas: restaurar um banco é colocá-lo de volta em operação; inspecionar um dump é responder uma pergunta pontual sobre um arquivo. São operações com objetivos diferentes, e tratá-las como a mesma coisa é o que torna a inspeção de um backup recebido, ou de uma verificação pré-restore, um processo desproporcionalmente pesado.
Como o Dump Viewer funciona por baixo
A ferramenta replay o dump dentro de uma instância PostgreSQL que roda no próprio navegador (via WebAssembly), sem enviar o arquivo para nenhum servidor externo. O fluxo descrito na fonte é direto:
- Abrir o PostgreSQL Dump Viewer no navegador.
- Arrastar o arquivo de dump. O detector de formato lê os primeiros bytes do arquivo, não a extensão, então um dump plain salvo como
.backupainda abre corretamente. - Navegar pela árvore de schemas e tabelas à esquerda, com contagem de linhas por tabela, e abrir os dados de uma tabela na aba Data.
A partir daí, o diferencial aparece: uma aba Diagram desenha as tabelas e as foreign keys que o PostgreSQL reconhece depois do replay (inclusive tratando tabelas particionadas como uma entidade só, não uma por partição), e uma aba SQL permite rodar SELECT e WITH contra o banco real, não contra um parser que apenas simula sintaxe PostgreSQL. Isso importa porque a sintaxe, funções e tipos do PostgreSQL funcionam exatamente como funcionariam num servidor de produção, sem as pegadinhas de ferramentas que tentam interpretar SQL sem executá-lo de fato.
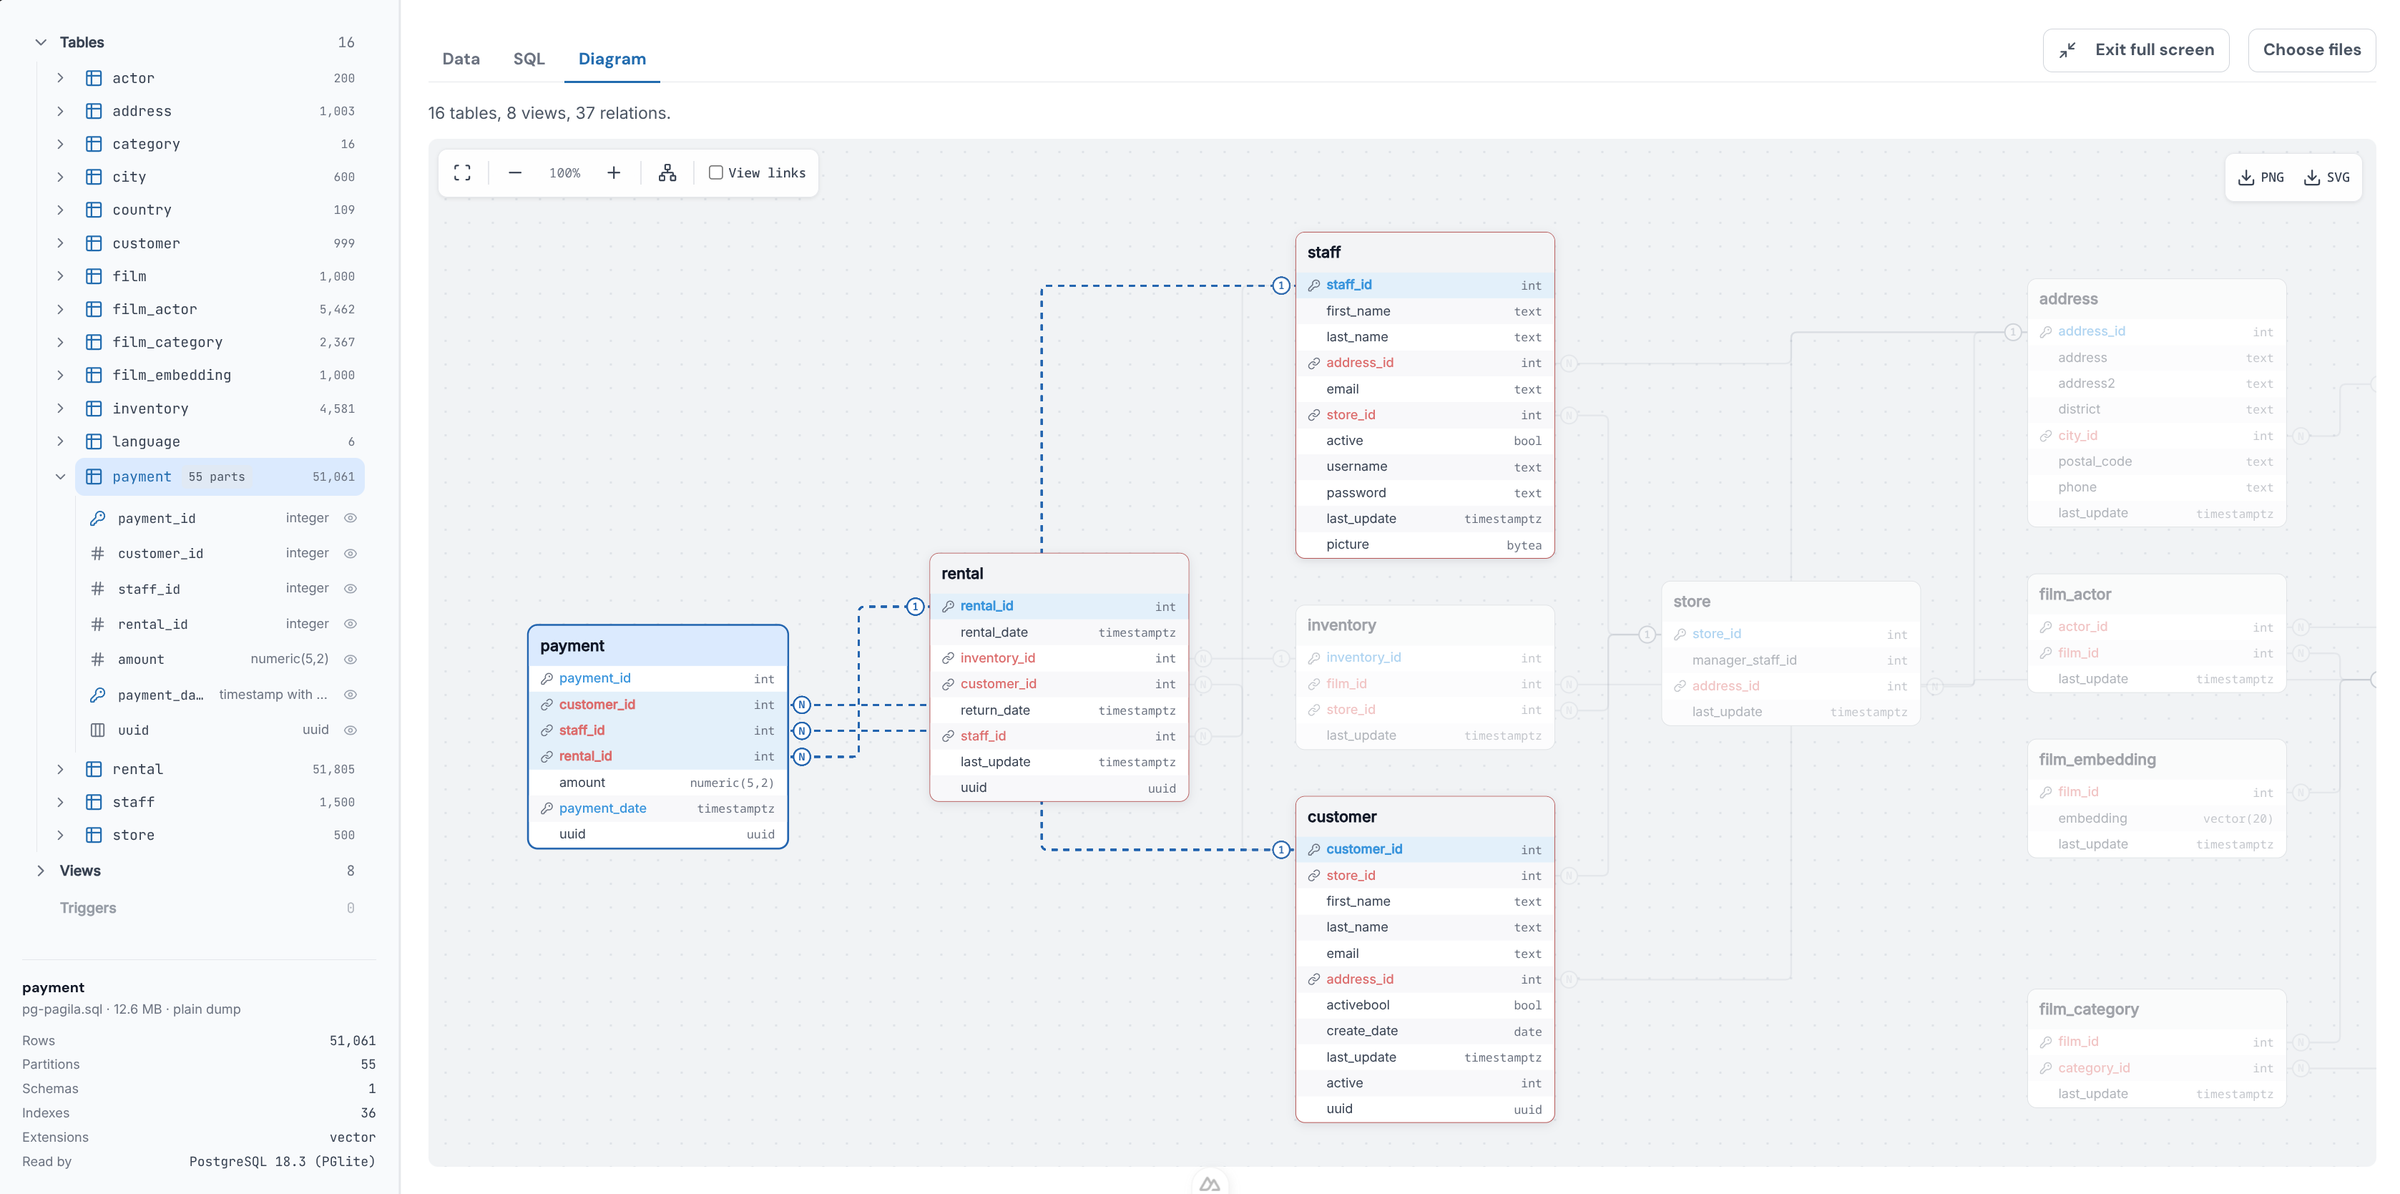
Um exemplo prático citado no post: tabelas são acessíveis sem prefixo de schema, como em SELECT * FROM orders; só é preciso qualificar (sales.orders) quando duas tabelas de schemas diferentes têm o mesmo nome. O resultado de qualquer consulta pode ser exportado como CSV ou JSON.
O que abre e o que não abre
Aqui está o ponto que todo DBA precisa registrar antes de confiar cegamente na ferramenta: ela não lê qualquer dump. Funcionam dumps plain (.sql, inclusive comprimidos como .sql.gz, .sql.zst ou .sql.lz4) e arquivos tar gerados com pg_dump -Ft. Dumps em formato custom (-Fc) e directory (-Fd), os mais comuns em rotinas de backup de produção justamente por serem mais compactos e paralelizáveis no restore, não abrem diretamente. É preciso convertê-los primeiro:
pg_restore -f dump.sql yourfile.dumpPara um dump em formato directory, o comando recebe a pasta no lugar do arquivo. Ou seja: quem usa -Fc por padrão (a maioria das rotinas com pg_dump para bancos médios e grandes) precisa de um passo extra de conversão antes de usar o viewer, o que reduz um pouco o ganho de agilidade prometido.
Há também um teto de memória: o banco inteiro precisa caber nos 2 GB disponíveis na aba do navegador, e o próprio PostgreSQL consome cerca de um terço disso. Na prática, isso limita a ferramenta a dumps pequenos e médios; um banco de produção de dezenas de gigabytes ainda exige um servidor real. Extensões como PostGIS e pgvector são carregadas automaticamente pelo viewer; TimescaleDB não é suportado, e os objetos que dependem dela aparecem listados nominalmente, sem serem materializados.
Restaurar um dump desconhecido tem um custo de segurança real
Este é o argumento que mais interessa a quem lida com bancos em produção: um dump é SQL, e restaurá-lo executa esse SQL com os privilégios do papel usado no restore. Em um servidor real, restaurado como superusuário, um dump malicioso pode rodar comandos de shell e ler arquivos do sistema através de COPY ... TO PROGRAM. Isso não é um cenário hipotético raro: dumps recebidos de terceiros, de clientes, de fornecedores ou baixados de repositórios públicos para teste carregam esse risco sempre que alguém decide simplesmente restaurar "para dar uma olhada".
No Dump Viewer, o mesmo SQL roda dentro de um PostgreSQL descartável isolado na aba do navegador, sem acesso a rede, sistema de arquivos ou shell, e a instância inteira desaparece ao fechar a aba. Para quem recebe um dump de origem não totalmente confiável e precisa decidir se vale a pena restaurá-lo de verdade, essa é uma diferença de postura, não só de conveniência: a inspeção deixa de exigir a mesma confiança que a restauração exige.
Extensão para editores e o limite da automação
A mesma engine está disponível como extensão para VS Code, e via Open VSX para Cursor e VSCodium. Um botão "Ask AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → about this file" permite que o agente do editor consulte o dump em modo somente leitura e responda em linguagem natural, o post cita como exemplo perguntar quais clientes mais alugam filmes e receber a resposta com a query executada e uma tabela de resultado.
Vale o registro de cautela de praxe com esse tipo de recurso: a consulta é gerada por um modelo, não por quem conhece o esquema. Serve bem para exploração inicial de um dump desconhecido, mas qualquer número que for para uma decisão de negócio ou para um relatório de auditoria merece a query revisada manualmente antes de ser tomada como verdade, exatamente como qualquer SQL gerado por IA.
Onde isso entra na rotina de um DBA
A proposta descrita no post é modesta e, por isso, honesta: a ferramenta não substitui pg_restore nem serve para produção. Serve para o momento anterior à decisão de restaurar: confirmar que aquele é o backup certo, ver rapidamente se uma tabela específica está presente, checar se as foreign keys esperadas realmente existem no schema exportado. Para uma recuperação de desastre de fato, subir um servidor, restaurar por completo e validar a aplicação continua sendo o caminho correto e necessário. O que muda é que a pergunta mais barata, "esse arquivo tem o que eu preciso?", não precisa mais custar o mesmo tempo e o mesmo risco que a restauração completa.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Por que a replicação lógica do PostgreSQL pode continuar lenta mesmo com workers disponíveis
O parâmetro que promete replicação lógica paralela na verdade controla quantas transações grandes podem ser aplicadas ao mesmo tempo, não a velocidade de cada uma; entender essa diferença evita configuração inútil em produção.