
Atlassian reconstrói pipeline de métricas com OpenTelemetry sem trocar a interface do gostatsd
A empresa substituiu o gostatsd por uma pipeline OpenTelemetry Collector para processar dados de cerca de 100 mil hosts em 14 regiões, mantendo o mesmo endpoint StatsD que milhares de serviços já usavam.

A Atlassian publicou, em post no blog da CNCF assinado por Iris Grace Endozo, Farzad Vazirnia e Albert Kerr, o relato de como reconstruiu sua plataforma de métricas trocando o gostatsd por uma pipeline baseada em OpenTelemetry Collector, segundo reportagem da InfoQ. O sistema recebe dados de aproximadamente 100 mil hosts em 14 regiões e opera sob um SLO de 99,95%, o que tornava qualquer troca de motor uma operação de alto risco: os mesmos dados alimentam alertas de produção.
O problema: um protocolo que não cresce mais
O gostatsd funcionava de forma confiável havia anos, mas seu desenho era UDP-only e não suportava traces nem logs. Ao mesmo tempo, cada vez mais serviços internos já geravam dados no formato OpenTelemetry. Continuar apostando no gostatsd significaria reconstruir, dentro de casa, funcionalidades que a comunidade do OpenTelemetry Collector já desenvolvia.
A saída que a equipe escolheu evitou o caminho mais óbvio: pedir que milhares de serviços trocassem, de uma vez, o cliente StatsD por SDKs OpenTelemetry. Em vez disso, o time manteve a interface StatsD-sobre-UDP intacta e reconstruiu tudo o que existia atrás dela.
Mantivemos a interface e reconstruímos tudo por trás dela, o que transformou uma migração de toda a organização em uma migração de responsabilidade só do time de plataforma.
We kept the interface and rebuilt everything behind it, which turned an org-wide migration into a platform-team migration.Iris Grace Endozo, Farzad Vazirnia e Albert Kerr, Atlassian
Quatro estágios, uma reconstrução por vez
A nova plataforma segue o modelo de pipeline do OpenTelemetry Collector, no qual receivers recebem dados, processors os transformam e exporters os enviam a um ou mais destinos. A Atlassian dividiu a operação em quatro estágios (coleta, ingestão, agregação e encaminhamento), o que permitiu trocar cada parte isoladamente sem substituir as demais.
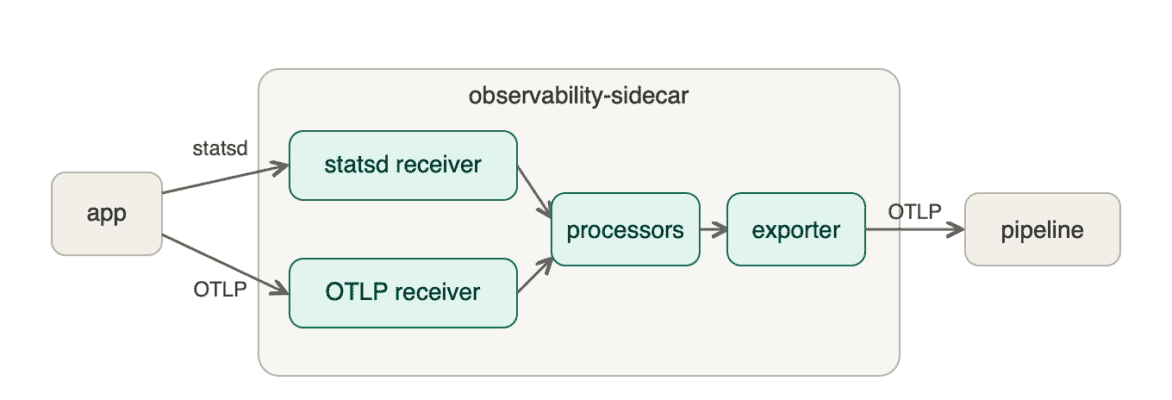
Coleta. O sidecar do gostatsd foi substituído pela mesma distribuição de Collector já usada pelo time de tracing. Aplicações continuaram enviando pacotes StatsD para o mesmo endereço, enquanto um receiver OTLP passou a aceitar métricas OpenTelemetry de serviços mais novos. Unificar métricas e traces num único sidecar economizou em média 3,9% de CPU nos serviços mais caros da plataforma Micros, e a equipe estima um corte de cerca de 30% no custo de sidecars em toda a frota. Uma extensão OpenTelemetry para Lambda preserva a mesma interface em cargas serverless, onde não há como rodar sidecar.
Ingestão. A agregação de métricas é stateful: todo ponto de uma série temporal precisa chegar ao mesmo agregador. O antigo proxy nomad fazia hash por serviço e ambiente, concentrando os maiores serviços em poucas réplicas sobrecarregadas. O novo sistema usa o load-balancing exporter do OpenTelemetry Collector Contrib para fazer hash por stream ID, mantendo cada série temporal junta enquanto distribui um serviço grande por todo o pool. O resultado, segundo a Atlassian, foi distribuição de CPU mais uniforme, menos shards quentes e melhor escalonamento fora de pico.
Agregação. É aqui que está o maior ganho em volume de dados. A plataforma recebe cerca de 4,8 bilhões de pontos de dados por minuto e armazena aproximadamente 220 milhões, uma redução de cerca de 96%. Como os componentes upstream do OpenTelemetry não agregavam métricas delta do jeito que a Atlassian precisava, a empresa desenvolveu e abriu o código de seu próprio processador de agregação. A nova camada usa cerca de metade da CPU para o mesmo tráfego.
Encaminhamento. Um serviço próprio de forwarding foi substituído por uma distribuição stateless de Collector chamada metrics-gateway. Exporters upstream agora distribuem dados para destinos como SignalFx e S3, com o Collector cuidando de retry, enfileiramento e backpressure. Segundo os autores, adicionar um novo destino virou mudança de configuração em vez de projeto de integração separado.
Como a migração foi conduzida
A Atlassian recomenda começar por ambientes de desenvolvimento e staging, escolher early adopters que tenham algo a ganhar com a mudança e depois escalar o rollout em estágios de 1%, 10%, 50% e 100%. O time também defende preservar os fluxos operacionais já conhecidos enquanto sistema antigo e novo rodam em paralelo, e medir sob carga real de produção em vez de confiar só em benchmarks pequenos.
Testes pequenos e benchmarks não foram suficientes; profiling contínuo em produção foi o que realmente nos mostrou onde otimizar.
Small tests and benchmarks were not enough; continuous profiling in prod is what actually told us where to optimise.Iris Grace Endozo, Farzad Vazirnia e Albert Kerr, Atlassian
A Atlassian afirma que a agregação do gostatsd e o nomad ainda respondem por cerca de 38% da CPU requisitada nos clusters de métricas, sendo que o nomad sozinho consome cerca de 13% do total. Removê-los vai completar a pipeline OpenTelemetry de ponta a ponta. O próximo passo planejado é migrar a instrumentação das aplicações de StatsD, DogStatsD e clientes de fornecedores para SDKs OpenTelemetry.
Atlassian, Airbnb e Skyscanner: três rotas diferentes
A abordagem da Atlassian difere de outras migrações recentes de métricas para OpenTelemetry. A Airbnb, em cobertura anterior da InfoQ, usou emissão dupla a partir de uma biblioteca de métricas compartilhada e adotou o vmagent da VictoriaMetrics para agregação em streaming, chegando a processar mais de 100 milhões de amostras por segundo. A Skyscanner, por sua vez, padronizou instrumentação e transporte em OpenTelemetry desde o início e migrou mais de 300 microsserviços↳Microsserviços24 conteúdosArquitetura de Microsserviços em Node com o MoleculerJSDev (Back & Front) · jun 2025Segurança das APIs: como proteger seu ecossistema de microsserviçosDev (Back & Front) · dez 2023Você provavelmente não precisa de microsserviços (ainda)Dev (Back & Front) · mar 2026Ver tudo em Dev (Back & Front) → atualizando uma biblioteca comum.
A Atlassian escolheu preservar o endpoint StatsD e mover a pipeline por baixo dele, em vez de pedir reinstrumentação imediata. Nos três casos, a migração da aplicação foi separada da substituição da infraestrutura central, mas a Atlassian isolou ainda mais o risco: com milhares de serviços internos, reinstrumentar tudo de uma vez seria um programa mais longo e mais arriscado do que reconstruir o motor por trás de uma interface já estável.
Em um relatório traduzido de uma conferência, Iwahori, líder de infraestrutura de monitoramento da GREE, classificou a abordagem da Atlassian como bem pensada, valorizando em particular o roteamento por stream ID e o processador de agregação delta personalizado. Iwahori levantou uma questão prática sobre como escalar uma camada de agregação stateful, e a resposta da Atlassian indicou que essa parte ainda depende de configuração manual.
O que isso significa para quem opera infraestrutura no Brasil
O caso da Atlassian é um roteiro replicável para qualquer time que tenha um protocolo legado (StatsD, DogStatsD, ou telemetria proprietária) espalhado por centenas de serviços e não possa parar tudo para migrar. A lição central não é o OpenTelemetry em si, mas a decisão de separar a interface pública da implementação: quem depende do endpoint não precisa saber que o motor mudou.
Para times menores no Brasil que rodam Kubernetes↳Kubernetes18 conteúdosGerenciamento de infraestrutura multicloud com Kubernetes proporciona otimização e economiaDevSecOps · set 2021Azure Kubernetes Services – AKS: referências gratuitas e dicas para solução de problemas comunsDevSecOps · abr 2019Kubernetes em produção: o que ninguém te conta e você aprende tarde demaisDev (Back & Front) · abr 2026Ver tudo em DevSecOps → ou serverless com custo de observabilidade apertado, o dado mais aproveitável é o da agregação: reduzir volume de dados em 96% antes de armazenar é o tipo de otimização que baixa fatura de ferramentas como Datadog, New Relic ou stacks próprias baseadas em Prometheus. O processador de agregação delta que a Atlassian abriu o código é um ponto de partida concreto para quem enfrenta o mesmo gargalo sem o mesmo orçamento de engenharia.
Fica em aberto, como o próprio Iwahori apontou, como escalar a camada de agregação stateful sem depender de configuração manual, algo que qualquer equipe pensando em adotar esse desenho vai esbarrar mais cedo ou mais tarde.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Vulnerabilidades no Artifactory sob exploração ativa permitem acesso admin em minutos
Três CVEs em instâncias self-hosted do Artifactory já estão sendo exploradas para virar administrador em menos de cinco minutos. Quem roda a ferramenta em produção precisa checar exposição e versão hoje.