Perplexity troca DynamoDB por banco próprio e corta latência em 5x
A empresa por trás do mecanismo de busca com IA migrou sua camada de serving para o CobbleDB, banco de dados interno escrito em Rust, e reduziu a latência de leitura em lote em até 5 vezes com pelo menos 20% de economia em armazenamento.

A Perplexity, empresa por trás de um motor de busca respondido por IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →, migrou a camada de serving que atende suas buscas do Amazon DynamoDB para o CobbleDB, um banco de dados↳Banco de dados134 conteúdosSQL ou NoSQL: eis a questão!!Data · mar 2020Banco de dados: como organizar e dar segurança para milhões de dados de loteriasData · mai 20215 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → key-value distribuído construído internamente em Rust↳Rust7 conteúdosDesmistificando Rust: a linguagem segura e rápida que você precisa conhecerDev (Back & Front) · out 2024Como criar seu primeiro Programa em Rust com Solana PlaygroundDev (Back & Front) · mai 2026Rust no ranking: a segurança de memória perdeu a guerra corporativa?Marketing Tech · abr 2026Ver tudo em Dev (Back & Front) →. A informação foi publicada pelo InfoQ em 25 de setembro de 2026, com base em detalhes divulgados pela própria Perplexity. O motivo não foi capricho de engenharia: em volumes de mais de 200 mil requisições por segundo, o modelo de cobrança do DynamoDB (que tarifa cada byte transferido) tinha virado uma conta insustentável.
Por que o DynamoDB parou de fazer sentido
O padrão de leitura de um motor de busca respondido por LLM é diferente do de uma busca tradicional. Cada consulta feita à Perplexity gera entre 100 e 120 chaves de páginas-alvo, que o serviço de retrieval divide em lotes paralelos de 10 a 20 chaves. Em vez de devolver só um snippet de metadados, como uma busca convencional, o sistema precisa extrair passagens de texto completas e embeddings vetoriais densos por registro, o que produz payloads médios de cerca de 50 KB, muito mais pesados que uma leitura típica de banco de metadados.
Além do custo, havia um problema de opacidade: o DynamoDB funciona como caixa-preta em relação a posicionamento de partições, política de cache em memória e roteamento de réplicas. A equipe de engenharia não conseguia evitar picos de latência de cauda causados por leituras sem cache, saltos de rede entre zonas de disponibilidade ou réplicas atrasadas. Para piorar, jobs de reprocessamento disparados por mudanças no algoritmo de chunking ou por modelos de embedding mais novos jogavam escritas pesadas direto no DynamoDB, competindo (o clássico problema de "noisy neighbor") com as leituras de usuários em produção.
Três sistemas, três responsabilidades
Em vez de otimizar dentro do DynamoDB, a Perplexity separou o problema em três peças especializadas:
- Pillar: roda sobre YTsaurus em discos mecânicos de alta capacidade, mantendo famílias de tabelas versionadas para metadados de páginas, passagens e representações vetoriais. Transações atômicas do YTsaurus garantem que atualizações de crawl, mutações de estado e filas de exportação sejam commitadas juntas.
- Lorry: um consumidor de fila stateless que agrupa as exportações do Pillar em arquivos de lote alinhados por partição, armazenando os payloads no Amazon S3 e postando avisos de metadados para o CobbleDB.
- CobbleDB: os nós de serving puxam e ingerem esses lotes do S3 de forma independente, isolando completamente os nós de leitura de baixa latência do pipeline de escrita pesada do crawler.
Essa separação é, em si, uma lição de arquitetura: em vez de um único banco tentar servir escrita intensiva e leitura de baixa latência ao mesmo tempo, a Perplexity desacoplou armazenamento durável de retrieval quente.
Como o CobbleDB funciona por dentro
O CobbleDB é um key-value store distribuído otimizado exclusivamente para buscas em lote (batched lookups). Cada partição mantém três réplicas espalhadas em nós de computação independentes. O daemon principal usa o RocksDB como motor de armazenamento embarcado, combinando cache mapeado em memória com discos NVMe locais.
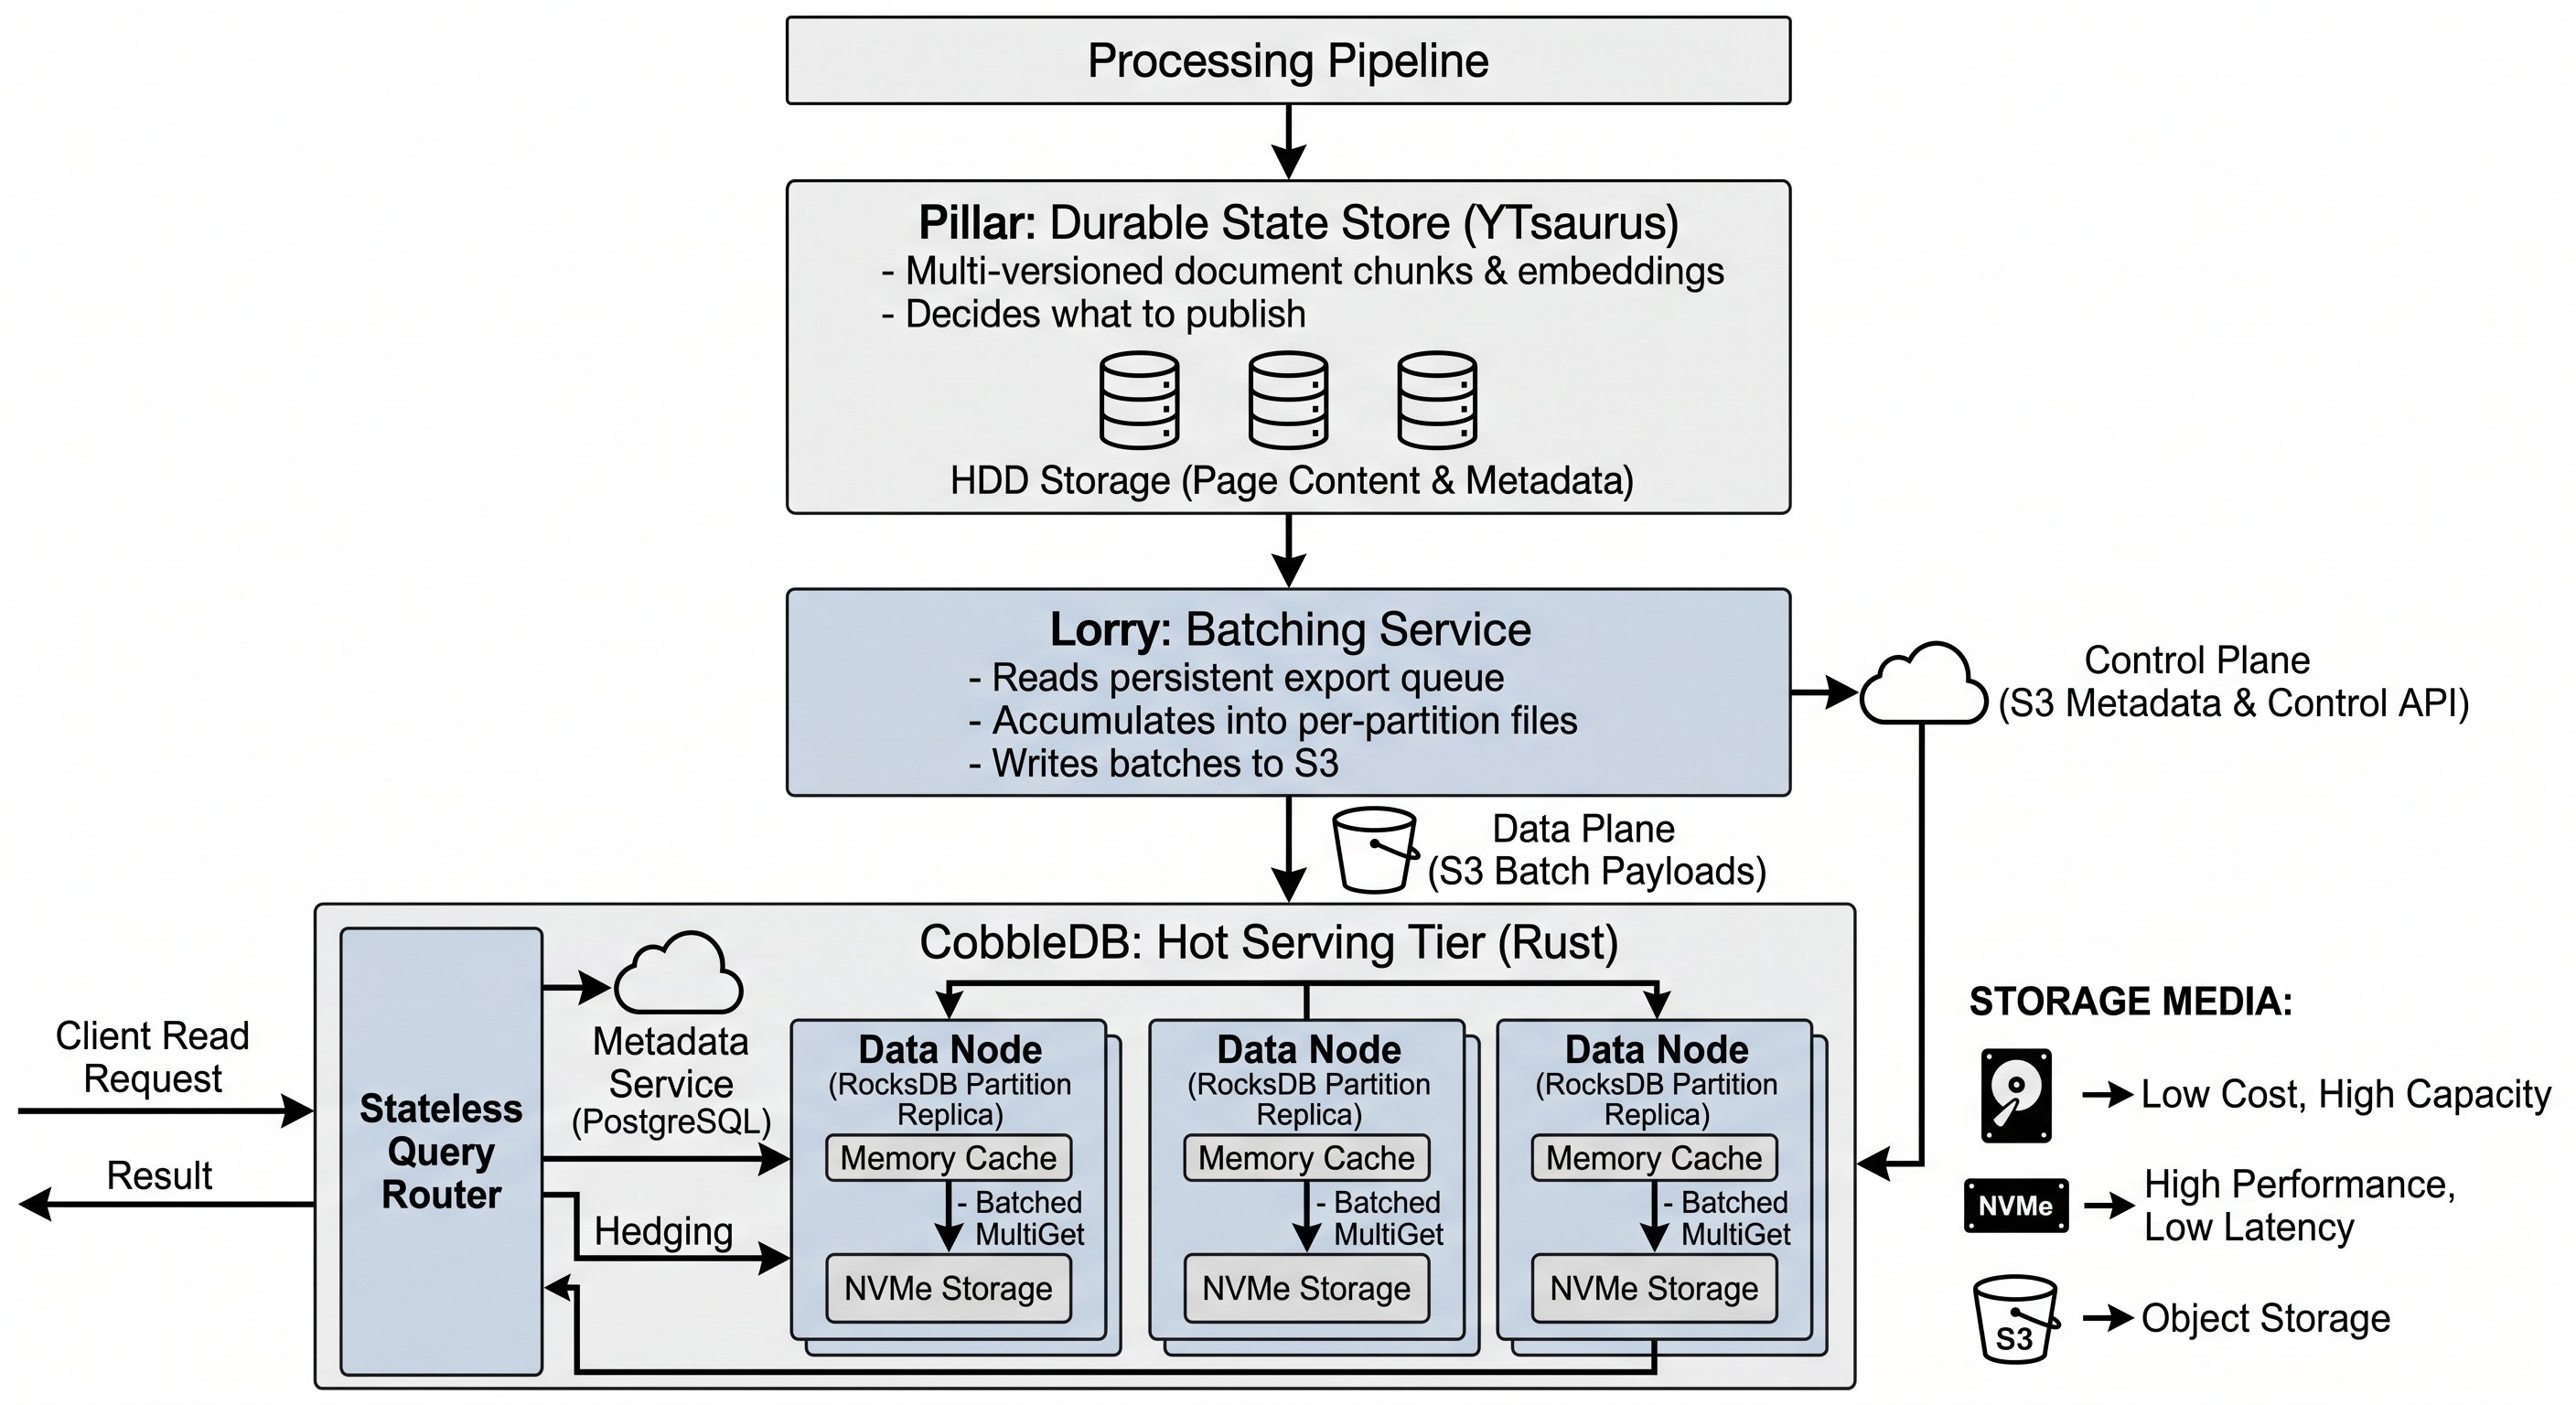
Um roteador de consultas stateless mapeia identificadores de página com hash para partições e coordena a execução das leituras, priorizando réplicas na mesma zona de disponibilidade para reduzir overhead de rede. Se uma réplica-alvo apresenta tempo de resposta elevado, o roteador especula: dispara em paralelo uma leitura para uma réplica alternativa em outro nó (a técnica conhecida como hedged reads). Dentro de cada nó, o CobbleDB recupera chaves simultaneamente através da interface batched MultiGet do RocksDB, eliminando overhead de round-trip:
pub struct BatchedPageRequest {
 pub keys: Vec<PageKey>,
 pub zone_affinity: AvailabilityZone,
}

impl StorageEngine {
 pub fn multi_get_pages(&self, keys: &[PageKey]) -> Result<Vec<Option<PageRecord>>, Error> {
 let rocksdb_keys: Vec<&[u8]> = keys.iter().map(|k| k.as_bytes()).collect();
 self.rocksdb.batched_multi_get(&rocksdb_keys)
 }
}
Outra decisão deliberada: o banco abandona protocolos de transação distribuída e algoritmos de consenso síncrono. Como o serving de busca tolera pequeno atraso de replicação, as réplicas aplicam atualizações de forma assíncrona, no próprio ritmo, o que reduz bastante a sobrecarga operacional.
Os números que justificam a troca
Em medições de produção, o CobbleDB reduziu a latência mediana de leitura em lote de 31,4 ms para 5,60 ms, o p90 caiu de 56,7 ms para 9,77 ms e o p99 (cauda) despencou de 123 ms para 24,2 ms. Benchmarks sintéticos com payloads de até 100 KB confirmaram throughput consistente de até 500 mil requisições por segundo. No armazenamento, a economia foi de pelo menos 20% frente ao custo anterior com o DynamoDB.
O preço de trocar nuvem gerenciada por engenharia própria
A arquitetura tem trade-offs que a Perplexity não esconde. Substituir um banco totalmente gerenciado transfere para os engenheiros de confiabilidade da própria empresa (SREs) todo o ciclo de vida dos nós: verificação de backup, rebalanceamento de partições, gestão de falhas de hardware. As aplicações também precisam conviver com consistência eventual, já que as réplicas ingerem os arquivos em lote em intervalos diferentes. Não é uma troca trivial, e é exatamente por isso que só faz sentido em escala extrema: para a maioria das equipes, o custo de manter uma engenharia de infraestrutura dedicada ainda supera o que se economiza saindo de um serviço gerenciado.
Dois engenheiros, dois meses e agentes de IA
Um detalhe chamou atenção no anúncio: segundo Aravind Srinivas, CEO da Perplexity, as 40 mil linhas de Rust que compõem o CobbleDB foram escritas em dois meses por apenas dois engenheiros de sistemas, trabalhando ao lado de um enxame autônomo de agentes de codificação por IA que cuidou de testes de integração, monitoramento de build e runbooks operacionais. A empresa também sinalizou planos de abrir o código do CobbleDB, sem data definida até o momento.
O que fica para quem constrói no Brasil
O case da Perplexity não é um convite genérico para abandonar bancos gerenciados: a decisão só se paga acima de centenas de milhares de requisições por segundo, quando a tarifação por byte transferido de um serviço como o DynamoDB deixa de ser marginal e vira linha relevante da conta de nuvem. Para a maioria dos times, migrar para um banco caseiro trocaria um problema de custo por um problema de operação (gestão de nós, backup, rebalanceamento) que poucas equipes têm braço para sustentar.
O que vale a pena levar é o padrão arquitetural: separar armazenamento durável (aqui, o Pillar) de uma camada de serving otimizada só para leitura em lote de baixa latência (o CobbleDB) é uma estratégia replicável em qualquer sistema que sofre com hot paths de leitura competindo com pipelines de escrita pesada, mesmo em stacks bem mais modestas que a da Perplexity. Vale também estudar as técnicas específicas do CobbleDB: hedged reads para cortar cauda de latência, RocksDB com MultiGet em lote para eliminar round-trips, e a escolha consciente de trocar consistência forte por disponibilidade e velocidade quando o domínio do problema tolera atraso de replicação.
O uso de agentes de IA como parte do time de engenharia de sistemas, não só para gerar código de aplicação mas para testes de integração e runbooks operacionais de um banco de dados de produção, também é um sinal do que já está acontecendo em equipes de infraestrutura de ponta e deve seguir sendo notícia por aqui. Fica em aberto quando e como a Perplexity vai efetivamente abrir o código do CobbleDB, algo que, se e quando acontecer, merece cobertura própria.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Lovable atinge US$ 600 milhões em receita anualizada com aposta no vibe coding
A startup sueca, que virou sinônimo de 'programar por intenção', saltou de US$ 500 milhões para US$ 600 milhões em ARR em três meses e diz que dois terços das Fortune 500 já usam sua plataforma.