PMM 3.7 traz Real-Time Analytics para rastrear operações ao vivo no MongoDB
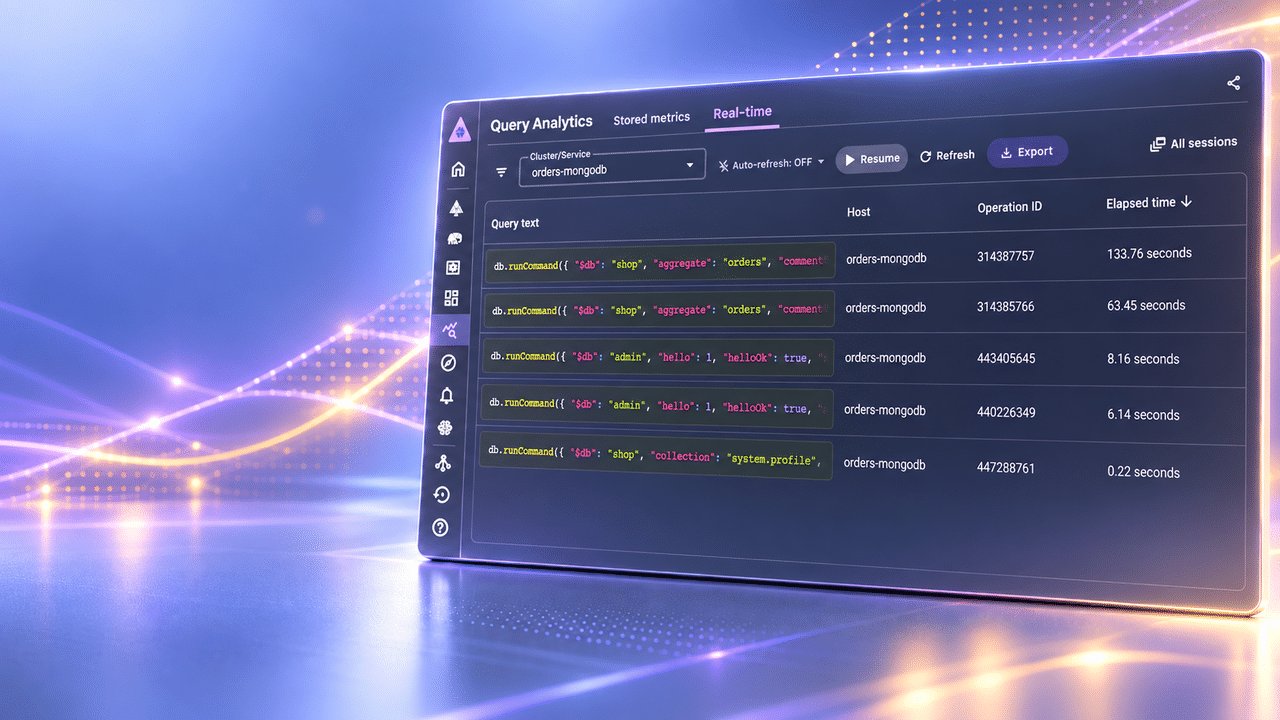
O recurso Real-Time Analytics, disponível desde a versão 3.7.0 do Percona Monitoring and Management, mostra operações do MongoDB em andamento a cada dois segundos, sem precisar ficar rodando `db.currentOp()` na mão durante um incidente.
O problema: o db.currentOp() em loop
Todo DBA conhece a cena. A aplicação fica lenta, o canal da equipe pega fogo e alguém faz a pergunta de sempre: o que está rodando no banco agora? O Query Analytics (QAN) do Percona Monitoring and Management (PMM) resolve bem a metade histórica dessa pergunta, mostrando quais consultas consumiram mais tempo na última hora ou nas últimas 12 horas.
O problema é que o QAN trabalha só com operações que já terminaram. O MongoDB↳MongoDB19 conteúdosMongoDB e LGPD: Quais os recursos disponíveis?Data · jul 2019Laravel & MongoDB: saiba mais sobre embedded documentsData · abr 2021LEFT JOIN no MongoDB, não é magia… É Aggregation Framework!!!Data · set 2019Ver tudo em Data → só registra uma operação no profiler ou no log de diagnóstico quando ela é concluída, então uma agregação que está rodando há dois minutos e ainda não acabou simplesmente não aparece ali. Até a versão 3.7.0 do PMM, a saída manual para esse buraco era abrir o mongosh, rodar db.currentOp(), rolar um JSON gigante e repetir o processo a cada poucos segundos para ver se a operação ainda estava viva.
Tibor Korocz, engenheiro da Percona, descreveu esse ritual em post publicado em 6 de outubro de 2026 no blog da empresa, e é a partir dele que vale entender o recurso que chegou para substituir essa rotina: o Real-Time Query Analytics, ou RTA.
QAN mostra o passado, RTA mostra o agora
Em uma frase: o RTA exibe toda operação do MongoDB que está rodando neste exato instante, atualizando a lista a cada dois segundos (intervalo configurável), e esquece cada operação assim que ela termina. Depois disso, se a operação gerou carga relevante, ela aparece no QAN normalmente, como sempre apareceu.
Os dois recursos são complementares, não concorrentes:
| Query Analytics (QAN) | Real-Time Analytics (RTA) | |
|---|---|---|
| O que mostra | Consultas finalizadas, agrupadas por fingerprint | Operações rodando agora, uma linha por operação |
| Fonte no MongoDB | Profiler ou slow query log | $currentOp, a cada 2 segundos |
| Armazenamento | ClickHouse, com retenção | Só em memória |
| Responde | "O que ficou lento ontem à noite?" | "O que está lento agora?" |
Por baixo do capô, um agente novo dentro do pmm-agent, chamado rta-mongodb-agent, roda a agregação $currentOp no banco admin a cada dois segundos. O resultado vai para o PMM Server e vive só em memória: nada é escrito no ClickHouse, e um snapshot antigo é descartado depois de 30 segundos. Por enquanto o RTA funciona apenas com MongoDB; suporte a MySQL e PostgreSQL está planejado, sem data divulgada.
Como habilitar o recurso
A boa notícia é que não há nada para instalar à parte. Se o PMM já monitora o seu MongoDB, o RTA reaproveita a mesma conexão e as mesmas credenciais do exporter do MongoDB. Os pré-requisitos são:
- PMM Server e PMM Client na versão 3.7.0 ou mais recente. A recomendação de Korocz é ir direto para a 3.9.0 ou superior, porque foi nela que chegou a exportação em CSV.
- O usuário do MongoDB que o PMM já usa precisa do privilégio
inprogpara rodar$currentOpcomallUsers: true; esse privilégio já vem com o papelclusterMonitor, que é o recomendado na documentação oficial do PMM. - Papel de Admin no PMM para iniciar ou parar uma sessão. Usuários com papel de Viewer só conseguem acompanhar sessões já em andamento.
Com isso em mãos, o caminho é:
- Abrir Query Analytics e ir na aba Real-time.
- Escolher um cluster ou um serviço no campo Cluster/Service (escolher o cluster seleciona todos os serviços dele).
- Clicar em Start session.
O PMM cria um rta-mongodb-agent para o serviço escolhido, visível depois em pmm-admin list. Em um replica set, é preciso iniciar uma sessão para cada membro que se quer observar; escolher o cluster inteiro faz isso automaticamente. Um detalhe importante: a sessão não para sozinha, ela roda até alguém encerrá-la na página All sessions, e aí para para todo mundo que estava vendo. Enquanto ela existe, o agente consulta o MongoDB a cada dois segundos, então vale encerrar sessões que não estão mais em uso. Para ajustar esse intervalo (o mínimo é um segundo):
pmm-admin inventory change agent rta-mongodb-agent <agent-id> --collect-interval=5sUm caso prático: a agregação que nunca aparecia
Para demonstrar o fluxo completo, Korocz montou um laboratório com Percona Server for MongoDB 8.0, uma coleção shop.orders com 4 milhões de documentos e três aplicações fictícias conectadas ao mesmo banco: orders-api, checkout-service e reporting-job. A reporting-job roda periodicamente uma verificação de clientes duplicados.
Ao iniciar a sessão de RTA, a tabela mostra toda operação em voo, atualizada por padrão a cada dois segundos. Ordenando pela coluna de tempo decorrido, duas agregações sobre orders aparecem no topo: uma rodando havia quase dois minutos, outra havia 49 segundos. Também aparecem comandos hello (drivers esperando mudança de topologia) e uma leitura em system.profile, que é o próprio agente de QAN do PMM monitorando o banco, e podem ser ignorados.
Clicar na linha mais demorada abre um painel de detalhes, e a captura pausa para a linha não sumir da tela enquanto se lê. Nesse painel está a evidência completa:
- Plan summary
COLLSCAN: uma varredura completa dos 4 milhões de documentos. - Client app name
reporting-job: identifica quem disparou a consulta. - O pipeline começa com um
$lookupdeorderscom ela mesma, usandocustomer.email, campo sem índice. maxTimeMS: 240000: o MongoDB mata a operação em quatro minutos, e o job simplesmente dispara ela de novo.
O QAN até mostraria essa agregação, mas só depois que ela terminasse. O RTA mostra enquanto ela roda, com cliente, plano de execução e comando completo; a aba Raw data traz o documento $currentOp inteiro, locks incluídos.
O que fazer (e não fazer) com o culpado em mãos
O RTA não tem botão de matar operação, e essa ausência é proposital. Se for mesmo necessário interromper, copia-se o Operation ID e roda-se o comando manualmente:
db.killOp(314387757)Vale cautela redobrada antes disso, principalmente se a operação for uma escrita: matar o processo só compra tempo, porque o job volta a disparar a mesma consulta no próximo ciclo. A correção de fato, no caso do laboratório, é criar o índice que falta no campo usado pelo $lookup:
db.orders.createIndex({ "customer.email": 1 })Como o RTA não guarda nada, quem precisa levar a evidência para um post-mortem no dia seguinte deve clicar em Pause e depois em Export. O CSV gerado traz todas as linhas que passaram pelo filtro aplicado, em todas as páginas, com a consulta bruta incluída, útil tanto para relatório de incidente quanto para compartilhar com um colega ou com o suporte da Percona.
Limitações que valem a pena conhecer antes do próximo incidente
Em resumo: o RTA é poderoso, mas tem fronteiras claras que mudam como confiar nele durante uma crise.
- Funciona só com MongoDB por enquanto, e exige PMM Client 3.7.0 ou mais recente no serviço monitorado.
- É uma fotografia a cada dois segundos: operações com menos de 10ms, ou que começam e terminam entre dois polls, nunca aparecem ali, e continuam sendo trabalho do QAN.
- Nada fica armazenado: quando a operação termina, ela some do RTA também, a menos que alguém tenha pausado e exportado antes.
- O texto da consulta é reconstruído a partir do documento de comando, então pode parecer diferente do que a aplicação enviou (agregações aparecem como
db.runCommand(...)); a aba Raw data mantém o original. - Quem abrir a página vê valores brutos, incluindo dados sensíveis como endereços de e-mail de cliente no laboratório de Korocz; é um ponto de atenção para ambientes de produção com dados reais.
- Sessões ficam rodando até alguém parar manualmente, consumindo ciclos de consulta no banco a cada intervalo configurado.
O que muda para quem opera MongoDB em produção
Para quem mantém aplicações sobre MongoDB, o ganho prático do RTA é reduzir o tempo entre "o banco está lento" e "achei a causa" sem precisar manter uma sessão de mongosh aberta rodando db.currentOp() em loop manual. No exemplo do laboratório, o caminho inteiro, do alerta de lentidão até identificar o COLLSCAN sem índice disparado pela reporting-job, é descrito como levando menos de um minuto.
Isso não elimina a necessidade de entender plano de execução e modelagem: o RTA aponta o sintoma com precisão, mas a correção continua sendo a mesma de sempre, um índice bem desenhado no campo certo. Vale também observar as limitações de retenção e de exposição de dados brutos antes de liberar acesso de Viewer a times maiores, especialmente em bancos com informação sensível de cliente. A documentação completa do recurso está publicada no site da Percona, junto com o fórum oficial do PMM para quem já roda o RTA em produção e quer trocar experiências.
Fonte: Percona Database Blog
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Como o Postgres decide quantos workers usar num scan paralelo
Um artigo técnico de Christophe Pettus detalha min_parallel_table_scan_size e min_parallel_index_scan_size: os dois parâmetros do PostgreSQL que definem o piso de uma varredura paralela, e por que zerá-los sem critério pode piorar a performance.