Como o Postgres decide quantos workers usar num scan paralelo
Um artigo técnico de Christophe Pettus detalha min_parallel_table_scan_size e min_parallel_index_scan_size: os dois parâmetros do PostgreSQL que definem o piso de uma varredura paralela, e por que zerá-los sem critério pode piorar a performance.
O PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → tem dois parâmetros com nome parecido e função fácil de confundir: min_parallel_table_scan_size e min_parallel_index_scan_size. Um artigo recente de Christophe Pettus, consultor da PGX Inc. publicado na série "All Your GUCs in a Row" no Planet PostgreSQL, desmonta os dois com testes práticos. A conclusão central interessa a qualquer pessoa que já tenha pensado em "ligar o paralelismo" numa query lenta sem entender o que isso de fato muda no plano de execução.
Os nomes dizem "mínimo", e os dois de fato definem um piso: um scan que o planner espera ler menos que min_parallel_table_scan_size de uma tabela (padrão de 8MB) ou menos que min_parallel_index_scan_size de um índice (padrão de 512kB) nem entra na lista de planos paralelos possíveis. Essa é a parte documentada. A parte que o artigo escancara é que o mesmo valor também é o primeiro degrau da escada que o planner sobe para decidir quantos workers pedir, então mexer no mínimo mexe em todos os degraus acima dele.
A escada de workers
O cálculo é simples de descrever e fácil de errar na cabeça: o planner começa em min_parallel_table_scan_size, triplica esse valor sucessivamente até ultrapassar o tamanho estimado da tabela, e conta quantos degraus subiu. Cada degrau é um worker a mais, até o teto de max_parallel_workers_per_gather. Pettus testou isso numa tabela de 116MB na versão 18.6, com o limite por gather em 16 e os custos de paralelismo zerados para isolar só o efeito da escada:
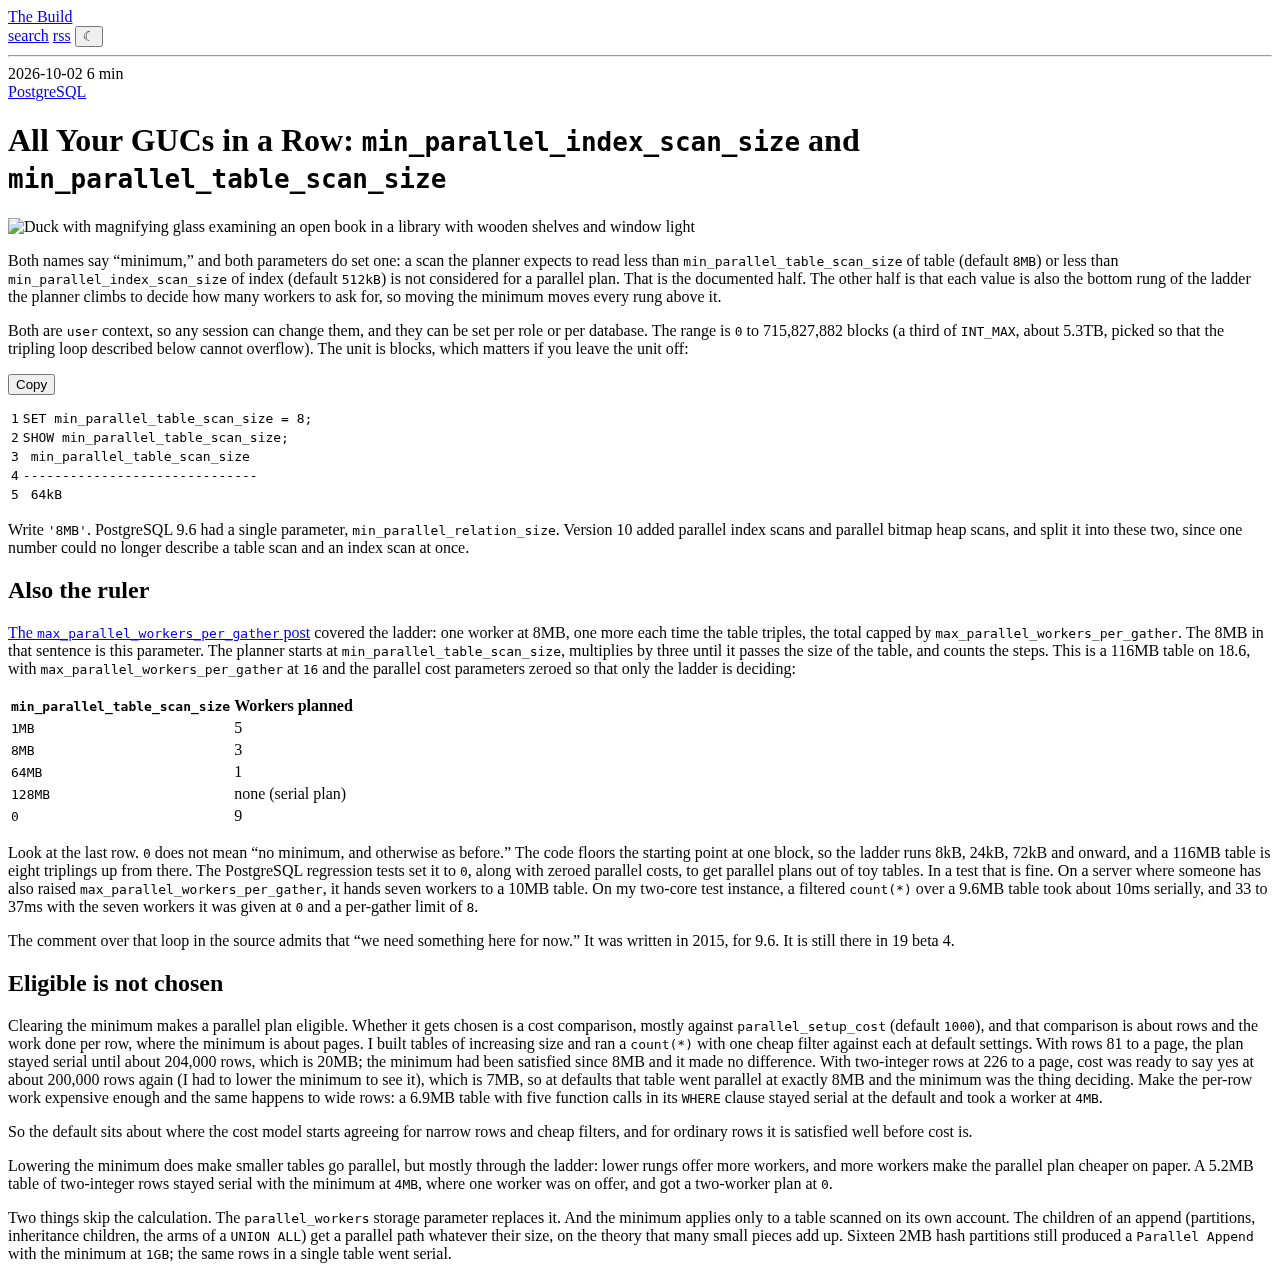
| min_parallel_table_scan_size | Workers planejados |
|---|---|
| 1MB | 5 |
| 8MB (padrão) | 3 |
| 64MB | 1 |
| 128MB | nenhum (plano serial) |
| 0 | 9 |
A última linha é o alerta do artigo. Zerar o parâmetro não significa "sem mínimo, e o resto como antes": o código tem um piso de um bloco, então a escada passa a correr a partir de 8kB, e uma tabela de 116MB fica oito triplicações acima disso, liberando nove workers onde o padrão liberaria três. Os testes de regressão do próprio PostgreSQL zeram esse parâmetro (junto com os custos de paralelismo) só para conseguir planos paralelos em tabelas de teste minúsculas. Em produção, com max_parallel_workers_per_gather também elevado, isso entrega sete workers para uma tabela de 10MB.
O autor mediu o efeito: num count(*) filtrado sobre uma tabela de 9.6MB, a execução serial levou cerca de 10ms; com sete workers concedidos pelo mínimo zerado e um limite de oito por gather, o tempo subiu para 33 a 37ms. O overhead de coordenar workers superou de longe o ganho de dividir o trabalho. O comentário no código-fonte sobre essa heurística é de 2015, para a versão 9.6, e segue intacto até a 19 beta 4:
Precisamos de algo aqui, por enquanto.
we need something here for nowcomentário no código-fonte do planner do PostgreSQL, citado por Christophe Pettus
Elegível não é o mesmo que escolhido
Limpar o mínimo só torna um plano paralelo elegível. Se ele é de fato escolhido é uma comparação de custo, principalmente contra parallel_setup_cost (padrão 1000), e essa comparação olha linhas e trabalho por linha, enquanto o mínimo olha páginas. Pettus construiu tabelas de tamanho crescente e rodou count(*) com um filtro barato em cada uma.
Com linhas estreitas (81 por página), o plano ficou serial até cerca de 204 mil linhas, ou 20MB: o mínimo já estava satisfeito desde 8MB, mas não fez diferença, porque o modelo de custo ainda dizia não. Com linhas de dois inteiros (226 por página), o custo passou a aceitar por volta de 200 mil linhas também, só que isso equivale a 7MB, então nessa tabela o plano virou paralelo exatamente nos 8MB do padrão, e aí sim foi o mínimo quem decidiu.
O padrão fica, portanto, perto do ponto em que o modelo de custo já concorda para linhas estreitas e filtros baratos. Para linhas comuns, o custo costuma concordar bem antes do mínimo. Baixar o mínimo em tabelas pequenas funciona principalmente por outro caminho: degraus mais baixos na escada oferecem mais workers, e mais workers tornam o plano paralelo mais barato no papel, mesmo sem nenhuma mudança real no trabalho por linha.
O que escapa do cálculo
Duas situações ignoram inteiramente essa conta, e vale conhecer as duas:
- O parâmetro de armazenamento
parallel_workers, definido por tabela, substitui o cálculo do mínimo e da escada. - Filhos de um append (partições, tabelas herdadas, braços de um
UNION ALL) recebem caminho paralelo qualquer que seja o tamanho individual, sob a lógica de que muitas peças pequenas somam.
O autor testou dezesseis partições de hash de 2MB cada: produziram um Parallel Append mesmo com o mínimo em 1GB, enquanto as mesmas linhas numa tabela única ficaram seriais. Uma tabela pequena ainda pode aparecer dentro de um plano paralelo sem virar o scan dividido entre workers: uma tabela de consulta de 48kB usada num join com uma tabela grande é lida inteira por cada worker, que é exatamente o comportamento desejado nesse caso.
O lado do índice
min_parallel_index_scan_size compara com a estimativa de páginas de índice que o scan vai ler, não com o tamanho total do índice. Numa tabela de cinco milhões de linhas com chave primária de 107MB, uma faixa de 20 mil ids (estimada em 54 páginas de índice) ficou serial, e uma faixa de 30 mil (estimada em 80 páginas) já pegou um worker, contra o padrão de 64 páginas.
Um index scan comum precisa passar nos dois mínimos, tabela e índice, e usa o menor número de workers entre os dois cálculos. A checagem de tabela usa uma estimativa pessimista de páginas de heap, então raramente é ela quem barra o plano: a faixa de 30 mil ids leu menos de 3MB de heap e ainda assim passou no mínimo de 8MB de tabela.
Um index-only scan é checado só contra o mínimo de índice, porque pode acessar quase nada do heap; nos testes, uma faixa cobrindo quatro milhões de linhas planejou quatro workers como index scan comum e cinco como index-only scan. Um parallel bitmap heap scan inverte a lógica: só o mínimo de tabela conta, contra páginas de heap estimadas, e o parâmetro de índice é ignorado, porque o bitmap index scan por baixo não é a parte paralelizada. B-tree é o único método de acesso com index scan paralelo, então, para efeito de consultas, esse parâmetro é especificamente um parâmetro de B-tree.
Além do planner de consultas
O CREATE INDEX lê min_parallel_table_scan_size da sessão e sobe a mesma escada para decidir quantos workers pedir na construção do índice. Isso significa que subir o valor em postgresql.conf para manter consultas pequenas seriais também torna seriais as construções de índice em qualquer tabela abaixo do novo valor, inclusive os índices recriados por um pg_restore. Com o mínimo em 1GB, builds de B-tree e BRIN numa tabela de 482MB deixaram de pedir worker paralelo.
O VACUUM, por sua vez, usa min_parallel_index_scan_size para decidir quais índices são grandes o suficiente para entrar num worker paralelo, mas aqui a comparação é com o tamanho real em disco, sem estimativa. Três índices de 456kB não receberam workers; depois de SET min_parallel_index_scan_size = 0, o VACUUM (PARALLEL 2) seguinte lançou os dois workers.
A versão 19 do PostgreSQL, ainda em beta no momento do artigo, adiciona dois leitores novos a essas regras: o parallel TID range scan, checado contra o tamanho total da tabela independente da faixa pedida, e o parallel autovacuum, que passa a aplicar o mesmo corte de índice do VACUUM manual.
O que fazer na prática
Em resumo, a recomendação do artigo é deixar os dois parâmetros no padrão. Se planos paralelos estão aparecendo em consultas pequenas demais para compensar o overhead, o ajuste certo é parallel_setup_cost, não o mínimo. Se tabelas grandes estão recebendo poucos workers, o ajuste é max_parallel_workers_per_gather.
O único trabalho que só esse parâmetro resolve é esticar a escada: quem subiu o limite por gather para 8 pensando nas tabelas grandes, e agora vê toda tabela de 1GB pedindo cinco workers, pode usar min_parallel_table_scan_size = '64MB' para trazer isso para três sem tocar no teto.
O preço é que toda varredura e toda construção de índice abaixo de 64MB também vira serial, então o ajuste deve ir no papel (role) que recebeu o limite maior, não em postgresql.conf de forma global. E se você encontrar qualquer um dos dois parâmetros zerado fora de uma suíte de testes, é sinal de que alguém copiou a configuração de lá sem entender o efeito colateral.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Por que max_wal_size do PostgreSQL não é um limite máximo nem o tamanho do WAL
O parâmetro que todo mundo lê como um teto de espaço na verdade é um gatilho de checkpoint. Entender a conta por trás dele evita tempestades de I/O e recovery mais longo do que deveria.