Percona ClusterSync for MongoDB 1.0 ganha failover automático ativo-standby
O PCSM 1.0.0 elimina o ponto único de falha que travava migrações de dias entre clusters MongoDB: agora várias instâncias disputam uma lease e assumem a réplica automaticamente quando uma cai.
O gargalo que forçava recuperação manual
O Percona ClusterSync for MongoDB↳MongoDB19 conteúdosMongoDB e LGPD: Quais os recursos disponíveis?Data · jul 2019Laravel & MongoDB: saiba mais sobre embedded documentsData · abr 2021LEFT JOIN no MongoDB, não é magia… É Aggregation Framework!!!Data · set 2019Ver tudo em Data → (PCSM) não é um substituto do replica set nativo do MongoDB: é uma ferramenta de migração, que clona um cluster inteiro e depois mantém os dois lados sincronizados via change streams enquanto o time decide o corte final. Segundo o post da Percona de 30 de setembro de 2026, assinado por Adnan Supic, esse processo de sincronização contínua costuma durar dias, não minutos.
Durante todo esse tempo, até a versão 0.9.0, o PCSM era um processo único. Se o host, container ou pod que executava a sincronização caísse, a replicação parava ali, sem aviso automático. Alguém precisava perceber a interrupção e recuperar o processo manualmente antes que a sincronização voltasse a correr. Para quem está no meio de uma migração de vendor lock-in com janela de corte definida, isso é risco operacional puro.
A versão 1.0.0 do PCSM resolve exatamente essa lacuna: não a alta disponibilidade do banco de destino, que o MongoDB já resolve com seu próprio replica set, mas a alta disponibilidade do agente de sincronização. É uma distinção que vale marcar antes de prosseguir, porque confundir as duas coisas leva a expectativa errada sobre o que a ferramenta cobre.
Eleição por lease, não por heartbeat ingênuo
A solução evita qualquer coordenador externo (nada de Zookeeper, etcd ou Consul): o próprio cluster MongoDB de destino guarda o estado de coordenação, no banco percona_clustersync_mongodb. Múltiplas instâncias do PCSM podem apontar para a mesma origem e o mesmo destino; apenas uma delas detém a lease e fica ACTIVE, executando a replicação. As demais ficam STANDBY, monitorando.
O documento de lease é pequeno e direto:
{
 "_id": "lease",
 "term": 7,
 "instanceId": "b3f1c2a4-9d7e-4c11-8a2f-1e6b0d5c9a77",
 "electionDate": { "$date": "2026-07-17T09:14:02.190Z" },
 "expiresAt": { "$date": "2026-07-17T09:20:41.882Z" }
}
A eleição acontece como uma única escrita condicional atômica: uma instância só assume a lease se a atual já expirou, e a expiração é avaliada pelo relógio do servidor MongoDB, não pelo relógio de cada host do PCSM. Isso é o detalhe que importa para quem desconfia de soluções distribuídas por padrão: o clock skew entre as máquinas que rodam o PCSM fica irrelevante, porque só o relógio do banco conta. Duas standbys concorrendo não conseguem vencer ao mesmo tempo.
Fencing por term: o problema do zumbi que ainda escreve
O cenário clássico de sistemas distribuídos é este: a instância ACTIVE trava (pausa de GC, partição de rede, pod reiniciado antes da lease expirar), a lease expira, uma standby é promovida, e então a instância antiga acorda e continua escrevendo como se nada tivesse acontecido. Sem proteção, isso corrompe o estado da nova ativa.
O PCSM evita esse risco com um fencing token clássico: o campo term é monotônico, incrementa a cada troca de ACTIVE para STANDBY, e é carimbado em toda escrita de checkpoint feita pela instância ativa, em percona_clustersync_mongodb.checkpoints. Quando a instância zumbi tenta escrever com um term desatualizado, o destino rejeita a escrita, a instância deposta percebe a rejeição e se auto-rebaixa para STANDBY. O estado da nova ativa nunca é corrompido por uma escrita tardia.
Recuperação por checkpoint: o que é coberto e o que não é
Na promoção, a nova instância ativa retoma a replicação a partir do último checkpoint persistido, o mesmo mecanismo de recuperação de falhas que o PCSM já usava, agora disparado de forma automática. Os tempos vêm fixos nesta versão: a lease tem TTL de 10 segundos, a ativa renova a cada 3 segundos, e cada instância emite heartbeat também a cada 3 segundos. Na prática, uma ativa derrubada à força é substituída em cerca do tempo de TTL da lease.
Há um limite explícito que todo operador precisa conhecer antes de confiar cegamente na HA: a cobertura automática vale para a fase de replicação contínua por change streams. O clone inicial, hoje, não é retomável. Se a ativa morre no meio do clone, uma standby ainda é promovida, mas detecta o clone interrompido durante a recuperação e falha de forma explícita, com o motivo exposto nos logs e no endpoint /status:
initial clone interrupted by failover and is not resumable; start a new run to re-clone from scratch
A recuperação, nesse caso, é um simples /start na nova ativa, que reinicia a sincronização do zero. O failover automático de fato só entra em ação depois que o clone termina e a replicação contínua começa.
Operando o cluster: API com envelope e três métricas
Cada instância mantém um documento de liveness em percona_clustersync_mongodb.members, e as respostas da API passam a incluir um envelope de cluster: quem é me, qual é o role, e a lista completa de membros vivos com host, porta e papel. Enviar um comando operacional (/start, /pause, /finalize) para uma standby retorna HTTP 409 com error: "not_active", já trazendo o mesmo envelope no corpo, para que o cliente localize a ativa e tente de novo sem adivinhação nem truque de DNS obsoleto.
Dois detalhes operacionais merecem nota:
- O envelope só aparece quando mais de um membro vivo é observado; uma instância solitária responde de forma idêntica à API anterior, então ferramentas existentes continuam funcionando sem alteração.
/metricsepprofsão servidos em qualquer papel, ativo ou standby.
Para limpeza de estado, dois comandos diretos atuam direto no destino, sem precisar de um servidor rodando: pcsm reset members e pcsm reset lease.
Três métricas Prometheus contam a história completa de um failover:
| Métrica | Tipo | O que mostra |
|---|---|---|
percona_clustersync_mongodb_ha_active | gauge | 1 se a instância é ativa, 0 se é standby |
percona_clustersync_mongodb_ha_term | gauge | term atual da lease (fencing) |
percona_clustersync_mongodb_ha_role_transitions_total | counter | trocas de papel na instância |
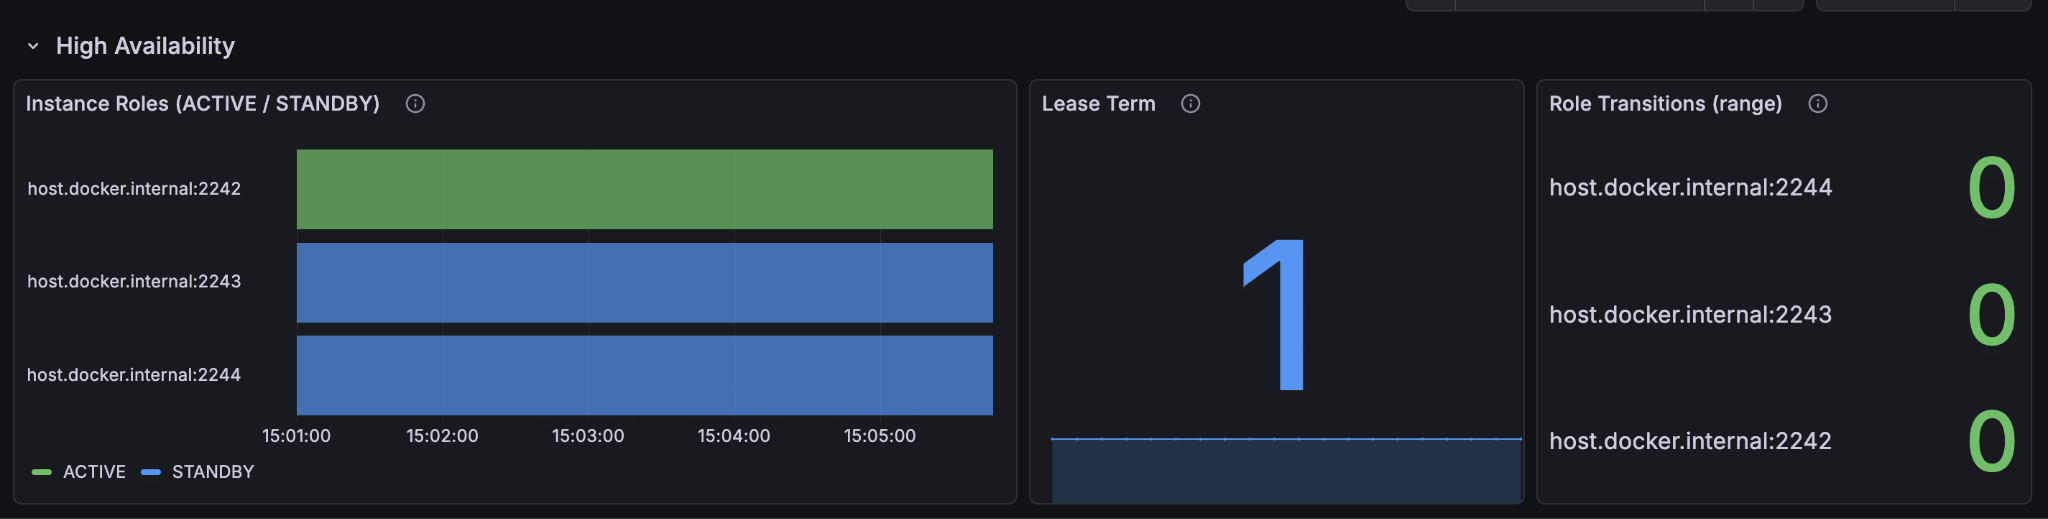
A Percona distribui um dashboard Grafana pronto no repositório do projeto, usando essas três métricas: a linha do tempo de ha_active por instância funciona como mapa do deployment e mostra quem está ativo e desde quando, ha_term mostra o term de fencing corrente, e a taxa de ha_role_transitions_total funciona como detector de flapping (zero é estável; número subindo é sinal de instabilidade).
Migrando da versão anterior
Um ponto de atenção para quem já roda PCSM em produção: o estado de replicação da versão 0.9.0 não é compatível com o 1.0.0. É preciso rodar pcsm reset contra o destino antes de iniciar a replicação com a nova versão. Depois disso, subir uma segunda instância apontando para a mesma origem e o mesmo destino já é suficiente:
pcsm --source "mongodb://src-mongos:27017" \
 --target "mongodb://tgt-mongos:27017"
Rodando o mesmo comando num segundo host, /status em qualquer uma das duas mostra uma ACTIVE e uma STANDBY. Matar a ativa faz a standby assumir a replicação a partir do último checkpoint em segundos.
Onde isso importa e onde não resolve sozinho
Em resumo: a HA do PCSM 1.0.0 vale para quem está no meio de uma migração longa entre clusters MongoDB, seja para trocar de provedor, seja para fugir de lock-in de nuvem, e não quer depender de um operador vigiando o processo 24 horas por dia. Para esse caso, o ganho é real: zero mudança de configuração para ativar, e failover automático na fase que mais importa, a replicação contínua.
O que o recurso não substitui é disciplina de operação ao redor da migração. O clone inicial continua sendo um ponto de atenção manual, o corte final (/finalize) continua exigindo validação de consistência por parte de quem opera, e nada aqui dispensa testar o plano de corte antes de rodar em produção com dados reais. HA no agente de sincronização reduz um risco específico; não elimina a necessidade de entender o plano de execução da migração como um todo antes de confiar nele.
Fonte: Percona Database Blog
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
REPACK CONCURRENTLY no PostgreSQL 19: o custo real de rodar em produção
Um benchmark detalhado do blog boringSQL mede o que o novo comando REPACK (CONCURRENTLY) do PostgreSQL 19 consome de WAL, memória e tempo de bloqueio enquanto roda, e compara o resultado com pg_repack e pg_squeeze.