PostgreSQL: por que max_wal_senders trava replicação e backup mesmo com conexões sobrando
Um post da série All Your GUCs in a Row, do consultor Christophe Pettus, mostra como o parâmetro que controla quantos processos podem ler o WAL tem vida própria desde o PostgreSQL 12, e por que subestimá-lo derruba backup, réplica e replicação lógica ao mesmo tempo.
Christophe Pettus, consultor especializado em PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data →, publicou no Planet PostgreSQL mais um capítulo da série All Your GUCs in a Row, desta vez sobre max_wal_senders. O texto abre corrigindo o próprio autor: o post anterior, sobre max_connections, recomendava dimensionar aquele parâmetro considerando "as conexões de replicação". Pettus é direto ao dizer que essa orientação está errada a partir do PostgreSQL 12: desde então, processos WAL sender têm pool próprio, e não tiram vaga de max_connections.
O parâmetro define quantos processos podem ler o WAL do servidor em nome de outra coisa. E essa lista de consumidores é maior do que a maioria assume. Segundo o post, cada pg_basebackup padrão usa duas conexões simultâneas (porque desde a versão 10 ele transmite o WAL numa conexão separada, com -X stream como padrão), cada assinatura de replicação lógica ocupa uma vaga para o worker de apply mais uma por tabela em cópia inicial, pg_receivewal e tudo construído sobre ele (o modo streaming do Barman, por exemplo) também entram na conta, e todo cliente que caiu da rede sem fechar o socket continua ocupando vaga até o wal_sender_timeout expirar.
O pool deixou de ser emprestado em 2019
Antes do PostgreSQL 12, um WAL sender tomava assento de max_connections, o que criava dois problemas: uma aplicação com muitas conexões abertas podia impedir um standby de se reconectar, e a soma de superuser_reserved_connections com max_wal_senders precisava caber dentro de max_connections sob pena do servidor nem subir. Pettus credita a Alexander Kukushkin a correção que deu aos WAL senders uma lista de vagas próprias.
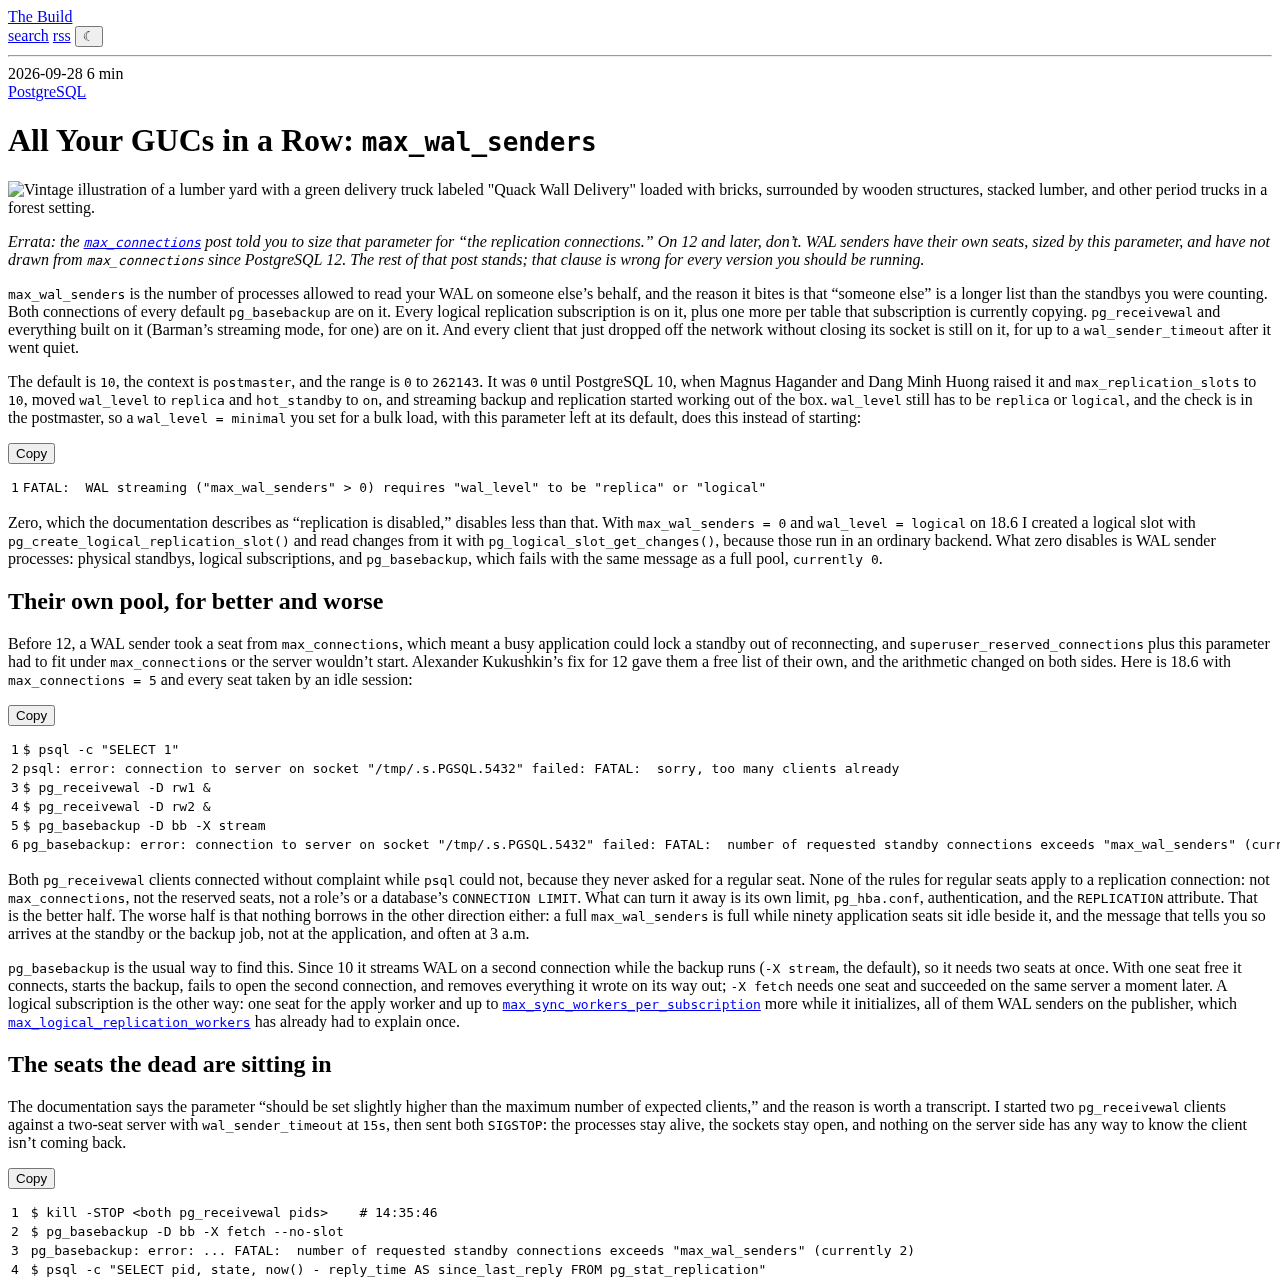
O post demonstra o efeito prático rodando o PostgreSQL 18.6 com max_connections = 5 e todas as vagas ocupadas por sessões ociosas. Um psql comum recebe FATAL: sorry, too many clients already, mas dois processos pg_receivewal conectam sem reclamar, porque nunca pediram vaga comum. Nenhuma regra de conexão regular vale para uma conexão de replicação:
Nenhuma das regras para vagas comuns vale para uma conexão de replicação: nem
None of the rules for regular seats apply to a replication connection: not max_connections, not the reserved seats, not a role's or a database's CONNECTION LIMIT.Christophe Pettus, consultor PostgreSQLmax_connections, nem as vagas reservadas, nem oCONNECTION LIMITde um papel ou de um banco.
A vantagem tem um custo simétrico: nada empresta vaga na direção contrária. Um max_wal_senders esgotado fica esgotado mesmo com noventa conexões de aplicação ociosas ao lado, e o erro aparece no job de backup ou no standby, não na aplicação, geralmente às três da manhã.
O basebackup falha e apaga o que já copiou
O exemplo do post é ilustrativo: com apenas uma vaga livre, pg_basebackup -D bb -X stream conecta, começa a cópia, falha ao abrir a segunda conexão necessária para o streaming de WAL e remove tudo o que já tinha escrito ao sair:
FATAL: number of requested standby connections exceeds "max_wal_senders" (currently 2)O mesmo comando com -X fetch precisa de apenas uma vaga e completa sem erro no mesmo servidor, um instante depois. Uma assinatura de replicação lógica segue lógica inversa: consome uma vaga para o worker de apply e mais uma por max_sync_workers_per_subscription durante a sincronização inicial das tabelas, todas contadas como WAL sender do lado do publisher.
O próprio wal_level entra na checagem: ele precisa estar em replica ou logical, e essa verificação acontece no postmaster. Um wal_level = minimal configurado para uma carga em lote, com max_wal_senders no padrão, falha ao subir com:
FATAL: WAL streaming ("max_wal_senders" > 0) requires "wal_level" to be "replica" or "logical"Curiosamente, zerar o parâmetro desabilita menos do que a documentação sugere: Pettus testou, com max_wal_senders = 0 e wal_level = logical na versão 18.6, criar um slot lógico com pg_create_logical_replication_slot() e ler mudanças com pg_logical_slot_get_changes(), porque essas funções rodam num backend↳Back-end49 conteúdosIntegração front-end com backend: 7 decisões que evitam caos entre APIs, BFF e GraphQLDev (Back & Front) · abr 2026Como criar uma FAKE API REST para testes — JSONPlaceholderDev (Back & Front) · set 2025Construindo um aplicativo de bate-papo de IA simples com Spring AI e AngularDev (Back & Front) · jul 2025Ver tudo em Dev (Back & Front) → comum. O que o zero desliga é especificamente processo WAL sender: standby físico, assinatura lógica e pg_basebackup.
O fantasma que ainda ocupa a cadeira
A documentação recomenda configurar o valor "um pouco acima do número máximo esperado de clientes", e o post explica por quê com um experimento. Pettus sobe dois clientes pg_receivewal contra um servidor com só duas vagas e wal_sender_timeout em 15 segundos, depois manda SIGSTOP nos dois processos: eles continuam vivos, os sockets continuam abertos, e o servidor não tem como saber que o cliente não vai voltar.
Um pg_basebackup tentado nesse momento falha imediatamente com o mesmo erro de pool cheio. Uma consulta a pg_stat_replication mostra as duas linhas em estado streaming, com reply_time cada vez mais velho, até o log registrar terminating walsender process due to replication timeout para as duas. Só depois disso o pg_basebackup repetido termina com sucesso, cerca de treze segundos após o início do teste.
A diferença importa: um processo cliente que morre fecha o socket e libera a vaga na hora. O fantasma é o que fica em silêncio sem fechar nada, seja um cabo puxado, uma VM congelada ou um NAT que expirou. No wal_sender_timeout padrão de um minuto, um standby que perdeu a rede e voltou precisa esperar seu próprio fantasma ser derrubado antes de reconectar, e se o pool estava dimensionado no limite, todo mundo espera junto.
Standby em cascata e o espelho obrigatório
Dois detalhes adicionais do post merecem atenção de quem opera topologia com mais de um nível de replicação. Um standby em cascata serve seus próprios downstream a partir do seu próprio max_wal_senders, então precisa de vagas para eles, não só para si mesmo.
E desde o PostgreSQL 12, um hot standby precisa ter max_wal_senders pelo menos tão alto quanto o do primário, pela mesma razão que vale para max_connections e max_prepared_transactions: o valor fica gravado em pg_control e no próprio WAL. Um standby que recebe do primário um valor maior do que o seu pausa a recuperação (nas versões 14 em diante; nas 12 e 13 ele simplesmente desliga) até ser reiniciado com um valor compatível. A saída mais simples, segundo o post, é copiar a configuração do primário para o standby e nunca deixar essa divergência surgir.
Quanto custa aumentar, e para quanto
Uma vaga de WAL sender custa, em memória compartilhada, o mesmo que uma conexão comum: na versão 18.6, mil vagas (de qualquer um dos dois tipos) somam 51 MB, e subir do padrão 10 para 60 custou 3,8 MB quando o autor mediu. O teto de 262143 existe porque um WAL sender conta, para fins de memória compartilhada, como um backend: os quatro grupos de backend do servidor precisam caber juntos sob esse limite (MAX_BACKENDS).
Dado o custo baixo e o fato de que corrigir o valor exige reiniciar o servidor, a recomendação do post é direta: configurar 50 em todos os nós, no mesmo restart em que se ajusta max_replication_slots, e então fazer a conta real somando standbys, duas vagas por backup simultâneo que rodaria, uma vaga por assinatura lógica mais seus workers de sincronização, uma por arquivador em streaming e uma margem para os fantasmas de um wal_sender_timeout. Se esse número chegar perto de 50, na visão de Pettus, a instalação já não era pequena mesmo.
Em resumo: para quem já roda alta disponibilidade, o risco não é o volume de tráfego de aplicação, e sim o número de fitas de replicação abertas ao mesmo tempo. Dimensionar max_wal_senders com folga custa poucos megabytes de memória e evita que um backup de rotina ou uma reconexão de standby vire incidente de madrugada.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Percona ClusterSync for MongoDB 1.0 ganha failover automático ativo-standby
O PCSM 1.0.0 elimina o ponto único de falha que travava migrações de dias entre clusters MongoDB: agora várias instâncias disputam uma lease e assumem a réplica automaticamente quando uma cai.