Como consolidar múltiplos bancos em um único Postgres com replicação lógica
Na segunda parte de sua série sobre replicação lógica, Dimitri Fontaine mostra como unir schemas de aplicações diferentes num warehouse Postgres e ainda republicar as mudanças como stream de CDC.
O cenário: três aplicações, um warehouse
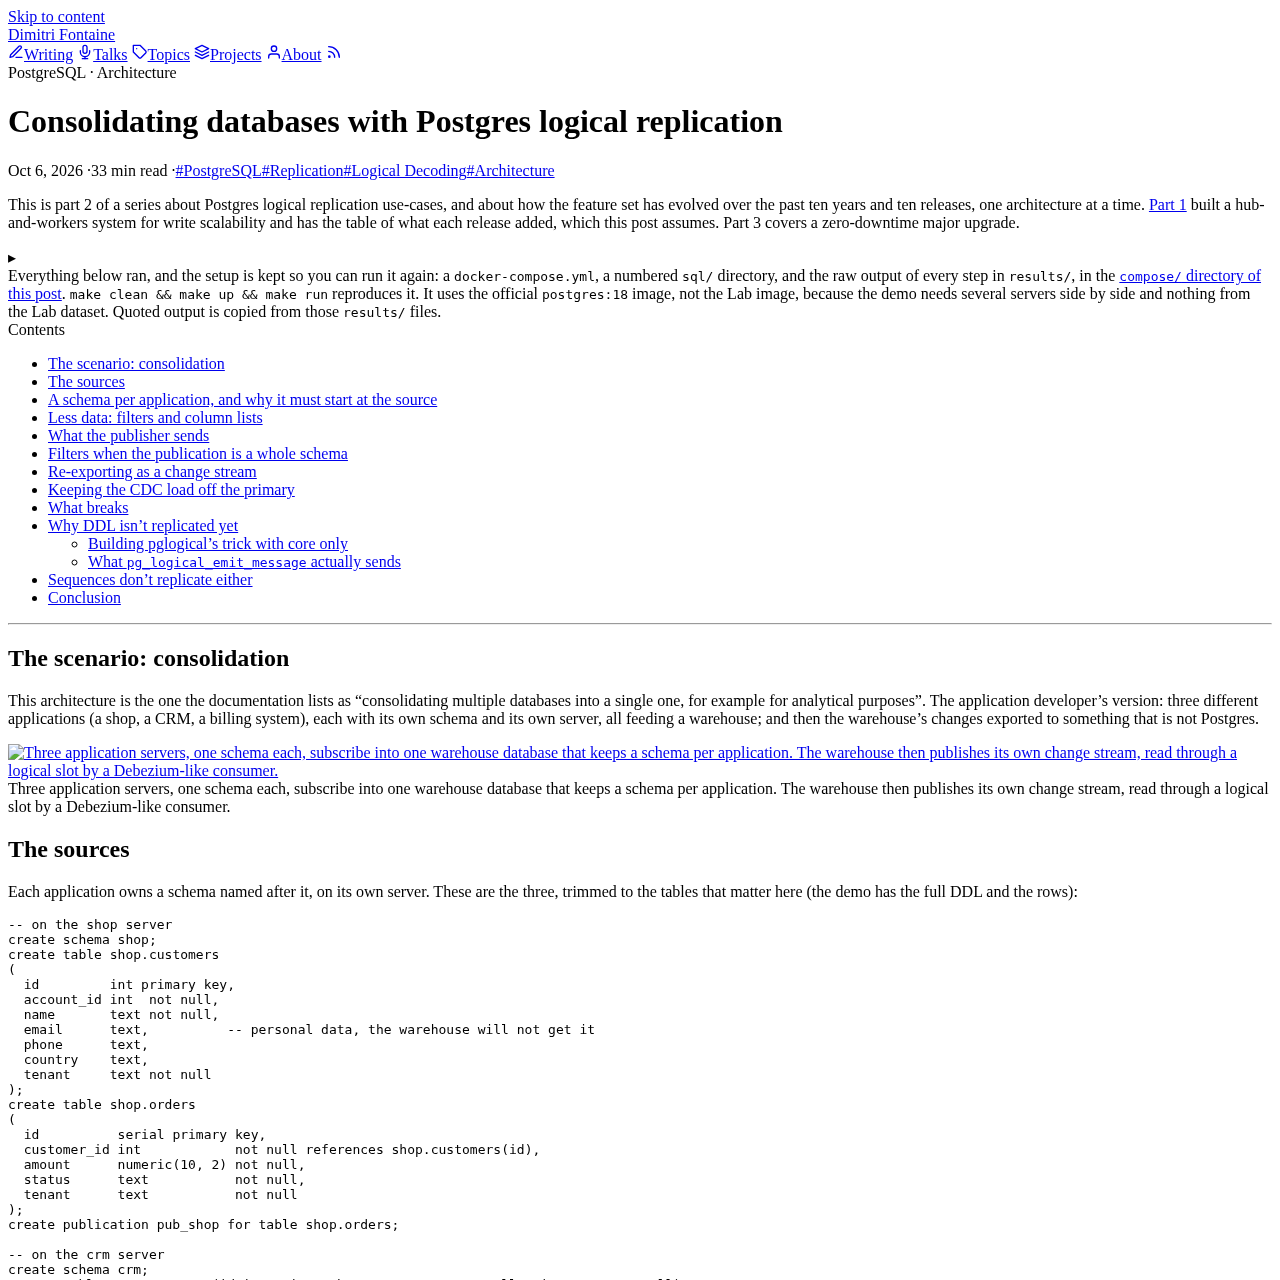
O consultor francês Dimitri Fontaine publicou no Planet PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → a segunda parte de uma série sobre replicação lógica, que já soma dez anos e dez versões de recursos acumulados. A primeira parte tratou de escalar escrita com um arquiteto hub-and-workers; a terceira promete cobrir upgrade de versão major sem downtime. Esta trata do caso que a própria documentação do Postgres cita como exemplo: consolidar múltiplas bases numa só, para fins analíticos.
O exemplo prático reúne três aplicações típicas de qualquer empresa: uma loja (schema shop), um CRM (schema crm) e um sistema de billing (schema billing), cada uma em seu próprio servidor com seu próprio schema. Cada servidor cria uma publication para suas tabelas relevantes, e o warehouse cria uma subscription por aplicação, com um role dedicado por assinatura. Depois da cópia inicial, os dados das três aplicações convivem lado a lado no warehouse, e cruzar receita de CRM com faturamento vira uma consulta SQL comum, sem ETL externo.
O schema não pode ser renomeado: a correção começa na origem
O ponto mais importante do artigo, e o que Fontaine chama de armadilha, é que uma subscription não tem como mapear nomes: ela procura, na origem, exatamente o schema.tabela que existe no destino. Quem tenta manter a tabela em public na aplicação e shopapp.orders no warehouse recebe um erro direto: ERROR: relation "public.orders" does not exist, e a assinatura nem chega a ser criada.
A solução que ele demonstra é mover a tabela para um schema próprio no publicador, não no assinante:
alter table public.orders set schema shopapp;

create role app_shop login;
alter role app_shop set search_path = shopapp;
Com o search_path do role ajustado, o SQL não qualificado da aplicação continua resolvendo normalmente, e a publication segue a tabela porque rastreia identidade de objeto, não nome. Quem ignora esse passo e tenta subir duas origens com public.customers homônimos recebe duplicate key value violates unique constraint na cópia inicial; esquemas diferentes com a mesma tabela e colunas divergentes travam com missing replicated column. Em ambos os casos, o problema não é da ferramenta: é de modelagem que já devia ter sido resolvida antes de qualquer replicação entrar em cena.
Menos dados na rede: column lists e row filters
Desde o Postgres 15, uma publication pode restringir tanto colunas quanto linhas. No exemplo, o warehouse europeu não pode receber e-mail e telefone dos clientes, nem linhas de clientes de fora da União Europeia:
alter publication pub_shop set table
 shop.orders where (tenant = 'eu'),
 shop.customers (id, account_id, name, country, tenant) where (tenant = 'eu');
A tabela-destino no warehouse é criada sem as colunas sensíveis, porque só recebe o que vai ser enviado. Fontaine verificou isso direto no protocolo, não apenas confiando na documentação: criou uma função que lê pg_logical_slot_get_binary_changes() com o plugin pgoutput e inspeciona os bytes de cada mensagem em busca de padrões de e-mail e telefone.
| Ação no publicador | Mensagens no slot | PII no fio |
|---|---|---|
| Update de coluna não publicada | BRUC | não |
| Update de coluna publicada, sem filtro | BRUC | sim (controle) |
| Linha que entra no filtro | BRIC (vira insert) | não |
| Linha que sai do filtro | BRDC (vira delete) | não |
O comportamento de linha que entra ou sai do filtro é o detalhe que mais interessa a quem for operar isso em produção: Postgres converte a mudança de tenant em um insert ou delete lógico, para que o warehouse acompanhe a entrada e a saída da linha do recorte.
A pegada do replica identity
Filtrar por uma coluna que não faz parte da chave primária quebra a replicação na primeira alteração seguinte. Como o filtro usa tenant, e a replica identity padrão é a própria chave primária (sem tenant), qualquer update no publicador falha com Column used in the publication WHERE expression is not part of the replica identity. A correção é a mesma do primeiro artigo da série: criar um índice único que contenha a coluna do filtro e declará-lo como replica identity.
create unique index orders_id_tenant on shop.orders (id, tenant);
alter table shop.orders replica identity using index orders_id_tenant;
Para quem administra bancos há tempo suficiente, essa exigência não deveria surpreender: um filtro lógico sobre uma coluna é, na prática, um predicado de consulta, e todo predicado de consulta precisa de um índice que o sustente. É o mesmo raciocínio do plano de execução aplicado à replicação.
O que já estava lá não se move sozinho
Outro ponto que o texto deixa explícito: alter subscription ... refresh publication só copia tabelas novas na assinatura. Um filtro adicionado depois que a tabela já replicava não se aplica retroativamente: a linha que foi copiada antes do filtro existir permanece no warehouse e para de receber atualizações, porque as mudanças seguintes são descartadas na origem. Fontaine mostra isso com um pedido feito depois do filtro: o status antigo (paid) continua no warehouse mesmo depois de a origem mudar para shipped. Quem depende de dados consistentes precisa limpar essas linhas manualmente ou configurar o filtro antes da primeira cópia.
Limitação quando a publicação cobre um schema inteiro
A publication do tipo for tables in schema é cômoda porque tabelas novas entram automaticamente, sem alterar a definição. O preço é que ela não aceita column list: tentar restringir colunas de crm.contacts dentro dessa publicação retorna erro, e a única saída é abandonar a forma por schema e listar as tabelas manualmente, perdendo o comportamento automático para tabelas futuras.
Reexportando o warehouse como stream de CDC
A parte mais relevante do artigo para quem constrói pipelines de dados vem depois: os workers de aplicação que escrevem no warehouse geram WAL como qualquer outra sessão. Isso significa que o warehouse pode ter sua própria publication e um slot lógico lido por um consumidor no estilo Debezium, misturando os dados que vieram das três origens com o que é escrito diretamente ali.
O detalhe que pega quem não lê a letra miúda é a opção origin, disponível desde o Postgres 16. Ela existe para evitar loops de replicação, mas também filtra dados replicados por padrão: com origin = none, o consumidor só vê o que foi escrito localmente no warehouse; com origin = any, vê tudo, inclusive o que chegou pelas assinaturas. Um consumidor de uma base consolidada precisa pedir explicitamente any, ou vai achar que o pipeline está quebrado quando na verdade está filtrando por desenho.
Transações grandes chegam antes do commit
Desde o Postgres 14, transações grandes fazem streaming para o consumidor lógico antes mesmo de serem confirmadas na origem, controlado por logical_decoding_work_mem. No teste descrito, uma transação de vinte mil linhas chega ao slot em blocos enquanto ainda está aberta na origem, mesmo sem essas linhas estarem visíveis no warehouse. Se a transação original sofrer rollback, o consumidor recebe uma mensagem de aborting streamed (sub)transaction e precisa descartar tudo que já tinha processado. É um comportamento que qualquer consumidor baseado nesse protocolo, Debezium incluído, já precisa tratar, mas que normalmente só aparece em volumes de produção, não em testes pequenos.
Tirando a carga de CDC do primário
Também desde a versão 16, um slot lógico pode viver numa réplica física, não apenas no primário. O standby reporta suas necessidades ao primário via hot_standby_feedback, para que o primário preserve as linhas de catálogo que o slot precisa decodificar. A criação é feita com pg_basebackup, combinando -R (grava a configuração de recovery) com -C -S (cria o slot físico no primário):
pg_basebackup -h warehouse -U postgres -D $PGDATA -X stream -R -C -S standby1Isso tira do primário o custo de decodificação lógica do CDC, deixando-o livre para as cargas transacionais que de fato precisam dele.
Quando vale a pena e quando não vale
Em resumo: esse desenho funciona bem quando o número de origens é pequeno, conhecido e estável, e quando o time quer um banco consolidado consultável por SQL comum, sem depender de uma camada de streaming externa. Ele exige, porém, intervenção manual em pontos que um pipeline de ETL tradicional resolveria de outra forma: DDL não replica, então evolução de schema precisa de coordenação explícita entre origem e destino; renomear tabela ou mover schema é mudança que começa na aplicação, não no warehouse; e filtros, listas de colunas e exclusões de PII só valem a partir do momento em que são configurados, nunca retroativamente.
Para quem avalia essa arquitetura, a lição de fundo do artigo de Fontaine é mais ampla que qualquer flag de configuração: antes de pensar em volume, round-trip de rede ou throughput de CDC, é preciso resolver a modelagem na origem. Um schema malfeito em public, uma chave primária que não cobre o filtro de negócio ou uma replica identity ausente não são detalhes de implementação, são a causa raiz de toda réplica que para de funcionar.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
No PostgreSQL, um min_wal_size baixo pode dobrar a latência de cauda
O parâmetro min_wal_size do PostgreSQL não guarda WAL para standby, apenas evita recriar segmentos sob demanda. Um teste de carga do consultor Christophe Pettus mostra o que isso custa quando o piso fica baixo demais.