Thread pool no Percona Server: como configurar para ganhar throughput sob alta concorrência
Benchmark da Percona mostra que o thread pool pode multiplicar o throughput por quase 18 vezes em cenários de alta concorrência, mas também pode piorar o desempenho se mal configurado. Entenda os parâmetros que decidem o resultado.
O contexto: thread pool deixou de ser exclusividade paga
Até a versão 26.7.0 / 9.7.2 do MySQL↳MySQL8 conteúdosMySQL + Adminer + Docker Compose: montando rapidamente um ambiente para usoData · abr 2019Banco de dados MYSQL no PHPStormDev (Back & Front) · jul 2019Criando um ambiente de desenvolvimento PHP mínimo com Docker – Parte 3Dev (Back & Front) · out 2019Ver tudo em Data → Community, lançada em julho de 2026, quem queria thread pooling nativo e gratuito tinha três caminhos: o plugin do Percona Server for MySQL, o recurso embutido no MariaDB ou plugins de terceiros como o xiezhenye/mysql-plugin-threadpool, disponível no GitHub. O plugin oficial da Oracle sempre existiu, mas era restrito ao MySQL Enterprise Edition.
Com o recurso agora disponível também no MySQL Community, a Percona publicou um benchmark comparando a própria implementação de thread pool com a nova opção do MySQL Server. Este primeiro artigo da série, assinado por Bogdan Degtyariov e publicado em 5 de outubro de 2026, foca exclusivamente no Percona Server: como o thread pool funciona por dentro e quais combinações de parâmetros realmente entregam ganho. A comparação direta entre Percona Server e MySQL Server fica para a Parte 2.
Para quem já roda Percona Server em produção, ou pensa em migrar, o valor deste material está menos no anúncio e mais na tabela de configurações: o benchmark deixa claro que ligar o thread pool sem critério pode, sim, piorar o desempenho.
Por que o modelo padrão de threads quebra sob carga
Por padrão, o MySQL cria uma thread dedicada para cada conexão de cliente, executa as queries e destrói a thread quando a conexão termina. Esse modelo é simples e funciona bem com poucas conexões simultâneas.
O problema aparece quando o número de conexões cresce muito além do número de núcleos de CPU disponíveis. Criar, destruir e trocar contexto entre milhares de threads consome recursos do sistema e gera contenção, derrubando o throughput justamente no momento em que mais se precisa dele.
O thread pool ataca esse problema reutilizando um conjunto fixo de threads pré-criadas para atender múltiplas conexões, em vez de criar uma thread por conexão.
Como o thread pool do Percona Server funciona
O mecanismo se organiza em quatro peças que trabalham juntas:
- Thread groups: o pool divide as threads em grupos distintos, cada um associado a um núcleo de CPU específico. Por isso o número de grupos costuma se aproximar do número de núcleos físicos (ainda que, como o benchmark mostra, nem sempre o ideal seja igual ao número de núcleos).
- Round-robin: as conexões de clientes são distribuídas igualmente entre os grupos conforme chegam.
- Listening e enfileiramento: dentro de cada grupo, uma thread listener monitora as queries de entrada e as coloca numa fila de alta prioridade (queries dentro de uma transação ativa) ou numa fila normal/baixa prioridade.
- Execução e reuso: as worker threads retiram queries das filas, priorizando as de alta prioridade, executam e esperam pela próxima requisição em vez de encerrar.
Esse desenho evita o custo de criar e destruir threads a cada conexão, mas introduz uma variável nova: o tamanho e a forma do pool importam tanto quanto o hardware disponível.
Os três parâmetros que decidem o resultado
O benchmark variou três configurações-chave do Percona Server. Entender o papel de cada uma é o que separa um tuning eficaz de um ajuste que piora as coisas:
| Parâmetro | Faixa testada | O que controla |
|---|---|---|
thread_pool_size | 10 / 20 / 40 / 80 / 120 / 160 | Número de thread groups no pool |
thread_pool_max_threads | 12000 | Número máximo de threads no pool |
thread_pool_oversubscribe | 2 / 3 / 4 | Threads que podem ficar ativas simultaneamente dentro do mesmo grupo |
A linha de base de comparação foi thread_handling=one-thread-per-connection (thread pool desligado). Com o pool ativo, thread_handling=pool-of-threads. O teste com thread_pool_size=5 também foi feito, mas o resultado foi ruim o bastante para ficar fora do relatório final.
Como o benchmark foi montado
O teste usou sysbench OLTP Read-Write contra Percona Server for MySQL 9.7.1-1, rodando em um servidor Intel Xeon Gold 6230 (2x20 núcleos, hyper-threading, 80 CPUs lógicas), 187 GiB de RAM e armazenamento NVMe SSD de 2,9 TB, sobre Ubuntu 24.04 com kernel 6.8.0-60-generic.
O dataset tinha 24 GB (100 milhões de linhas) distribuídos em 20 tabelas fixas. A concorrência variou de 40 a 5120 threads de clientes simultâneos, e a relação entre buffer pool e tamanho dos dados foi testada em três cenários: 1:12 (I/O bound, buffer de 2G), 1:2 (parcialmente bufferizado, 12G) e 1:1 (totalmente bufferizado, 32G). Cada execução teve 10 minutos de ramp-up e 15 minutos de janela de medição, com uma única rodada por configuração.
O ganho de até 18 vezes, e onde ele aparece
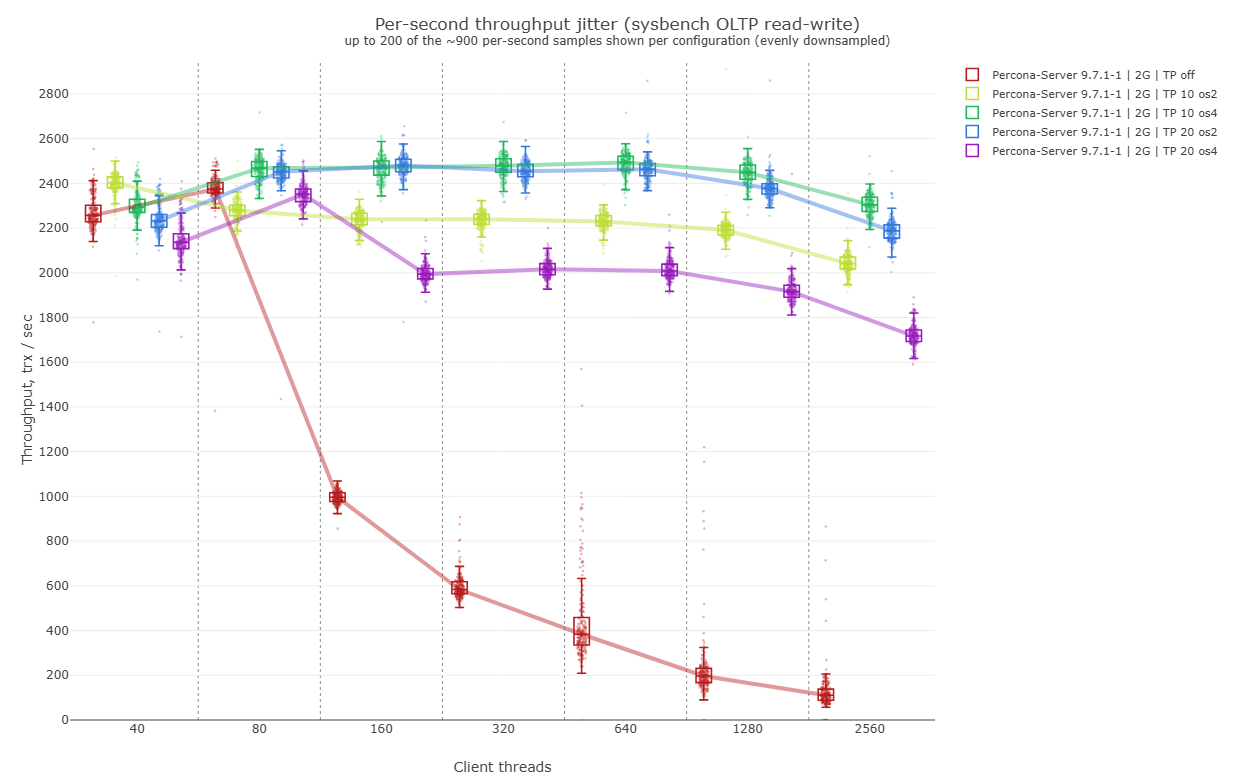
A configuração mais eficiente encontrada foi thread_pool_size=10 combinado com thread_pool_oversubscribe=4, no cenário I/O bound (buffer de 2G contra dataset de 24G). Com 2560 conexões simultâneas, essa combinação entregou 2304 TPS contra apenas 129 TPS sem thread pool: 17,9 vezes mais rápido.
Mas o ganho não é linear nem garantido:
- Em baixa concorrência (40 a 80 conexões), o efeito do thread pool é pequeno; ele só se destaca a partir de 120 conexões, quando a configuração sem pool começa a despencar.
- Aumentar
thread_pool_sizealém do ponto ótimo piora o resultado: as curvas com 40, 80, 120 e 160 grupos ficaram todas abaixo da curva com 10 grupos, mesmo havendo 40 núcleos físicos disponíveis. - Trocar
thread_pool_oversubscribe=4porthread_pool_oversubscribe=2na mesma configuração (thread_pool_size=10) já custou 11% de TPS (2304 contra 2043).
Com buffer parcial (12G, cobrindo metade do dataset), o ótimo muda: thread_pool_size=20 passa a ser a melhor configuração, não mais 10. Ou seja, não existe receita fixa: o valor certo de thread_pool_size depende da relação entre buffer pool e tamanho dos dados em cada carga de trabalho.
Quando o dataset cabe inteiro no buffer, o thread pool perde na métrica bruta
Com o dataset totalmente bufferizado (32G de innodb_buffer_pool_size para 24G de dados), a configuração sem thread pool venceu em TPS bruto em todas as faixas de conexão testadas. A maior diferença aparece entre 80 e 640 conexões; depois disso, todas as configurações convergem para cerca de 16 mil TPS.
Nesse cenário, variar thread_pool_oversubscribe praticamente não teve efeito. E a configuração com thread_pool_size=10, que era a campeã no cenário I/O bound, virou a mais lenta quando os dados cabem na memória: tamanhos de pool maiores performaram melhor aqui.
Em resumo: o thread pool ajuda mais quando I/O é o fator limitante, e o valor ideal dos parâmetros muda conforme a relação entre buffer pool e dataset. Não existe um thread_pool_size universal.
O argumento que a métrica de TPS esconde: latência p95
Mesmo nos casos em que o thread pool não ganhou em TPS bruto (dataset totalmente bufferizado), ele se mostrou superior num critério que interessa mais a quem opera o banco em produção: a previsibilidade da latência.
Com 2560 conexões e dataset fully buffered, os 5% de clientes mais lentos (p95) tiveram que esperar mais de 787 ms sem thread pool. Com o pool ativo, essa mesma fatia de clientes ficou numa faixa muito mais estreita, entre 235 e 297 ms. Alguns outliers sem pool chegaram a 2000 ms de latência.
Isso importa porque o throughput agregado não conta a história inteira: se a sua aplicação executa várias transações em sequência para completar uma operação, é a cauda de latência (não a média) que define a experiência do usuário↳UX33 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025UX, IA e Front-End: quando experiência, inteligência e código se encontram para criar o futuro digitalProduto & UX · jul 2025Novidades em UX/UI para 2025: O futuro do design de experiências digitaisProduto & UX · abr 2025Ver tudo em Produto & UX → final.
O que isso muda para quem administra Percona Server
Alguns pontos práticos para quem avalia ligar thread_handling=pool-of-threads em produção:
- Não ligue o thread pool achando que é um botão de "mais performance": em baixa concorrência e com dados totalmente em memória, ele pode não ajudar em TPS.
- Teste
thread_pool_sizeem faixas abaixo do número de núcleos físicos antes de assumir que mais grupos é melhor. No benchmark, o valor ótimo (10) foi um quarto dos 40 núcleos físicos disponíveis. - Trate
thread_pool_oversubscribecomo parâmetro sensível: uma escolha subótima custou 11% de throughput mesmo comthread_pool_sizejá correto. - Se o seu
innodb_buffer_pool_sizecobre uma fração pequena do dataset (workload I/O bound), o thread pool tende a entregar o maior ganho relativo. - Monitore p95 e p99 de latência, não só TPS médio. É aí que o thread pool mostra valor mesmo quando o throughput bruto não melhora.
O próprio post da Percona recomenda a leitura do artigo de Vadim Tkachenko que compara o funcionamento do thread pool a controle de tráfego urbano, uma analogia útil para explicar o conceito a times que não mexem com banco no dia a dia. A Parte 2 desta série, ainda não publicada, promete colocar essa configuração otimizada do Percona Server frente a frente com o thread pool nativo do MySQL Community 26.7.0 / 9.7.2.
Fonte: Percona Database Blog
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Como uma cláusula WHERE seletiva pode travar um cluster Galera inteiro
Um incidente real mostra como o ajuste automático de chunks do pt-online-schema-change, pensado para acelerar migrações, pode sobrecarregar a replicação síncrona do Galera e travar o cluster inteiro.