Cinco palavras do SQL que fazem o PostgreSQL trabalhar mais do que o necessário
Um benchmark publicado no Planet PostgreSQL mede, linha a linha, o custo real de UNION, MATERIALIZED, ORDER BY random(), SELECT * e funções no WHERE sem índice.
A maioria das queries lentas que um DBA encontra no dia a dia não tem nada de sofisticado. Elas fazem trabalho extra que ninguém pediu, porque uma palavra no SQL↳SQL64 conteúdosSQL Server – Como evitar SQL Injection?Data · mai 2019Azure SQL DB Managed InstanceData · abr 2019SQL Server – Como evitar SQL Injection? Pare de utilizar Query Dinâmica como EXEC(@Query)Data · abr 2019Ver tudo em Data → instruiu o PostgreSQL a fazer exatamente isso. É essa a tese de um post publicado em 9 de outubro de 2026 no Planet PostgreSQL, que isolou cinco palavras-chave comuns e mediu cada uma contra a versão sem ela, na mesma tabela.
O ambiente de teste foi deliberadamente modesto: uma tabela u com 2 milhões de linhas (chave bigint, email, status, timestamptz e uma nota md5), rodando em PostgreSQL 18.6 com configuração padrão (work_mem de 4MB, shared_buffers de 128MB, até dois workers paralelos por query), em um MacBook Pro 13 polegadas de 2020 com Intel i5-8257U e 8GB de RAM. Cada tempo é o de execução capturado via EXPLAIN (ANALYZE, TIMING OFF), com cache quente, descartando a primeira execução e usando a mediana das seguintes. Nada de rede: EXPLAIN ANALYZE não envia linhas ao cliente, então toda diferença medida é I/O de páginas e CPU de processamento no servidor.
UNION sem ALL: a diferença de 20 vezes
O caso mais gritante do benchmark. O autor dividiu a tabela em duas metades (id < 1000000 e o restante) e reuniu as duas com UNION ALL e com UNION. Com UNION ALL, o PostgreSQL apenas lê as linhas das duas metades e concatena: 0,68 segundo. Com UNION, ele precisa garantir que nenhum email apareça duplicado entre as duas metades, o que força uma deduplicação de 2 milhões de valores antes de qualquer contagem: 13,6 segundos.
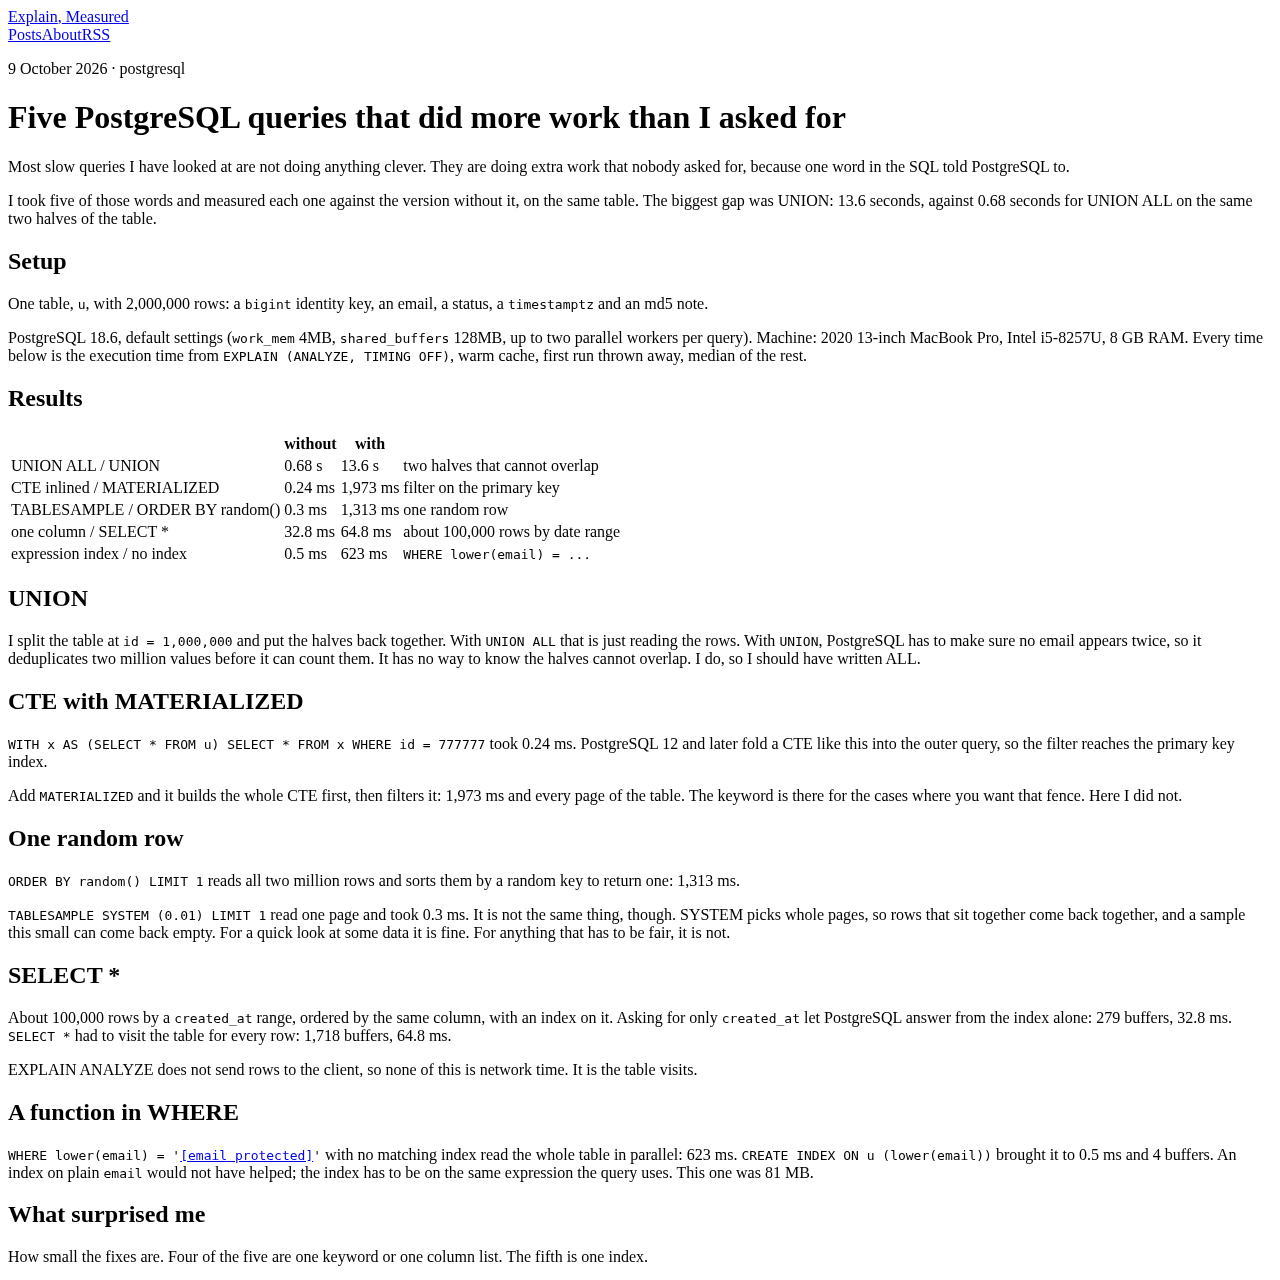
O ponto central é que o otimizador não tem como saber, pelo SQL, que as duas metades são mutuamente exclusivas. Quem sabe disso é quem escreveu a query. Nesse caso, segundo o autor, a escolha correta sempre foi UNION ALL; UNION plano só se justifica quando duplicatas são de fato possíveis e indesejadas no resultado final. Em sistemas que compõem relatórios ou views com múltiplas fontes, essa é provavelmente a correção de performance mais barata que existe: trocar uma palavra sem mexer em índice ou em schema.
CTE com MATERIALIZED: a cerca que ninguém pediu
A partir do PostgreSQL 12, uma CTE simples como a do bloco abaixo é inlined pelo planejador, ou seja, incorporada à query externa como se fosse uma subconsulta comum:
WITH x AS (SELECT * FROM u)
SELECT * FROM x WHERE id = 777777;
Isso permite que o filtro id = 777777 alcance o índice da chave primária, e a execução leva 0,24 milissegundo. Ao acrescentar MATERIALIZED depois do AS, o comportamento muda por completo: o PostgreSQL materializa a CTE inteira antes de aplicar qualquer filtro, varrendo a tabela toda. Resultado: 1.973 milissegundos, mais de oito mil vezes mais lento para o mesmo resultado.
MATERIALIZED existe para os casos em que essa barreira é desejável, como isolar efeitos colaterais de uma função volátil ou evitar que uma CTE custosa seja reavaliada várias vezes dentro da mesma query. O erro, descreve o autor, é usar a palavra por hábito (como se fazia antes da versão 12, quando toda CTE era uma fronteira de otimização por padrão) em situações em que o filtro posterior deveria simplesmente atravessar para o índice.
Uma linha aleatória: ORDER BY random() contra TABLESAMPLE
Pegar uma linha qualquer da tabela é um requisito comum, e ORDER BY random() LIMIT 1 é a forma mais intuitiva de escrever isso. O problema é que o PostgreSQL precisa ler as 2 milhões de linhas, atribuir uma chave aleatória a cada uma e ordenar tudo para descartar quase todo o resultado: 1.313 milissegundos no teste.
TABLESAMPLE SYSTEM (0.01) LIMIT 1 resolve o mesmo problema lendo apenas uma página: 0,3 milissegundo. A ressalva importante, e o autor é explícito sobre isso, é que não são equivalentes. SYSTEM amostra páginas inteiras, então linhas fisicamente próximas tendem a aparecer juntas, e uma amostra tão pequena pode retornar vazia. Para uma espiada rápida nos dados, a diferença não importa. Para qualquer uso que exija aleatoriedade justa, estatisticamente válida, ela importa, e o próprio autor reconhece que não testou TABLESAMPLE BERNOULLI (que amostra linha a linha, lendo toda página mesmo assim) por falta de tempo nesta rodada.
SELECT * contra a lista de colunas
Em uma consulta por faixa de created_at trazendo cerca de 100 mil linhas, com índice sobre essa coluna e ordenação pela mesma coluna, pedir só created_at permitiu que o PostgreSQL respondesse inteiramente a partir do índice: 279 buffers, 32,8 milissegundos. Pedir SELECT * obrigou o planejador a visitar a tabela heap para cada linha retornada: 1.718 buffers, 64,8 milissegundos, o dobro de tempo e mais de seis vezes mais páginas lidas.
A explicação é o conceito de index-only scan: quando todas as colunas pedidas estão presentes no índice, o PostgreSQL dispensa a ida à tabela (desde que o mapa de visibilidade esteja atualizado). SELECT * elimina essa possibilidade por definição, porque sempre exige colunas que não estão no índice. Não é um problema de rede, como o autor faz questão de frisar: é puramente o custo de buscar páginas adicionais em disco ou cache.
Função no WHERE sem índice de expressão
O último caso é o mais familiar para quem já debugou uma query que "deveria ser rápida": WHERE lower(email) = '...' sem índice correspondente obriga uma varredura completa da tabela, ainda que em paralelo: 623 milissegundos. Criar CREATE INDEX ON u (lower(email)) derrubou isso para 0,5 milissegundo, lendo apenas 4 buffers.
O detalhe que o benchmark deixa explícito é que um índice comum sobre email não ajudaria em nada aqui. O índice precisa ser construído sobre a mesma expressão usada na cláusula WHERE, não sobre a coluna crua. O índice de expressão resultante ocupou 81 MB no teste, um lembrete de que esse tipo de otimização tem custo de armazenamento e de manutenção em cada escrita, e deveria ser decidido olhando para o padrão real de consultas da aplicação.
O que o benchmark não cobre
O próprio autor lista as limitações, e elas são relevantes para quem for extrapolar os números:
- Um
work_memmaior reduziria a diferença doUNION, já que a deduplicação ocorreria em memória em vez de gerar spill para disco; - Todo o teste rodou com a tabela em cache do sistema operacional; tabelas maiores que a RAM disponível tendem a acentuar, não reduzir, essas diferenças;
- Os números são de uma única máquina modesta; o que deve se manter em outro hardware é a proporção entre as duas versões de cada query, não os segundos absolutos.
Por que isso importa na rotina
Em resumo: nenhuma das cinco correções exige redesenho de schema ou reescrita de aplicação. Quatro delas são uma palavra ou uma lista de colunas; a quinta é um índice de expressão. O que as torna perigosas é justamente a ausência de sintoma em ambiente de desenvolvimento: numa tabela de alguns milhares de linhas, todas as cinco variantes terminam em poucos milissegundos, e a distância só aparece quando a tabela cresce para a escala de produção.
Para quem constrói e mantém aplicações sobre PostgreSQL, a lição prática é olhar o plano de execução antes de escalar hardware ou adicionar réplica. EXPLAIN (ANALYZE, BUFFERS) numa query que parece simples costuma expor, com uma linha de diferença, se o banco está fazendo exatamente o trabalho pedido ou algo a mais que ninguém pediu. O autor publicou o script de reprodução e os números brutos junto ao post original, e adianta que a mesma ferramenta vai medir os próximos dois posts da série, o que sugere mais casos como esses pela frente.
Fonte 1: Planet PostgreSQL (https://postgr.es/p/9xp)
Five PostgreSQL queries that did more work than I asked for | Explain, Measured
9 October 2026 · postgresql
Five PostgreSQL queries that did more work than I asked for
Most slow queries I have looked at are not doing anything clever. They are doing extra work that nobody asked for, because one word in the SQL told PostgreSQL to.
I took five of those words and measured each one against the version without it, on the same table. The biggest gap was UNION: 13.6 seconds, against 0.68 seconds for UNION ALL on the same two halves of the table.
Setup
One table, u , with 2,000,000 rows: a bigint identity key, an email, a status, a timestamptz and an md5 note.
PostgreSQL 18.6, default settings ( work_mem 4MB, shared_buffers 128MB, up to two parallel workers per query). Machine: 2020 13-inch MacBook Pro, Intel i5-8257U, 8 GB RAM. Every time below is the execution time from EXPLAIN (ANALYZE, TIMING OFF) , warm cache, first run thrown away, median of the rest.
Results
without with
UNION ALL / UNION 0.68 s 13.6 s two halves that cannot overlap
CTE inlined / MATERIALIZED 0.24 ms 1,973 ms filter on the primary key
TABLESAMPLE / ORDER BY random() 0.3 ms 1,313 ms one random row
one column / SELECT * 32.8 ms 64.8 ms about 100,000 rows by date range
expression index / no index 0.5 ms 623 ms WHERE lower(email) = ...
UNION
I split the table at id = 1,000,000 and put the halves back together. With UNION ALL that is just reading the rows. With UNION , PostgreSQL has to make sure no email appears twice, so it deduplicates two million values before it can count them. It has no way to know the halves cannot overlap. I do, so I should have written ALL.
CTE with MATERIALIZED
WITH x AS (SELECT FROM u) SELECT FROM x WHERE id = 777777 took 0.24 ms. PostgreSQL 12 and later fold a CTE like this into the outer query, so the filter reaches the primary key index.
Add MATERIALIZED and it builds the whole CTE first, then filters it: 1,973 ms and every page of the table. The keyword is there for the cases where you want that fence. Here I did not.
One random row
ORDER BY random() LIMIT 1 reads all two million rows and sorts them by a random key to return one: 1,313 ms.
TABLESAMPLE SYSTEM (0.01) LIMIT 1 read one page and took 0.3 ms. It is not the same thing, though. SYSTEM picks whole pages, so rows that sit together come back together, and a sample this small can come back empty. For a quick look at some data it is fine. For anything that has to be fair, it is not.
SELECT *
About 100,000 rows by a created_at range, ordered by the same column, with an index on it. Asking for only created_at let PostgreSQL answer from the index alone: 279 buffers, 32.8 ms. SELECT * had to visit the table for every row: 1,718 buffers, 64.8 ms.
EXPLAIN ANALYZE does not send rows to the client, so none of this is network time. It is the table visits.
A function in WHERE
WHERE lower(email) = ' [email protected] ' with no matching index read the whole table in parallel: 623 ms. CREATE INDEX ON u (lower(email)) brought it to 0.5 ms and 4 buffers. An index on plain email would not have helped; the index has to be on the same expression the query uses. This one was 81 MB.
What surprised me
How small the fixes are. Four of the five are one keyword or one column list. The fifth is one index.
And how forgiving the slow versions look in development. On a table of a few thousand rows every one of these finishes in a few milliseconds, and the difference only appears when the table grows.
What I did not test
Larger work_mem . UNION would have deduplicated in memory with more of it, and the gap would be smaller. Tables bigger than RAM. Everything here was in the OS cache. Fair random sampling. TABLESAMPLE BERNOULLI samples rows rather than pages, which means reading every page; I did not time it. Other hardware. Compare the ratios, not the seconds.
Reproduce it
The script and the raw numbers: run2.py , results2.json . The same script also measures the next two posts in this series.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Como consolidar múltiplos bancos em um único Postgres com replicação lógica
Na segunda parte de sua série sobre replicação lógica, Dimitri Fontaine mostra como unir schemas de aplicações diferentes num warehouse Postgres e ainda republicar as mudanças como stream de CDC.