Cloudflare libera modelos de decisão em open weight para agentes de IA na edge
Os modelos Clef e Clef-Flash, anunciados pela Cloudflare durante sua Birthday Week, trocam a geração de texto por probabilidades tipadas, com pesos abertos e latência pensada para rodar dentro do caminho crítico de agentes de IA.

Durante sua recente Birthday Week, a Cloudflare anunciou o Clef, uma família de modelos open weight desenhados para escolher entre opções predefinidas em vez de gerar texto livre. A empresa liberou versões de 9 bilhões e 27 bilhões de parâmetros, além de uma plataforma para adaptar os modelos a tarefas específicas de decisão, segundo reportagem da InfoQ.
O lançamento mira diretamente quem constrói agentes de IA↳Agentes de IA42 conteúdosOpera passa a integrar ChatGPT, Claude e outros agentes de IADev (Back & Front) · mar 2026Operações mais inteligentes, decisões mais rápidas: o impacto da IA agêntica na rotina de TIAI · abr 2026Adobe aposta em orquestração de agentes de IA: o que muda para devsDev (Back & Front) · abr 2026Ver tudo em AI →: a proposta é separar a etapa de "decidir o que fazer" da etapa de "gerar uma resposta", algo que hoje costuma ser resolvido forçando um LLM generalista a devolver JSON e torcendo para o parser não quebrar.
O que é um modelo de decisão, afinal
O Clef é um modelo multimodal de 27B parâmetros que recebe um estado (texto, JSON, imagem ou vídeo) e um schema de perguntas tipadas, e devolve uma probabilidade para cada opção permitida, para cada pergunta, em um único forward pass. Não há geração de texto livre nem parsing de saída: o agente recebe diretamente números com os quais pode decidir como agir, seja roteando um chamado de suporte, escalando para um humano ou adiando a decisão.
Na prática, isso elimina uma classe inteira de bugs comuns em pipelines de agentes: o LLM que devolve um JSON malformado, o campo que vem como string quando deveria ser enum, o retry silencioso porque o parser falhou. O modelo de decisão troca geração por classificação, e classificação tem saída tipada por definição.
Dois tamanhos, duas latências
Além do Clef de 27B, a Cloudflare lançou o Clef-Flash, uma versão de 9B parâmetros pensada para decisões sensíveis a latência. Os números divulgados pela empresa, em benchmarks próprios, mostram a diferença entre os dois:
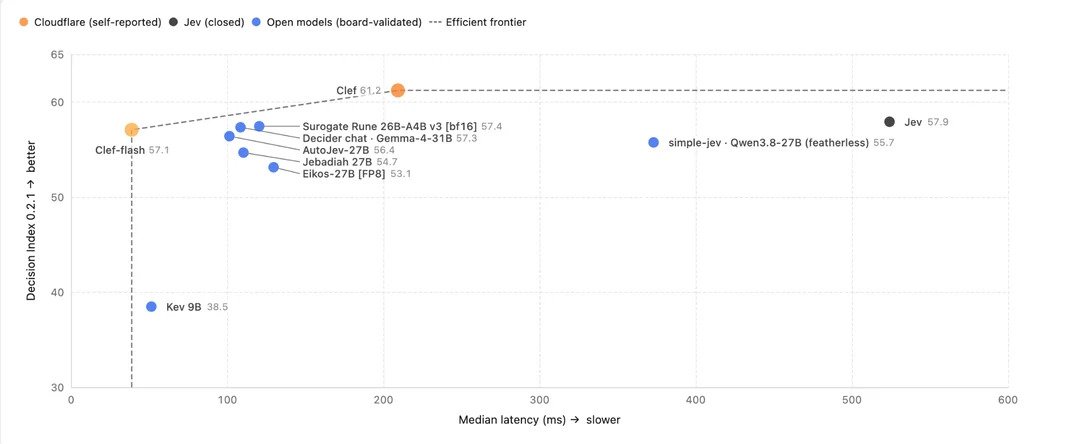
| Modelo | Parâmetros | Latência mediana (Cloudflare) |
|---|---|---|
| Clef | 27B | 209,3 ms |
| Clef-Flash | 9B | 38,8 ms |
A diferença de mais de 5x em latência é o argumento central da Cloudflare para colocar o Clef-Flash no meio de um fluxo de decisão em tempo real, onde cada chamada adicional de rede custa experiência de usuário.
O argumento da borda: decisão perto do usuário, ação com LLM separado
Por estarem hospedados na própria infraestrutura da Cloudflare, os dois modelos rodam nas GPUs que a empresa já distribui pela borda, e é esse ponto que a companhia usa para justificar o desenho de arquitetura que está propondo. Michelle Chen (group product manager), Alex Reneau (principal machine learning engineer) e Kevin Flansburg (senior engineering manager↳Liderança técnica5 conteúdosLiderança técnica: a arte de inspirar desenvolvedores e gerar transformações 🚀Gestão Dev & TI · mai 2024Full Cycle lança pós-graduação que capacita devs para cargos de liderança técnicaDev (Back & Front) · mar 2024De Dev a Tech Leader: caminhos para se tornar um Tech Leader excepcionalGestão Dev & TI · ago 2024Ver tudo em Gestão Dev & TI →), todos da Cloudflare, escrevem:
Como estão hospedados na infraestrutura da Cloudflare, conseguimos aproveitar nossas GPUs na borda, o que resulta em baixa latência de rede e decisões mais rápidas. Isso significa que você pode colocar o Clef no caminho crítico dos agentes para tomar decisões e combinar isso com um dos nossos LLMs no Workers AI para agir.
Because they are hosted on Cloudflare's infrastructure, we're able to take advantage of our GPUs at the edge, leading to low network latency and faster decisions. This means that you could put Clef into the hot path for agents to make decisions and combine that with one of our LLMs on Workers AI to take action.Michelle Chen, Alex Reneau e Kevin Flansburg, Cloudflare
A ideia de arquitetura, portanto, é explícita: o Clef fica no hot path, decidindo rápido, e um LLM generativo entra depois, só quando a ação exige produzir texto (uma resposta ao cliente, um resumo, um e-mail). Para quem hoje usa um único modelo generalista para fazer as duas coisas, isso é uma separação de responsabilidades nova dentro do próprio pipeline do agente, com implicações de custo (um modelo menor rodando a maior parte das vezes) e de confiabilidade (saída tipada em vez de texto a ser interpretado).
Compatibilidade com o Jev System One, da Typesafe AI
A API do Clef é compatível com o Jev System One, modelo de decisão da Typesafe AI que já tinha presença no mercado antes do anúncio da Cloudflare. Chen, Reneau e Flansburg detalham as diferenças técnicas entre os dois:
Primeiro, ele tem um encoder de visão, então consegue processar imagens e classificar conteúdo visual. Isso é diferente do Jev, que hoje só faz classificação de texto. Segundo, nosso modelo tem uma janela de contexto de 64 mil tokens (contra 32 mil do Jev), o que permite ao usuário encaixar mais estado de entrada para o modelo classificar.
First, it has a vision encoder so it's able to take in images and classify visual content. This is different from Jev, which only does text classification today. Secondly, our model has a 64k context window (compared to Jev's 32k), which allows users to squeeze more input state for the model to classify against.Michelle Chen, Alex Reneau e Kevin Flansburg, Cloudflare
A compatibilidade de API é relevante para quem já integrou o Jev: migrar para o Clef, em tese, não exige reescrever a camada de integração, só trocar o endpoint e testar se o schema de perguntas tipadas se comporta igual.
O ceticismo da comunidade sobre benchmarks e "novo paradigma"
O anúncio gerou discussão tanto no Hacker News quanto no Reddit, com parte da comunidade questionando se decision models são de fato uma categoria nova ou um reempacotamento de classificação supervisionada. Jacek Złydach resumiu o ceticismo:
Não é um 'novo paradigma', é uma fruta madura que está largada no chão há anos; a Typesafe foi só a primeira a parar, pegar e vender pra caramba.
It's not a 'new paradigm', it's a low-hanging fruit that's been lying around for years; Typesafe were the first to bother to stop and pick it up, and market the shit out of it.Jacek Złydach, comentário no Hacker News
Os benchmarks divulgados pela Cloudflare também foram questionados. No Hacker News, o usuário SebastianSosa alertou sobre o risco de otimização para a métrica errada:
Benchmarks públicos são fáceis de enganar; se eu fosse a Typesafe, também lançaria um benchmark público para distrair gente competente, fazendo com que ela caia em overfitting no benchmark em vez de construir algo realmente útil.
Public benchmarks are easy to cheat, if I am Typesafe, I would also release a public benchmark to distract otherwise competent people from overfitting to a benchmark instead of making something actually useful.SebastianSosa, comentário no Hacker News
Outro usuário, bugra_sa, propôs um teste mais prático do que olhar só a acurácia divulgada:
Eu me importaria mais se o Clef sabe quando recusar uma decisão do que com o número bruto de acurácia. Testem em casos onde um falso positivo custa muito mais que um falso negativo, e variem os dados o suficiente para ver quando a confiança do modelo desmorona. Se ele continuar confiante mesmo assim, o número do benchmark não significa muita coisa.
I'd care more about whether Clef knows when to punt than its raw accuracy score. Test it on cases where a false positive is much more expensive than a miss, then change the data enough to see when its confidence falls apart. If it stays confident through that, the benchmark number doesn't mean much.bugra_sa, comentário no Reddit
O ponto de bugra_sa é relevante para quem for avaliar o Clef antes de colocar em produção: acurácia agregada em benchmark público diz pouco sobre comportamento em casos de cauda, que são justamente onde um agente de IA autônomo costuma causar o estrago mais caro.
O que ainda falta: fine-tuning self-service e casos de uso reais
A Cloudflare informou que pretende ajustar o Clef para tarefas específicas, como triagem de suporte e classificação de bots, usando dados históricos rotulados da própria empresa para melhorar acurácia e velocidade. Também anunciou um serviço de fine-tuning que permite a clientes adaptar o Clef às suas próprias cargas de trabalho, inicialmente com apoio de engenheiros da Cloudflare; uma plataforma self-service está planejada para uma versão futura, sem data firme anunciada.
Os modelos já estão disponíveis via Workers AI e como pesos para download no Hugging Face, e a Cloudflare convida desenvolvedores a experimentar e dar feedback. Para quem avalia adoção agora, isso significa que o caminho de produção (fine-tuning assistido por humanos) ainda não tem paridade com o caminho self-service que a empresa promete entregar depois, o que pesa em qualquer decisão de arquitetura que dependa de customização própria do modelo.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Mistral Large 4 chega em prévia com 1 trilhão de parâmetros e foco em segurança e código
A Mistral abriu nesta semana o acesso via API ao Large 4, um modelo de pesos abertos de 1 trilhão de parâmetros treinado em datacenters europeus, com benchmarks fortes em código e cibersegurança.