Mistral Large 4 chega em preview com arquitetura MoE de 1 trilhão de parâmetros e pesos abertos previstos para outubro

- Leitura
- 6 min
- Tabelas
- 1
- Fontes
- 1
O ML4, apelidado de Le Chonk, é um modelo de mistura de especialistas com 1 trilhão de parâmetros totais e 49 bilhões ativos por token. A API de preview já está no ar; os pesos abertos saem até o fim de outubro de 2026.
A Mistral anunciou nesta terça-feira, 6 de outubro de 2026, a disponibilidade em preview público do Mistral Large 4, batizado internamente de "Le Chonk". O modelo já pode ser testado via API no Mistral Studio, mas os pesos completos só serão liberados até o fim deste mês, quando o modelo passa a ser, de fato, open-weight para quem quer rodar em infraestrutura própria.
O que o ML4 realmente é
Segundo o anúncio da Mistral, o ML4 é um modelo nativamente multimodal construído em arquitetura de mistura de especialistas (MoE): tem 1 trilhão de parâmetros no total, mas ativa apenas 49 bilhões por token processado. É uma diferença técnica importante para quem avalia custo de inferência: o modelo não processa o trilhão inteiro a cada chamada, então a latência e o custo computacional por token tendem a se aproximar de um modelo denso bem menor, mesmo guardando um volume de conhecimento muito maior.
O treinamento rodou do zero em 3.800 GPUs NVIDIA Grace Blackwell, nos próprios datacenters da Mistral na Europa, e é essa mesma infraestrutura que serve o preview público hoje. A empresa descreve o lançamento como o primeiro marco do roadmap financiado pela rodada Series D de 3 bilhões de euros, apresentada como a maior captação de capital já feita por uma empresa de tecnologia europeia.
Para quem avalia preço de API agora: a Mistral cobra 1,36 dólar por milhão de tokens de entrada e 4,18 dólares por milhão de tokens de saída no preview.
Aberto, mas ainda não hoje
Vale separar duas coisas que o anúncio mistura: a API de preview está no ar agora, mas os pesos (o que de fato permite self-hosting, fine-tuning local e deploy on-premise) só chegam ao fim de outubro. Até lá, segundo a Mistral, o modelo está sendo red-teamado em ambientes reais com parceiros de cibersegurança↳Segurança171 conteúdosCibersegurança no Brasil: 6 passos para sair da estagnaçãoDevSecOps · jul 2025O papel do CISO para transformar a cibersegurança em uma alavanca de reputação para as empresasDevSecOps · mar 2024Itaipu Parquetec e Exército Brasileiro realizam exercício de cibersegurança em BrasíliaDev (Back & Front) · set 2025Ver tudo em DevSecOps → e autoridades estatais, que recebem uma versão com moderação reduzida e capacidades cibernéticas ampliadas.
Isso importa para quem planeja adoção: se a promessa de rodar fora da nuvem de terceiros é o motivo de interesse, o cronograma real é "pesos em semanas", não "hoje". A empresa ainda não detalhou arquitetura completa, benchmarks adicionais nem a metodologia de pós-treinamento, prometendo publicar tudo isso junto com os pesos.
Os números que importam para quem escreve código
Nos testes divulgados pela própria Mistral, o ML4 aparece em posições competitivas contra o conjunto atual de modelos abertos e fechados do mercado em 2026, incluindo GPT-6 Astra, Claude Opus 5.5, GLM-5.3, DeepSeek V4 Pro e Kimi K3.
| Benchmark | Resultado do ML4 | Comparação |
|---|---|---|
| DeepSWE v1.1 | 61,7% | referência de coding agent |
| SWE-Atlas-QnA | 59,4% | compreensão de repositório |
| Terminal-Bench 4.0 | 28,3% | workflows de terminal |
| Coding Agent Index (combinado) | 49,8% | à frente do DeepSeek V4 Pro 0813 e do Qwen3.8 Max |
| AutomationBench | 59,9% | à frente de Kimi K3, MiMo-V2.6-Pro e DeepSeek V4 Pro |
| AA-Briefcase (Elo) | 1.393 | à frente do DeepSeek V4 Pro |
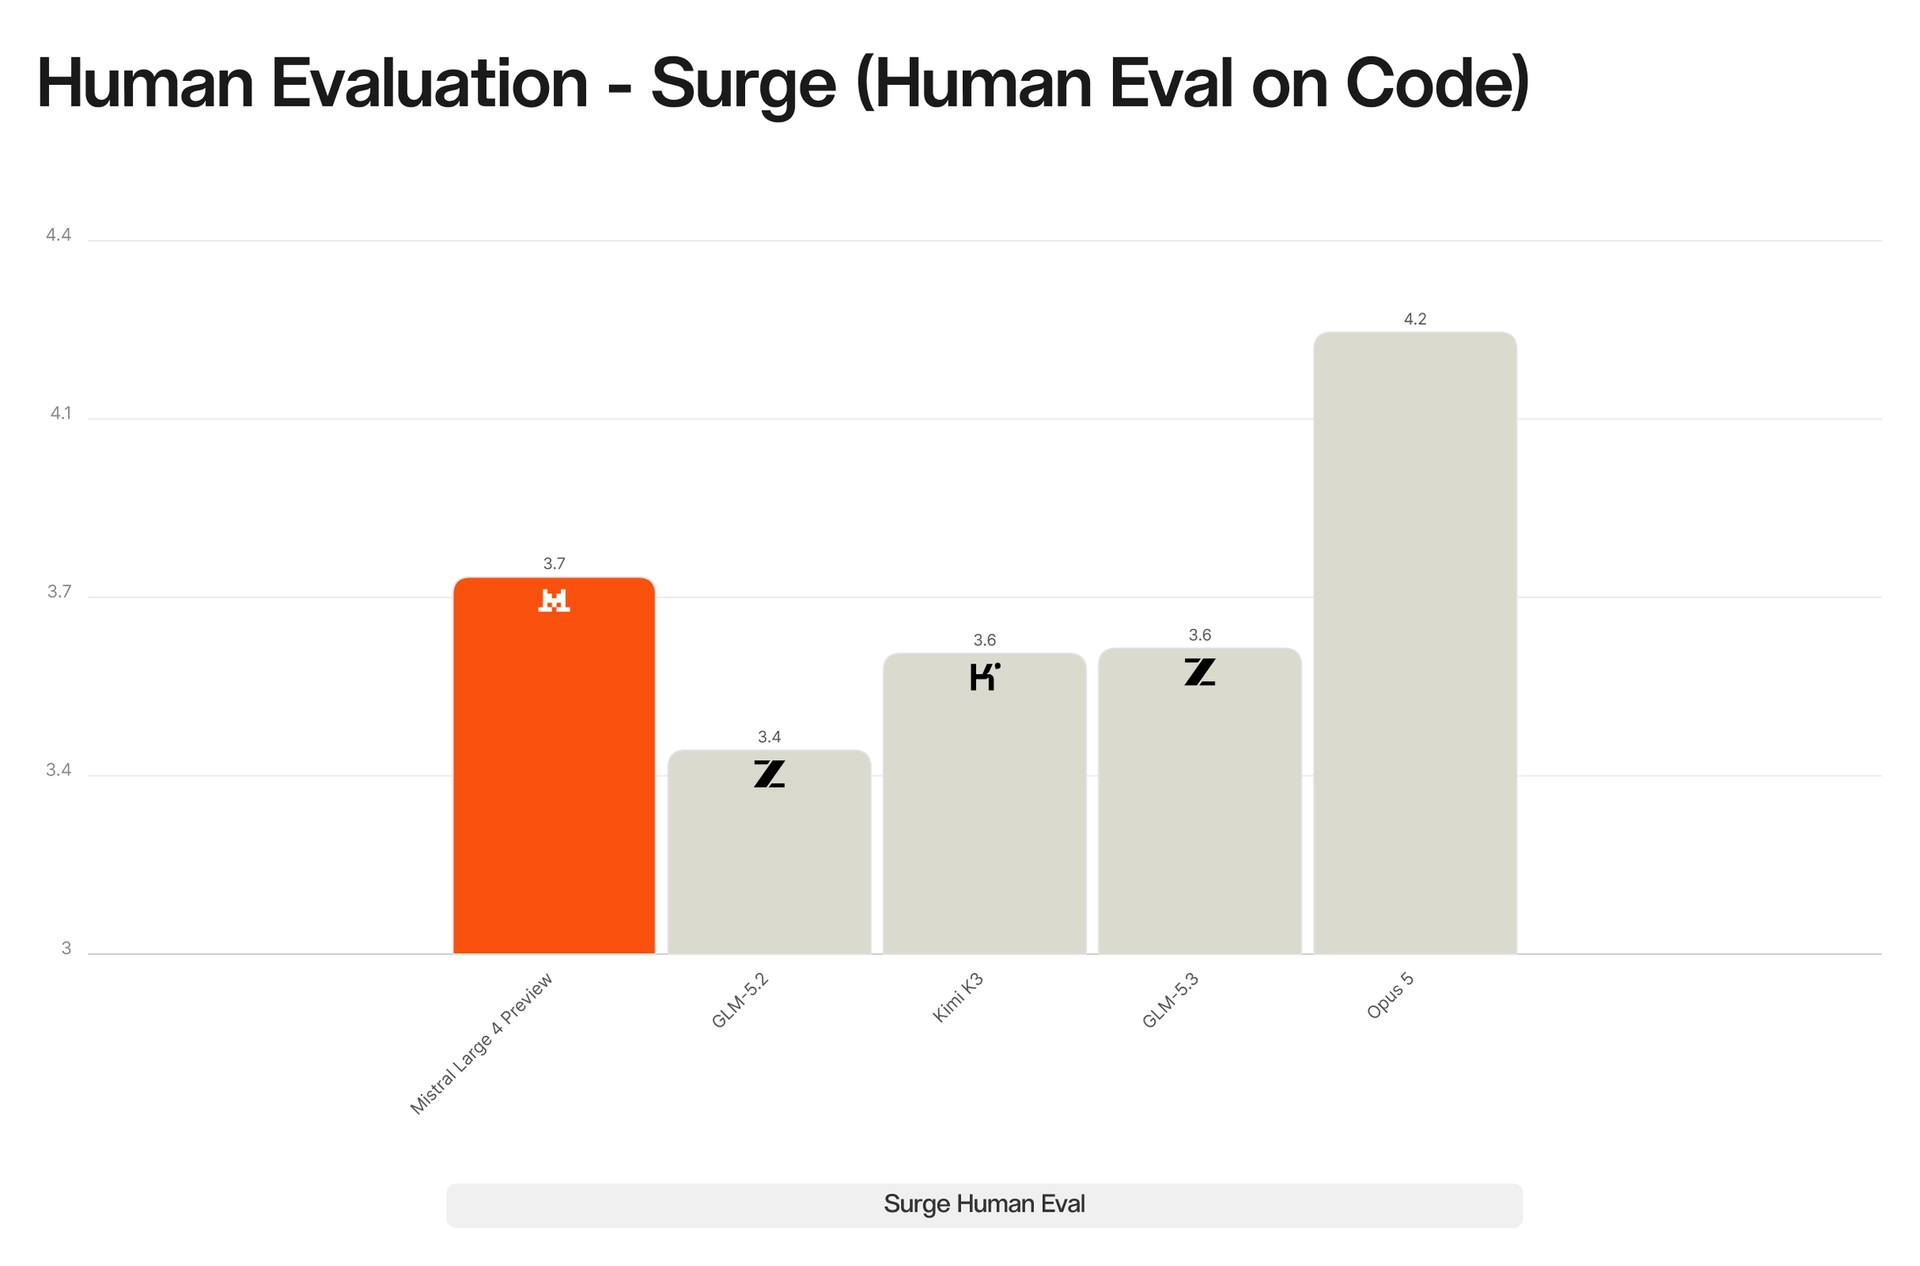
A Mistral também encomendou uma avaliação cega com anotadores humanos profissionais via Surge AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →, só para qualidade de código. Nessa avaliação, numa escala de 1 a 5, o ML4 Preview tirou 3,74, ficando em segundo lugar entre cinco modelos testados: atrás apenas do Claude Opus 5 (4,22) e à frente de GLM-5.3 (3,60), Kimi K3 (3,59) e GLM-5.2 (3,40).
A aposta em cibersegurança que muda o uso prático
O ângulo mais específico do anúncio é cibersegurança, e aqui o material traz um dado concreto: no Artificial Analysis Cyber Index, descrito pela própria Mistral como uma avaliação independente, o ML4 fica entre os cinco melhores modelos do mundo, e num teste do índice que pede para reproduzir uma vulnerabilidade real de software aberto e depois corrigi-la, ele marcou 82%, a maior pontuação registrada no teste até agora. No Cybench, conjunto de 40 exercícios de competições de segurança, o modelo resolveu 93% dos desafios.
O contraponto citado pela própria Mistral é revelador: modelos fechados como Claude Opus 5.5 e GPT-6 Astra tiram pontuação próxima de zero no mesmo teste porque se recusam a executar a tarefa, mesmo sendo pesquisa legítima de vulnerabilidade. É esse gargalo de recusa em modelos fechados que a Mistral usa para justificar a venda do ML4 para equipes de segurança que precisam de um modelo auditável e autodeployável, rodando em nuvem privada ou on-premise.
Ao mesmo tempo, a empresa reporta que o ML4 tem a maior taxa de recusa entre modelos abertos quando o pedido é efetivamente malicioso, medida nos benchmarks JailbreakBench, StrongREJECT e AgentHarm. No B3 AI Security Benchmark, benchmark público da Lakera (terceiro), o modelo resiste a 93,3% das tentativas de prompt injection indireto, a maior pontuação reportada entre concorrentes como GLM-5.2, GLM-5.3, Kimi-K2.6, Kimi-K3 e DeepSeek V4 Pro 0813.
Legal, finanças e multimodalidade
Fora do eixo técnico puro, a Mistral reporta avaliações de terceiros via vals.ai em que o ML4 supera o GPT-6-Astra tanto em tarefas jurídicas quanto financeiras, e no benchmark de agente jurídico da Harvey AI o modelo fica à frente de todos os modelos open-source testados. Em visão computacional, a Mistral destaca que o ML4 supera o GPT-6-Astra no Dense 200, teste de visual grounding (42% contra 41%), e descreve casos de uso que vão de inspeção de imagens de satélite em gigapixels até verificação de peças em desenhos técnicos de engenharia.
O que ainda fica em aberto
A maior parte dos números acima vem de benchmarks internos da própria Mistral. Há, porém, avaliações conduzidas ou documentadas por terceiros: as análises jurídicas e financeiras via vals.ai, a avaliação cega de código via Surge AI, o Artificial Analysis Cyber Index (que a própria Mistral descreve como avaliação independente) e o B3 AI Security Benchmark, que é um benchmark público da Lakera.
Fora esses casos, não há, até a publicação deste preview, benchmark independente adicional rodado por terceiros sobre o ML4. A licença exata sob a qual os pesos serão publicados também não foi detalhada na fonte, nem requisitos de hardware para rodar o modelo completo localmente, algo que só deve ficar claro quando a Mistral publicar a documentação de arquitetura prometida para o fim do mês.
Para quem decide stack de IA para produção no Brasil, o ML4 ainda é, por enquanto, uma API de preview hospedada na Europa, útil para testar qualidade de código e agentes antes que os pesos existam para avaliação de custo real de self-hosting. A promessa de rodar on-premise é concreta no discurso da empresa, mas só vira operação possível quando o arquivo de pesos sair do forno.
Fonte: Hacker News
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Outlook.com rejeita e-mails sem DMARC desde 5 de novembro e não avisou ninguém
Desde 5 de novembro de 2026, o Outlook.com recusa parte dos e-mails vindos de domínios sem registro DMARC, sem aviso público da Microsoft. O conserto é um registro DNS que leva minutos para publicar.