OpenAI separa GPTBot, OAI-SearchBot e ChatGPT-User: como configurar o robots.txt sem perder citação no ChatGPT Search

- Leitura
- 5 min
- Tabelas
- 1
- Código
- 2
- Fontes
- 1
A documentação da OpenAI mostra que permitir a citação no ChatGPT Search e permitir o treinamento do modelo são duas decisões separadas no robots.txt. Veja a regra antes e depois, e onde times de SEO costumam errar.
A documentação de rastreadores da OpenAI, disponível em platform.openai.com/docs/bots, deixa um ponto que ainda confunde muita gente que cuida de SEO↳SEO4 conteúdosPor que a transição do SEO clássico para a Otimização de Motores Generativos (GEO) exige que se repense a modelagem semânticaMarketing Tech · mai 2026O impacto da pesquisa e do SEO no comércio eletrônico: insights da State of Search Brasil 5Marketing Tech · fev 2025SEO por Elas 2025: Impulsionando e promovendo mulheres no Marketing DigitalMarketing Tech · fev 2025Ver tudo em Marketing Tech → técnico: existe mais de um robô, e cada um faz uma coisa diferente com o conteúdo do site. Bloquear um não bloqueia o outro, e é exatamente essa independência que times de growth costumam ignorar quando escrevem um robots.txt genérico para "a IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → da OpenAI".
O erro mais comum é tratar OpenAI como um bloco único: ou libera tudo, ou bloqueia tudo. Na prática, a OpenAI documenta quatro user-agents com funções distintas, e pelo menos três delas interessam direto a quem pensa em GEO (otimização para buscadores generativos) no Brasil.
Quatro robôs, quatro funções
A tabela abaixo resume o que cada rastreador faz, segundo a própria documentação da OpenAI:
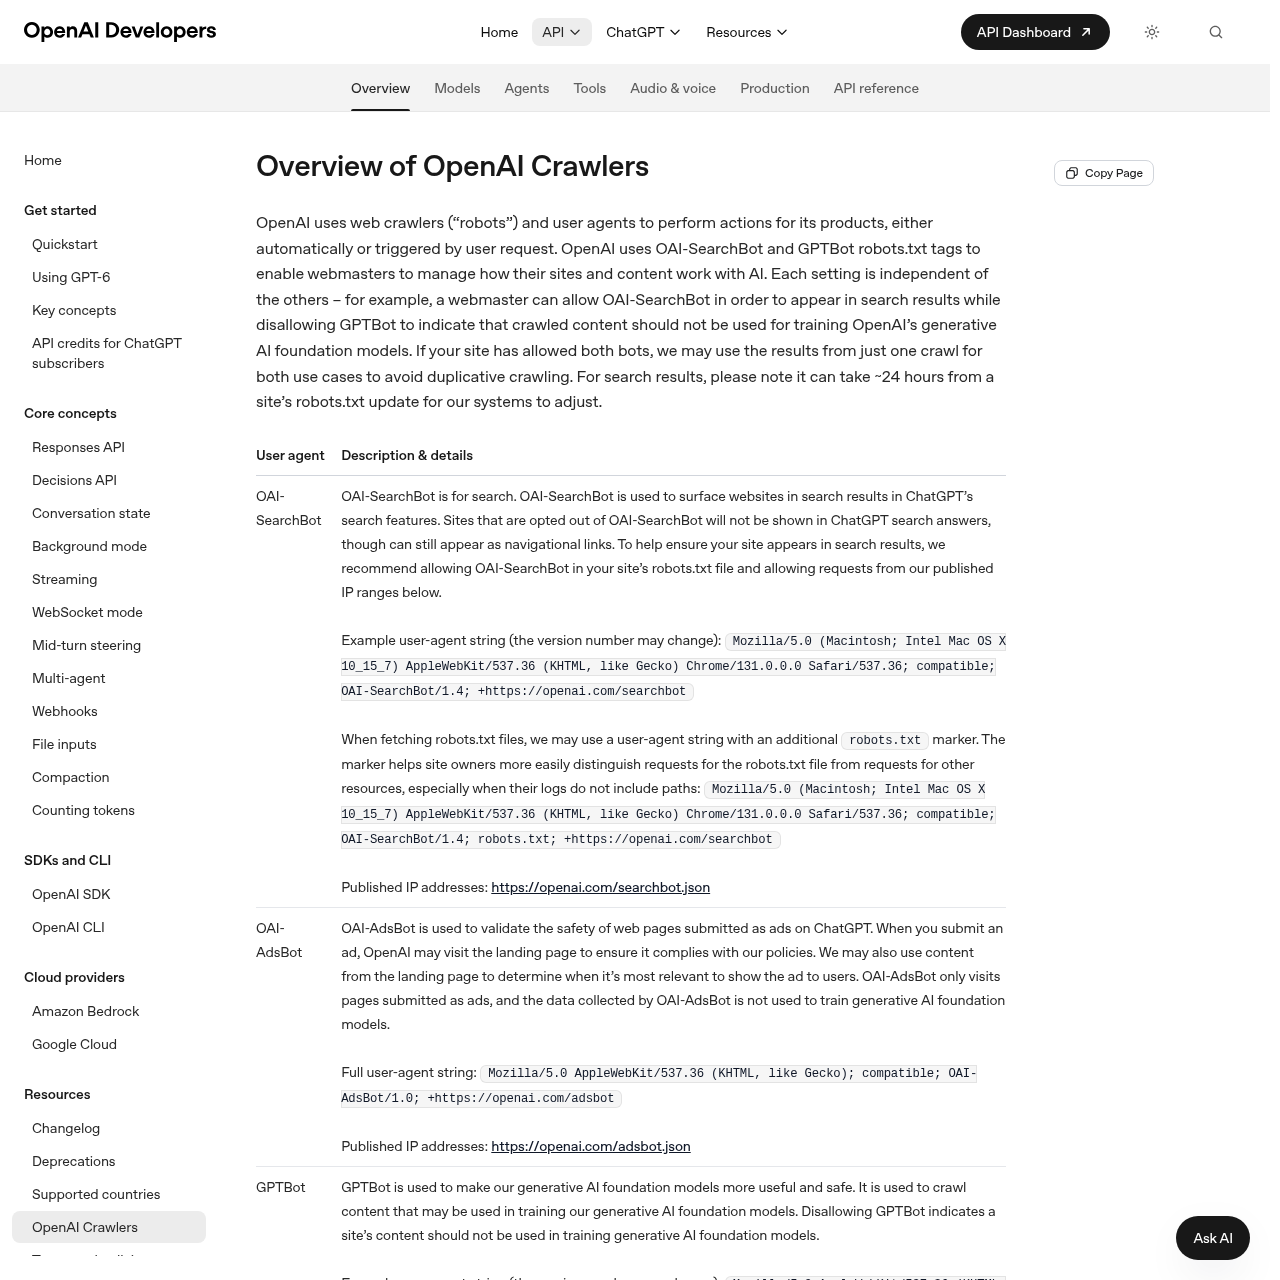
| Rastreador | Para que serve | Usa o conteúdo para treinar modelo? | Efeito de bloquear |
|---|---|---|---|
GPTBot | Coleta conteúdo para treinar os modelos de fundação da OpenAI | Sim | Site não entra no treinamento futuro |
OAI-SearchBot | Indexa páginas para aparecerem como resposta no ChatGPT Search | Não | Site não aparece em respostas de busca (mas pode aparecer como link de navegação) |
ChatGPT-User | Visita uma página quando um usuário pede isso numa conversa ou GPT Action | Não | Regra de robots.txt pode nem se aplicar, porque a ação é disparada pelo usuário, não automática |
OAI-AdsBot | Valida a segurança de páginas enviadas como anúncio no ChatGPT | Não | Afeta só a avaliação de anúncios, não a busca nem o treinamento |
A própria OpenAI escreve isso de forma explícita: "Each setting is independent of the others" (cada configuração é independente das outras). Ou seja, dá para permitir OAI-SearchBot e, ao mesmo tempo, negar GPTBot ─ e é exatamente essa combinação que faz sentido para a maioria dos sites que querem aparecer em respostas do ChatGPT sem autorizar que o texto vire dado de treinamento.
O robots.txt que times de SEO ainda escrevem errado (antes)
Um padrão comum, copiado de templates genéricos de "bloqueio de IA", trata todos os agentes da OpenAI como um bloco só:
User-agent: GPTBot
Disallow: /

User-agent: ChatGPT-User
Disallow: /

User-agent: OAI-SearchBot
Disallow: /
Esse bloco bloqueia tudo de uma vez. O efeito colateral é que o site deixa de aparecer como fonte citada nas respostas do ChatGPT Search, porque OAI-SearchBot nem chega a indexar o conteúdo. Para um site que vive de tráfego de descoberta, isso é abrir mão de uma superfície de distribuição sem necessidade, já que treinamento e indexação de busca não precisavam estar amarrados.
A configuração que separa as duas coisas (depois)
O ajuste que resolve o problema é simples de escrever, mas exige entender o papel de cada bot antes de aplicar:
# Bloqueia uso do conteúdo para treinar modelos de fundação
User-agent: GPTBot
Disallow: /

# Permite aparecer em respostas do ChatGPT Search
User-agent: OAI-SearchBot
Allow: /

# Permite que ações do usuário (ex.: GPT Actions) acessem a página
User-agent: ChatGPT-User
Allow: /
Com essa regra, o site continua fora do pipeline de treinamento de modelos da OpenAI, mas segue elegível para ser citado quando alguém faz uma busca no ChatGPT. A própria documentação confirma que, se os dois bots forem permitidos, a OpenAI pode reaproveitar o resultado de um único rastreamento para as duas finalidades, para evitar crawl duplicado — o que não muda a lógica de que cada Disallow age de forma isolada.
A pegadinha do ChatGPT-User
O ponto que mais pega gestor de SEO desatento é o ChatGPT-User. Ele não é um crawler automático: é acionado quando um usuário, dentro de uma conversa no ChatGPT ou usando uma Custom GPT, pede para a ferramenta visitar uma página específica ou executar uma GPT Action. A documentação é direta ao afirmar que, por ser uma ação disparada pelo usuário, as regras de robots.txt podem simplesmente não se aplicar.
Isso tem duas consequências práticas. Primeiro, bloquear ChatGPT-User não impede necessariamente o acesso pontual que um usuário pede durante uma conversa; é um controle de etiqueta, não uma garantia técnica de bloqueio. Segundo, e mais importante para GEO: ChatGPT-User não é usado para decidir se o conteúdo aparece no ChatGPT Search. Quem quer controlar presença em busca precisa mexer em OAI-SearchBot, não em ChatGPT-User — confundir os dois é desperdiçar esforço de configuração sem efeito no objetivo real.
Verificação por IP: evitar bot falso
A OpenAI publica as faixas de IP de cada rastreador em arquivos JSON próprios: openai.com/searchbot.json para OAI-SearchBot, openai.com/gptbot.json para GPTBot, openai.com/chatgpt-user.json para ChatGPT-User e openai.com/adsbot.json para OAI-AdsBot. Isso importa porque qualquer bot pode forjar o cabeçalho User-Agent na requisição. Validar o IP de origem contra essas listas, antes de aplicar regras de cache ou de servir conteúdo diferenciado, é o jeito de confirmar que a visita é mesmo da OpenAI e não de um scraper se passando por ela.
O que medir depois do ajuste
Quem aplica essa separação tem como validar o efeito de duas formas concretas: monitorando no log do servidor as requisições de OAI-SearchBot (confirmando que elas passaram a ocorrer, ou continuaram, depois do Allow) e observando, via busca manual no ChatGPT, se o domínio passa a aparecer como fonte citada em perguntas relacionadas ao conteúdo do site. A própria documentação avisa que mudanças no robots.txt levam cerca de 24 horas para refletir nos resultados de busca do ChatGPT, então o teste de antes e depois só faz sentido com essa janela de espera — comparar o log no dia seguinte à mudança tende a mostrar número de crawl ainda defasado.
Quando não vale a pena mexer
Para sites que não têm interesse nenhum em aparecer como fonte em respostas de IA generativa (conteúdo estritamente interno, páginas atrás de login, ou editoriais que já bloqueiam toda indexação por política própria), a distinção entre GPTBot, OAI-SearchBot e ChatGPT-User é irrelevante: o bloqueio total continua sendo a escolha coerente. A granularidade só compensa para quem depende de descoberta e tráfego de referência, o cenário típico de portais de notícia, documentação técnica e blogs de produto que competem por citação dentro do ChatGPT Search.
Fonte: OpenAI Platform – Documentação de rastreadores (GPTBot, ChatGPT-User, OAI-SearchBot)
Highlights
- OpenAI documenta quatro user-agents distintos; bloqueio de um não bloqueia os outros automaticamente
- Erro comum: tratar OpenAI como bloco único, perdendo oportunidade de aparecer no ChatGPT Search
- Configuração correta permite OAI-SearchBot e nega GPTBot: citação sem autorizar treinamento
- Mudanças no robots.txt levam cerca de 24 horas para refletir nos resultados do ChatGPT Search
- OpenAI publica faixas de IP de cada rastreador em JSON para validar origem e evitar bots falsos
Este artigo foi escrito por Sabrina Santos, colunista de SEO. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Search Console mistura cliques do AI Overviews com os da busca tradicional, dificultando medir o impacto da GEO
Guia do Google Search Central, atualizado em 10 de dezembro de 2025, explica como cliques e impressões do AI Overviews entram misturados no relatório de Performance, dentro do tipo de busca Web, sem filtro de segmentação próprio.