Llms.txt v2 na prática: como gerar, validar e monitorar o arquivo para IA generativa

- Leitura
- 6 min
- Tabelas
- 1
- Código
- 5
- Fontes
- 1
A especificação llms.txt ganhou uma versão 2, com páginas markdown companheiras e cabeçalhos HTTP padronizados. Veja o roteiro para migrar um site brasileiro e o que, honestamente, ainda não dá para comprovar que os bots de IA realmente leem.
Da v1 para a v2: o que muda de verdade
A proposta llms.txt nasceu em 2024 para resolver um problema concreto: páginas HTML↳HTML45 conteúdosA importância do HTML e CSS para quem trabalha com UI Design e Design SystemProduto & UX · dez 2024Como hostear seu site HTML gratuitamente com GitHub PagesDev (Back & Front) · jun 2025SQL Server – Como criar um versionamento de código das suas Stored Procedures em HTML e com comentários da alteraçãoData · nov 2020Ver tudo em Dev (Back & Front) → carregam navegação, anúncios e JavaScript que atrapalham um modelo de linguagem↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI → a extrair a informação útil. A ideia original era simples, um arquivo markdown em /llms.txt com links para a documentação relevante. Depois de dois anos de adoção, segundo a própria especificação em llmstxt.org, o autor revisou o formato e publicou a v2 incorporando o que funcionou e o que faltava.
A diferença central não está na estrutura do arquivo em si, que continua sendo um H1 obrigatório, uma citação de resumo e seções H2 com listas de links. A novidade da v2 é como o conteúdo por trás desses links deve ser servido.
| Aspecto | v1 | v2 |
|---|---|---|
Arquivo /llms.txt | H1, resumo, listas de links | Mesma estrutura, mantida |
| Páginas linkadas | Qualquer formato | Versão markdown na mesma URL (.html.md ou .md) |
| Descoberta pelo agente | Só via o próprio llms.txt | Também via <link rel="alternate"> e <link rel="describedby"> |
| Implementação em CDN | Não prevista | Cabeçalho HTTP Link: configurável sem tocar nas páginas |
Essa última linha é a que importa para quem já administra um site grande: o cabeçalho HTTP permite declarar a relação com o llms.txt direto na configuração do servidor ou da CDN, sem editar cada página.
Passo 1: mapear o que vale a pena expor
Antes de escrever uma linha de markdown, eu listaria apenas o conteúdo que um agente realmente precisaria para responder perguntas sobre o produto: documentação de API, guias de início rápido, políticas relevantes. A especificação é explícita sobre isso: o arquivo precisa caber no contexto do modelo, então detalhe fica nos links, não no llms.txt em si.
Para um site de documentação técnica brasileiro, por exemplo, isso significa escolher a pasta /docs/ como escopo e deixar de fora páginas institucionais ou de marketing que não ajudam um agente de código a resolver uma chamada de API.
Passo 2: gerar as versões markdown das páginas
A v2 pede que cada página relevante tenha uma versão .md na mesma URL, seja acrescentando a extensão (pagina.html.md) ou substituindo-a (pagina.md). Em um site estático gerado por Next.js ou Docusaurus, isso costuma significar um passo extra de build que roda em paralelo à geração do HTML.
Um exemplo de script simples para gerar o companion markdown a partir do conteúdo-fonte, supondo que a documentação já exista em arquivos .mdx:
for f in docs/**/*.mdx; do
  out="public/${f%.mdx}.md"
  mkdir -p "$(dirname "$out")"
  npx remark "$f" --no-stringify-positions -o "$out"
done
Projetos que já usam VitePress ou Docusaurus não precisam escrever isso na mão: os plugins vitepress-plugin-llms e docusaurus-plugin-llms, listados na própria especificação, automatizam a geração dos arquivos .md e do llms.txt durante o build.
Passo 3: escrever o llms.txt
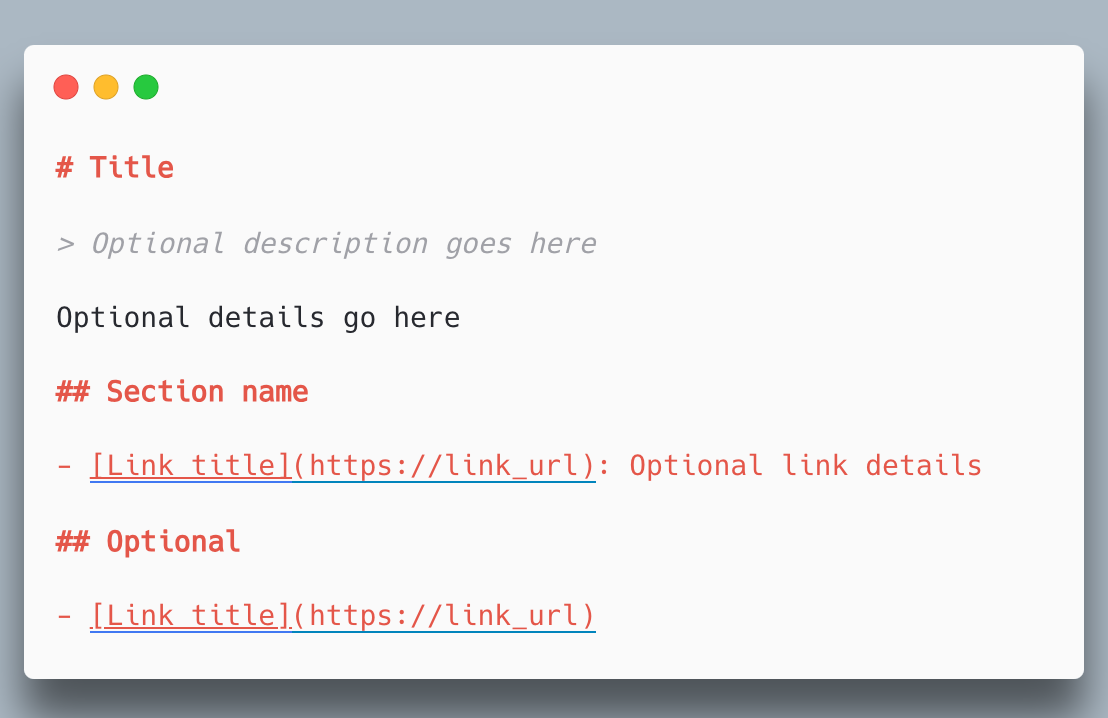
Com os arquivos markdown publicados, o llms.txt vira um índice curado. Um exemplo adaptado para um site fictício de uma API brasileira:
# API Minha Empresa

> API REST para gestão de pedidos e pagamentos, usada por integradores de e-commerce no Brasil.

Notas importantes:

- A API usa autenticação OAuth2, não chaves de API simples.
- Endpoints de sandbox ficam sob /v1/sandbox/, não confundir com produção.

## Docs

- [Guia de início rápido](https://api.minhaempresa.com.br/docs/quickstart.html.md): autenticação e primeira chamada
- [Referência de endpoints](https://api.minhaempresa.com.br/docs/reference.html.md): todos os recursos e parâmetros

## Optional

- [Changelog completo](https://api.minhaempresa.com.br/docs/changelog.html.md)
Repare que a seção Optional segue a convenção da própria especificação: é onde fica o que um agente pode ignorar quando precisa de um contexto mais enxuto.
Passo 4: expor os link relations
O ganho real da v2 está em declarar a relação entre a página HTML, sua versão markdown e o llms.txt que a cobre. Isso pode ir dentro do <head> de cada página:
<link rel="alternate" type="text/markdown" href="/docs/quickstart.html.md">
<link rel="describedby" href="/docs/llms.txt">
Ou, de forma mais escalável, como cabeçalho HTTP configurado direto no servidor web, sem mexer em cada template. Em Nginx, por exemplo:
location /docs/ {
    add_header Link '</docs/llms.txt>; rel="describedby"' always;
}
O cabeçalho Link: tem uma vantagem que o <link> em HTML não tem: funciona também para recursos que não são páginas HTML, como os próprios arquivos .md, e pode ser adicionado em configuração de CDN sem alterar nenhuma página.
Passo 5: validar antes de publicar
O jeito mais direto de checar se a implementação está correta é inspecionar os cabeçalhos de resposta:
curl -I https://api.minhaempresa.com.br/docs/quickstart.htmlSe o Link: header aparecer com rel="alternate" e rel="describedby" apontando para os lugares certos, a parte de descoberta está funcionando. O próprio Lighthouse do Chrome já inclui, segundo a especificação, uma verificação de presença de llms.txt como parte de suas checagens de navegação agêntica, o que dá um ponto de validação automatizado e reproduzível.
Diretórios comunitários como llmstxt.site, directory.llmstxt.cloud e llmstxthub.com também listam arquivos publicados, mas servem mais como vitrine de adoção do que como prova de que algum agente efetivamente consumiu o conteúdo.
O que é promessa e o que é mensurável hoje
Aqui entra a parte que, como profissional de GEO, eu trato com mais cautela. A especificação cita que OpenAI, Anthropic e Gemini publicam llms.txt para suas próprias documentações de desenvolvedor. Isso comprova que os laboratórios usam o formato para expor conteúdo próprio, não que seus rastreadores de produção consultem o llms.txt de terceiros antes de responder a um usuário.
Em resumo: existem hoje três camadas de evidência bem diferentes, e misturá-las é o erro mais comum que vejo em quem corre para publicar o arquivo.
- Mensurável e verificável por você: presença e formato corretos do
llms.txt, cabeçalhosLink:configurados, checagem do Lighthouse, páginas.mdacessíveis. - Adoção documentada pela fonte, mas sem garantia de uso em produção: milhares de sites publicam o arquivo, plataformas de documentação o geram automaticamente, laboratórios de IA o usam para a própria documentação.
- Ainda não comprovável publicamente: se um assistente de IA em produção, ao responder um usuário sobre o seu produto, realmente buscou e usou o seu
llms.txtantes de gerar a resposta.
Essa terceira camada é a que mais importa para quem mede impacto de GEO, e é justamente a que nenhuma fonte pública documenta de forma auditável até agora.
Como eu acompanharia o impacto
Na ausência de uma ferramenta de analytics dedicada a isso, o caminho que eu seguiria num projeto real é olhar os logs do servidor atrás de requisições para /llms.txt e para os arquivos .md, filtrando por user agents conhecidos de rastreadores de IA, como GPTBot, ClaudeBot, Google-Extended e PerplexityBot. Isso não prova que o conteúdo foi usado numa resposta final, mas mostra se o arquivo está sendo buscado.
Vale cruzar essa coleta com o volume de tráfego referenciado por ferramentas de busca conversacional ao longo de algumas semanas, sempre registrando a data de publicação do arquivo como marco antes/depois. Sem essa linha de base, qualquer variação de tráfego vira suposição, não medição.
O que fica em aberto é se a comunidade vai conseguir, com o tempo, algum tipo de confirmação oficial dos laboratórios sobre o uso efetivo do llms.txt em produção, algo que hoje nenhuma das fontes consultadas garante por escrito.
Highlights
- llms.txt v2 pede páginas markdown companheiras (.html.md) linkadas pelo arquivo índice
- Cabeçalho HTTP Link: configurável na CDN sem alterar templates HTML
- Validação via curl e Lighthouse já checa presença e formato do llms.txt
- OpenAI, Anthropic e Gemini usam llms.txt para documentação própria, mas uso em produção não é auditável
- Falta comprovação pública de que assistentes realmente consultam llms.txt antes de responder usuários
Este artigo foi escrito por Sabrina Santos, colunista de SEO. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Google detalha como AI Overviews e AI Mode escolhem e citam páginas
Guia atualizado em dezembro de 2025 explica como AI Overviews e AI Mode selecionam páginas de apoio, mas deixa claro: aparecer na resposta de IA nem sempre gera um clique contabilizável.