Robots.txt para a era da IA: como configurar Google-Extended e Googlebot corretamente

- Leitura
- 7 min
- Tabelas
- 1
- Código
- 3
- Fontes
- 1
Um guia prático para auditar o robots.txt de um site brasileiro, separar o que cada rastreador do Google faz e entender por que bloquear o treino de IA não deve, em tese, tirar sua página das AI Overviews.
O robots.txt virou painel de controle de IA, não só de indexação
Nota da redação: este artigo cita a data de atualização da documentação de crawlers do Google Search Central como 2 de novembro de 2026; a página-fonte indica, na verdade, 3 de novembro de 2026 ('Ostatnia aktualizacja: 2026-11-03 UTC'). O conteúdo técnico sobre user-agents e suas funções foi checado e confere integralmente com a fonte; apenas essa data específica está incorreta.
Durante muito tempo, o robots.txt resolvia uma pergunta só: este rastreador pode ler esta URL ou não? Com a chegada dos modelos generativos do Google, o arquivo passou a responder outra pergunta, separada da primeira: este conteúdo pode treinar um modelo de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →? São decisões independentes, e a documentação de crawlers do Google Search Central (atualizada em 2 de novembro de 2026) deixa isso explícito ao listar cada user-agent e o produto que ele afeta.
O problema é que a maioria dos arquivos robots.txt por aí foi escrita antes dessa distinção existir. Eles bloqueiam ou liberam Googlebot genérico e ignoram que, hoje, há mais de dez tokens de user-agent do Google circulando, cada um com efeito diferente. Auditar isso é o primeiro passo antes de mexer em qualquer linha.
Os user-agents do Google, um a um
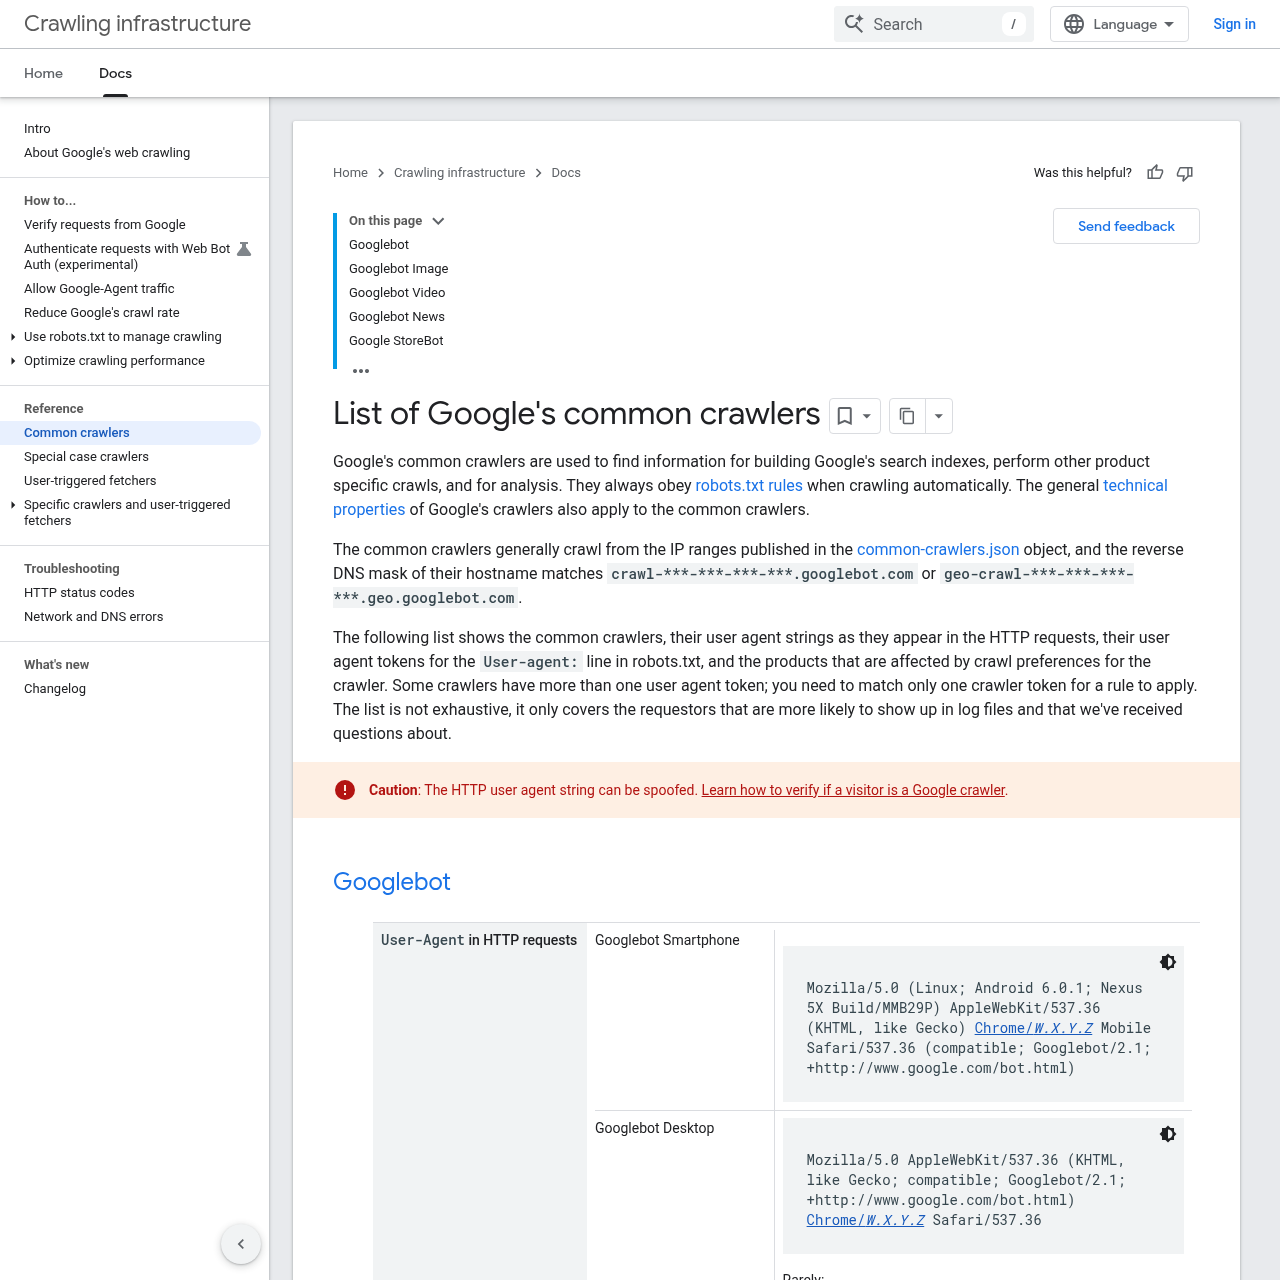
A tabela abaixo resume o que a documentação oficial diz sobre cada token que pode aparecer num bloco user-agent: do robots.txt. É a referência que eu consultaria antes de escrever qualquer regra nova.
| Token em robots.txt | O que rastreia | Afeta o quê |
|---|---|---|
Googlebot | Busca geral (desktop e smartphone) | Google Search (incluindo Discover e demais recursos de busca), além de outros produtos como Google Imagens, modo Vídeo e Google News |
Googlebot-Image | Imagens | Google Imagens, favicons, miniaturas em resultados |
Googlebot-Video | Vídeos | Recursos de vídeo na busca |
Googlebot-News | Notícias | news.google.com e o app Google News |
Storebot-Google | E-commerce↳E-commerce21 conteúdosECBR Club: novo espaço para devs se conectarem ao ecossistema de e-commerceDev (Back & Front) · mai 2025TOTVS anuncia joint venture com VTEXMarketing Tech · mai 2019Jovens da Brasilândia recebem formação gratuita em tecnologiaGestão Dev & TI · jul 2025Ver tudo em Marketing Tech → | Google Shopping e a aba Shopping na busca |
Google-InspectionTool | Testes sob demanda | Teste de Rich Results e inspeção de URL no Search Console |
GoogleOther | Rastreamento genérico | Pesquisa e desenvolvimento interno, sem produto específico |
GoogleOther-Image / GoogleOther-Video | Variante de GoogleOther | Idem, otimizado para imagem ou vídeo |
Google-CloudVertexBot | Rastreamento sob demanda do cliente | Agentes do Vertex AI, não afeta a busca |
Google-Extended | Nenhum (usa os user-agents já existentes) | Treino de modelos Gemini e grounding no Gemini e no Vertex AI |
Repare numa coisa: Google-Extended não tem string própria de user-agent numa requisição HTTP. Ele não aparece no log do servidor como um visitante distinto; é puramente um token de controle dentro do robots.txt, acionado durante rastreamentos já feitos com os user-agents convencionais do Google.
Google-Extended não é o botão de sair das AI Overviews
Aqui mora o engano mais comum que eu vejo em auditorias: achar que bloquear Google-Extended tira a página das AI Overviews. A própria documentação do Google é direta ao afirmar que isso não afeta a inclusão do site na Busca, embora não trate especificamente do recurso de AI Overviews.
O Google-Extended não afeta a inclusão do site na Busca do Google e não é usado como sinal de ranqueamento na Busca do Google.
Google Search Central, documentação de crawlers
Em resumo: Google-Extended controla duas coisas específicas, treino de modelos Gemini futuros e grounding (a técnica de alimentar o modelo com trechos do índice de busca no momento da resposta, para melhorar precisão factual) dentro do app Gemini e do Vertex AI. A documentação oficial não trata especificamente das AI Overviews, mas é razoável supor, na minha leitura, que, por se tratar de um recurso dentro da própria Busca, ele dependa do mesmo índice construído por Googlebot. Se essa leitura estiver correta, bloquear Google-Extended não remove a página desse índice nem desse recurso, mas essa extensão não é afirmada explicitamente pelo Google.
Se o objetivo é realmente não aparecer nas AI Overviews, a ferramenta certa não é Google-Extended: é noindex, nosnippet ou max-snippet via meta robots, e isso tem o efeito colateral de também tirar a página dos resultados normais ou do trecho exibido neles. Não existe, hoje, um interruptor que mantenha a página no ranking tradicional e a exclua só da caixa de IA.
Passo a passo: auditando o robots.txt de um site típico
Num projeto típico de um site de conteúdo brasileiro (um blog técnico, um portal de notícias, um e-commerce), este é o roteiro que eu seguiria antes de tocar em qualquer linha do arquivo.
- Baixe o arquivo em produção: acesse
https://seudominio.com.br/robots.txtdireto no navegador e salve o conteúdo atual antes de editar. - Liste todo bloco
user-agent:existente e marque quais tokens da tabela acima aparecem (e quais não aparecem, porque silêncio também é uma decisão). - Separe as regras por objetivo: indexação normal (
Googlebot), aparição em imagens ou vídeos (Googlebot-Image,Googlebot-Video), treino e grounding de IA (Google-Extended). - Confira os logs do servidor por user-agents que afirmam ser do Google e valide com DNS reverso: um rastreador legítimo do Google resolve para
crawl-***-***-***-***.googlebot.comougeo-crawl-***-***-***-***.geo.googlebot.com. Qualquer coisa fora desse padrão pode ser spoofing. - Decida, regra por regra, qual token recebe
allowoudisallow, sem copiar um bloco genérico de outro site.
Configurando por objetivo
Com os tokens identificados, a configuração vira questão de combinar blocos. Um exemplo de robots.txt que indexa normalmente, mas nega treino e grounding de IA:
User-agent: Googlebot
Allow: /

User-agent: Googlebot-Image
Allow: /

User-agent: Google-Extended
Disallow: /

User-agent: GoogleOther
Disallow: /
Esse arquivo mantém o site elegível para busca, Discover e Google Imagens (porque Googlebot e Googlebot-Image seguem com Allow: /), recusa que o conteúdo treine modelos Gemini futuros ou alimente grounding (Google-Extended com Disallow: /) e fecha a porta para rastreamentos exploratórios de produtos ainda não documentados (GoogleOther).
Se o objetivo for o oposto, permitir que o conteúdo ajude a treinar os modelos (alguns editores fazem isso de propósito, trocando visibilidade em respostas de IA por tráfego de referência), basta inverter a regra:
User-agent: Google-Extended
Allow: /
E se a intenção é bloquear uma seção específica, como um fórum com conteúdo gerado por usuário, sem tirar o resto do site do treino, o Disallow aceita caminho:
User-agent: Google-Extended
Disallow: /forum/
Allow: /
Validando no Search Console e no testador
Editar o robots.txt sem validar é a parte onde a maioria dos erros de auditoria aparece. Dois caminhos complementares resolvem isso.
- Inspeção de URL: testa uma página específica e mostra se ela está bloqueada para
Googlebot; essa checagem roda com o user-agentGoogle-InspectionTool, que a documentação confirma não afetar a busca em si, só a própria ferramenta de teste. - Teste manual por linha de comando:
curl -A "Googlebot" https://seudominio.com.br/paginasimula a requisição e confirma que o servidor não está bloqueando por outro mecanismo (firewall, CDN) além dorobots.txt.
Nenhuma dessas ferramentas confirma, porém, se uma página específica está sendo usada para treinar o Gemini ou aparecer em grounding: isso é efeito interno do Google e, hoje, não tem painel de verificação pública. O máximo que dá para medir é se a regra de Google-Extended foi lida sem erro de sintaxe.
O que fica em aberto
Duas limitações vale deixar claras para quem for medir o impacto dessa mudança. Primeiro, como Google-Extended não gera uma string de user-agent própria nos logs, não dá para confirmar via log de servidor se o bloqueio está, de fato, impedindo um rastreamento, só se o arquivo foi lido corretamente. Segundo, não existe hoje controle granular para tirar uma página só das AI Overviews sem tirá-la também dos resultados tradicionais, então quem depende de tráfego de busca precisa aceitar esse pacote fechado ou abrir mão dele por inteiro.
Fonte: Google Search Central — Crawlers do Google (incluindo Google-Extended)
Highlights
- Google-Extended não aparece como user-agent nos logs do servidor; é token de controle puro do robots.txt
- Bloquear Google-Extended não remove páginas das AI Overviews, que usam o índice do Googlebot
- Mais de dez user-agents diferentes do Google circulam; cada um controla um produto específico
- Não existe hoje forma de manter ranking tradicional e sair só das AI Overviews
- Validar robots.txt via relatório no Search Console confirma se arquivo foi lido corretamente
Este artigo foi escrito por Sabrina Santos, colunista de SEO. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Documentação do Google confirma: não há requisito técnico extra para aparecer em AI Overviews
Guia da Google Search Central, atualizado em dezembro de 2025, reforça que a elegibilidade para AI Overviews e AI Mode depende dos mesmos fundamentos técnicos de indexação do Search, sem critério adicional.