O llms.txt ganha a versão 2, mas suporte dos grandes modelos de IA ainda não está confirmado

A especificação llmstxt.org chegou à segunda versão depois de dois anos de adoção desde 2024. Para quem faz GEO, a pergunta que importa é se publicar o arquivo move tráfego de verdade ou só atende quem já publica por conta própria.
- Leitura
- 6 min
- Tabelas
- 1
- Código
- 1
- Fontes
- 1
A especificação llmstxt.org chegou à segunda versão depois de dois anos de adoção desde 2024. Para quem faz GEO, a pergunta que importa é se publicar o arquivo move tráfego de verdade ou só atende quem já publica por conta própria.
O arquivo que promete documentação para robôs
A proposta nasceu em 2024 e virou um pequeno padrão de fato: milhares de sites publicam um arquivo /llms.txt na raiz, ou em qualquer subpasta, como /docs/llms.txt, cobrindo as páginas daquele caminho. A ideia é simples. Em vez de obrigar um agente de IA↳Agentes de IA42 conteúdosOpera passa a integrar ChatGPT, Claude e outros agentes de IADev (Back & Front) · mar 2026Operações mais inteligentes, decisões mais rápidas: o impacto da IA agêntica na rotina de TIAI · abr 2026Adobe aposta em orquestração de agentes de IA: o que muda para devsDev (Back & Front) · abr 2026Ver tudo em AI → a raspar uma página HTML↳HTML45 conteúdosA importância do HTML e CSS para quem trabalha com UI Design e Design SystemProduto & UX · dez 2024Como hostear seu site HTML gratuitamente com GitHub PagesDev (Back & Front) · jun 2025SQL Server – Como criar um versionamento de código das suas Stored Procedures em HTML e com comentários da alteraçãoData · nov 2020Ver tudo em Dev (Back & Front) → cheia de menu, propaganda e JavaScript, o site oferece um resumo em markdown com links diretos para o conteúdo relevante, já em formato enxuto.
A especificação, hospedada em llmstxt.org, chegou à versão 2 depois de dois anos de adoção desde a proposta original de 2024. Mudou pouco na essência, mas incorporou o aprendizado de quem já publicou o arquivo: a estrutura ficou mais rígida, para permitir leitura tanto por LLMs quanto por ferramentas clássicas de parsing e regex.
Como o formato funciona, seção por seção
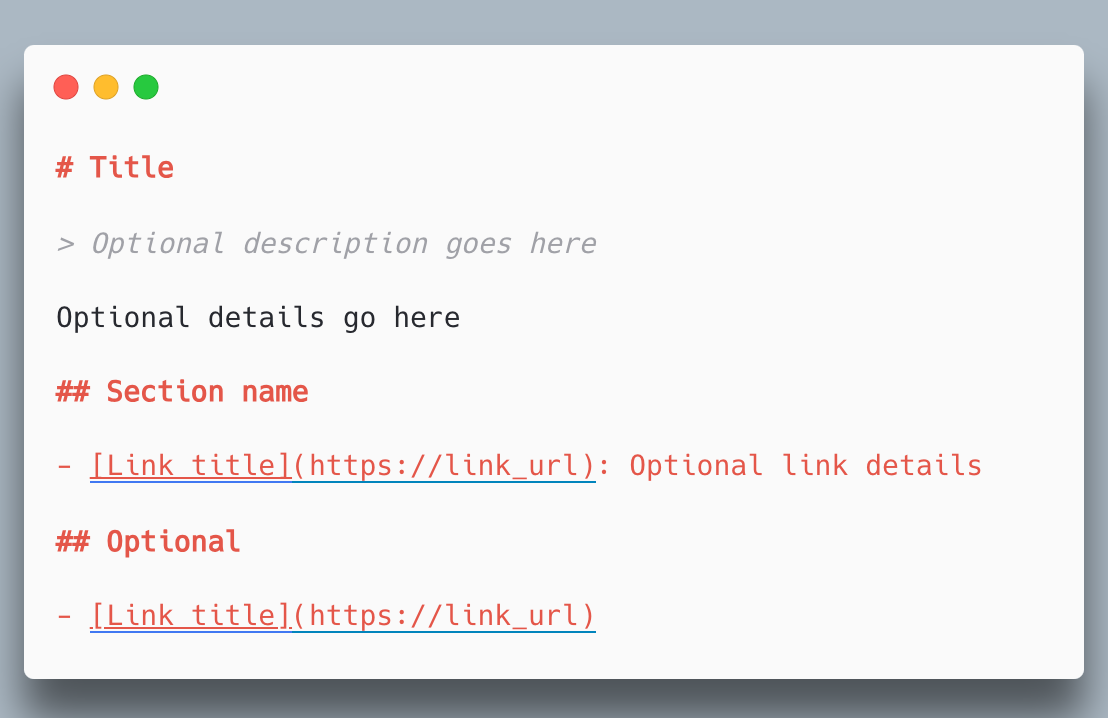
A especificação define uma ordem fixa de blocos markdown. Só o título é obrigatório; o resto é opcional, mas segue uma ordem específica quando presente:
- Um
H1com o nome do projeto ou site (único item obrigatório). - Uma citação (
>) com um resumo curto do que o site faz. - Parágrafos ou listas livres com contexto adicional.
- Seções
H2com listas de links no formato[nome](url): descrição opcional.
Um exemplo reduzido, baseado no que o projeto FastHTML publica em seu llms.txt:
# FastHTML

> FastHTML é uma biblioteca Python que une Starlette, Uvicorn, HTMX e o FastTags do fastcore numa lib para apps server-rendered.

## Docs

- [Quick start](https://fastht.ml/docs/tutorials/quickstart_for_web_devs.html.md): visão geral dos principais recursos

## Optional

- [Exemplo de todo list](https://github.com/AnswerDotAI/fasthtml/blob/main/examples/adv_app.py): app CRUD completo
A seção chamada Optional, por convenção, reúne links que um agente pode ignorar quando o contexto precisa ser mais curto. A especificação também propõe publicar uma versão markdown de cada página (pagina.html.md ou pagina.md), anunciada via rel="alternate" type="text/markdown" no HTML ou num cabeçalho HTTP Link:, o que permite adicionar o recurso via configuração de CDN sem tocar no código das páginas.
Como isso se encaixa ao lado de robots.txt e sitemap.xml
A especificação é explícita: llms.txt não substitui os dois padrões que já existem na raiz de qualquer site. Os três convivem, mas servem públicos e propósitos diferentes.
| Arquivo | Para quem é | O que lista | Consumo confirmado |
|---|---|---|---|
robots.txt | Crawlers de busca e de IA | Regras de acesso (permitir/bloquear) | Sim, padrão respeitado há décadas, inclusive por bots declarados como GPTBot |
sitemap.xml | Buscadores tradicionais | Todas as URLs indexáveis do site | Sim, usado há anos por Google, Bing etc. |
llms.txt | Agentes e LLMs | Resumo curado + links para versões markdown | Não confirmado publicamente pelos grandes provedores de modelo |
Quem publica, e quem já gera isso sozinho
A adoção citada na própria especificação dá pistas de quem está levando o padrão a sério. A plataforma de documentação Mintlify gera o llms.txt e as versões .md automaticamente para todo site que hospeda; o GitBook, por sua vez, serve um arquivo llms.txt para os sites de documentação publicados em sua plataforma, sem que a especificação detalhe geração automática de versões .md nesse caso. Plugins de WordPress como Yoast SEO↳SEO4 conteúdosPor que a transição do SEO clássico para a Otimização de Motores Generativos (GEO) exige que se repense a modelagem semânticaMarketing Tech · mai 2026O impacto da pesquisa e do SEO no comércio eletrônico: insights da State of Search Brasil 5Marketing Tech · fev 2025SEO por Elas 2025: Impulsionando e promovendo mulheres no Marketing DigitalMarketing Tech · fev 2025Ver tudo em Marketing Tech → e AIOSEO já incluem um gerador do arquivo, e o Wix faz o mesmo para qualquer site criado na plataforma.
Do lado de framework, existem plugins prontos: vitepress-plugin-llms para VitePress, docusaurus-plugin-llms para Docusaurus, uma recipe para Drupal 10.3+ e até um servidor MCP, o server-llm-txt, que permite a um agente buscar e pesquisar arquivos llms.txt pela rede. O Lighthouse do Chrome passou a auditar a presença do arquivo como parte das checagens de agentic browsing. OpenAI, Anthropic e Google publicam llms.txt para a própria documentação de desenvolvedor, um dado real citado na especificação, mas que merece leitura cuidadosa.
O ponto cego: publicar não é o mesmo que ser lido
Aqui mora a pergunta que interessa a quem faz growth e SEO técnico: o fato de OpenAI, Anthropic e Google publicarem llms.txt para as próprias docs não prova que ChatGPT, Claude ou Gemini leem o llms.txt de terceiros ao responder um usuário. São coisas diferentes. Uma é a empresa ajudando agentes, inclusive de concorrentes, a entender a própria API; a outra seria o produto de IA consumindo o arquivo de um site qualquer durante uma busca ou uma resposta.
Não há, na especificação nem em documentação pública de OpenAI, Anthropic ou Google, confirmação de que os crawlers usados para treinamento ou recuperação, como GPTBot, ClaudeBot ou Google-Extended, tratam o llms.txt de forma especial. O próprio documento é honesto sobre essa limitação:
Nossa expectativa era que o llms.txt fosse útil principalmente para inferência, não para treinamento, e foi assim que ele tem sido usado, embora rodadas de treinamento também possam aproveitar essa informação.
(fonte: especificação oficial do llms.txt, em llmstxt.org)
Our expectation was that llms.txt would mainly be useful for inference rather than training, and that is how it has been used, though training runs could take advantage of the information too.
Repare no verbo: expectativa, não confirmação. O documento descreve adoção (geradores automáticos, auditoria do Lighthouse, diretórios como llmstxt.site) mas não cita nenhum anúncio oficial de um provedor de modelo dizendo que seu retriever consulta /llms.txt antes de responder. Para quem faz GEO, essa distinção entre sinal adotado e sinal confirmado é a mesma cautela que já valia para dados estruturados antes do Google declarar oficialmente quais tipos de schema.org afetam rich results.
Como medir se o arquivo move alguma agulha
Como esse tema é GEO, e GEO sem medição é só opinião, o caminho é instrumentar antes de comemorar:
- Segmentar os logs do servidor por user-agent de crawler de IA (
GPTBot,ClaudeBot,PerplexityBot,Google-Extended,CCBot) e comparar o volume de hits no/llms.txtantes e depois de publicá-lo. - No Google Analytics 4, isolar tráfego de referência vindo de domínios como
chatgpt.com,claude.aieperplexity.ai, observando se o volume muda numa janela de 60 a 90 dias após a publicação. - Checar via grep no access log se o arquivo recebe requisições de fato, não só se ele existe no servidor.
- Tratar o experimento como antes/depois com período de controle, já que publicar o arquivo tem custo baixo demais para justificar um teste controlado mais caro.
Se, passado esse período, nenhum desses sinais se mover, o llms.txt não está sendo consumido por quem o site queria alcançar, pelo menos não ainda.
Quando publicar vale o esforço, e quando é só achismo
Para sites de documentação técnica e ferramentas de desenvolvedor, o cálculo é mais favorável: agentes de código, como o que roda atrás da extensão PagePilot do VS Code, ou qualquer cliente que use o servidor MCP server-llm-txt, de fato consultam llms.txt por desenho. Esse público é verificável e documentado na própria especificação, diferente do tráfego de buscadores conversacionais de massa.
Para sites de marketing e conteúdo institucional torcendo para aparecer citados numa resposta do ChatGPT, a aposta é mais fraca. O custo de publicar é baixo, sobretudo se a plataforma já gera o arquivo, como Mintlify, GitBook ou Wix, mas a expectativa de retorno precisa ser modesta até que OpenAI, Anthropic ou Google confirmem publicamente o consumo do arquivo nos próprios produtos de busca e chat. Publicar não atrapalha; prometer ao cliente que o llms.txt vai gerar tráfego de IA é vender um resultado que a especificação, lida com atenção, ainda não garante.
Highlights
- Especificação llms.txt chega à versão 2 após dois anos de adoção desde 2024, com estrutura mais rígida.
- Milhares de sites já publicam o arquivo; Mintlify, GitBook e Wix geram automaticamente para clientes.
- Sem confirmação pública de OpenAI, Anthropic ou Google sobre consumo do arquivo por GPTBot, ClaudeBot ou Google-Extended.
- Para GEO, medir impacto exige segmentar logs de crawler de IA antes e depois da publicação.
Com opiniões de
O que especialistas disseram no X sobre o assunto.
 Erick Wendel | localstudio.dev@erickwendel_Applied AI Engineer, MVP Microsoft, DevExpert Google, alumni GitHub
Meus amigos, isso aqui é incrível (vem ver) Eu construí um projeto real com Mastra, MCP (Model Context Protocol) e Playwright: você cola o link de um evento, e o agente entra no site, encontra a minha palestra, descobre a data, o horário e o endereço e ainda coloca tudo no
Este artigo foi escrito por Sabrina Santos, colunista de SEO. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Search Console não isola o tráfego de AI Overviews: tudo cai no relatório Web
A documentação do Google Search Central confirma: cliques vindos de AI Overviews e AI Mode entram no mesmo balde do tráfego de busca tradicional no Search Console. Não existe um filtro dedicado, e isso muda como o time de growth precisa pensar a medição.