Projeto compila a CPU inteira do NES nos pesos de um modelo Qwen, sem treinar nada


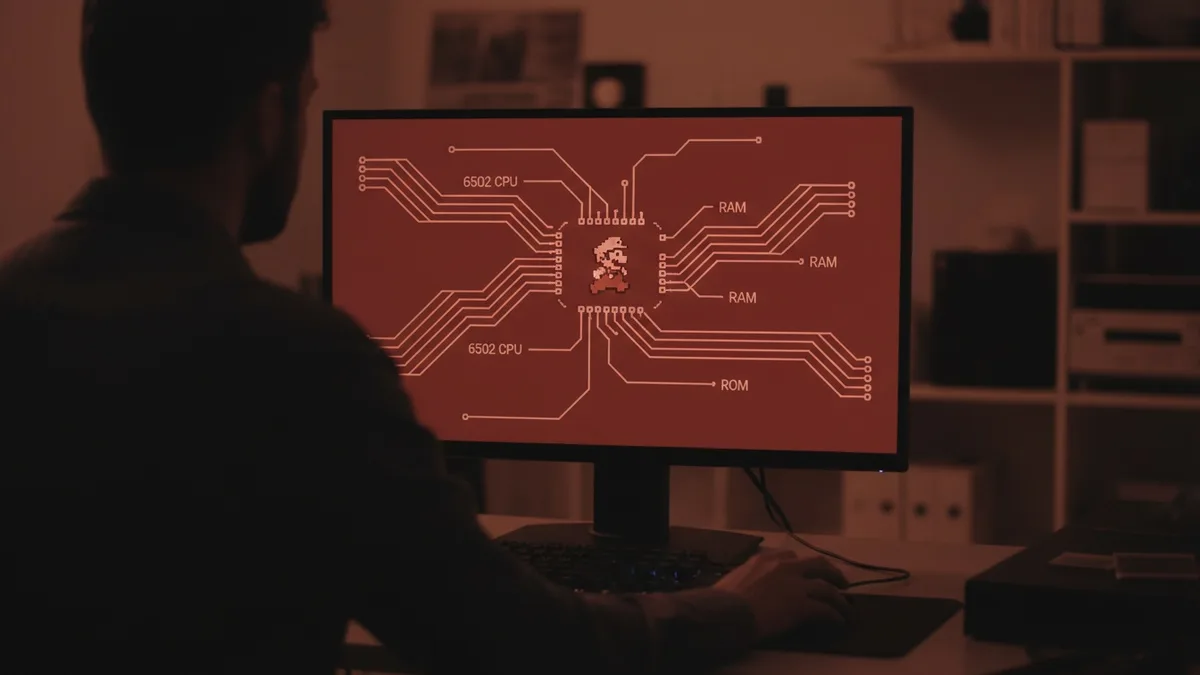
O compilador do projeto nesformer traduz o 6502, a RAM e a ROM do NES em pesos de atenção linear de um Qwen3.5, sem gradiente, e roda Super Mario Bros. centenas de vezes mais devagar que o console original.
- Leitura
- 11 min
- Tabelas
- 3
- Código
- 2
- Fontes
- 7
- Dados
- 42
Como o compilador chipformer traduz o circuito do 6502 em pesos de atenção linear, e que uso prático isso tem além de curiosidade?
Em resumoO chipformer mapeia cada linha da matriz de estado 128x128 do Gated DeltaNet para uma célula de memória endereçável por chave one-hot, e usa isso para implementar o 6502, a RAM e a ROM sem treinar nada; o valor prático está em provar que atenção linear pode servir como memória exata de propósito geral, não em rodar jogos em velocidade útil.
Você sai sabendo- O compilador chipformer não treina pesos: ele calcula cada um a partir de uma descrição manual do circuito do 6502
- O estado do Gated DeltaNet vira memória endereçável quando o gate fica em 1 e a chave é one-hot, cada linha da matriz 128x128 é uma célula
- A velocidade é o limite prático: mesmo na engine mais rápida, o nesformer é de 150 a 290 vezes mais lento que o NES original de 1983
- A maior parte do checkpoint (457 milhões de parâmetros) é só zero de preenchimento estrutural, exigido pela arquitetura Qwen3.5 padrão
- O valor do projeto não está em jogar games, está em demonstrar capacidade de memória exata em arquiteturas de atenção linear usadas em produção
Dados até nov/2026
Edição enriquecida em 09 de novembro de 2026: 7 fontes lidas na íntegra e cruzadas com apoio de IA, revisada e aprovada por tiago@imasters.com.br.
Antes, 1.314 palavras e 1 fonte(s). Agora, 2.331 palavras e 7 fontes.
Em resumo
O nesformer usa um compilador chamado chipformer (herdado do projeto Qwenputer) para traduzir, porta lógica por porta lógica, o circuito do 6502, os 2 KB de RAM de trabalho e os 32 KB de ROM de um cartucho NES em pesos de um checkpoint padrão Qwen3_5ForCausalLM. Não há treinamento: um compilador calcula cada peso, e o jogo roda de verdade, token a token, mas centenas de vezes mais devagar que o NES original. A utilidade prática não está em jogar Mario, está em provar que o estado do Gated DeltaNet (o mecanismo de atenção linear do Qwen3.5) pode funcionar como memória endereçável exata dentro de uma arquitetura de produção.
- O compilador usa a disciplina de "porta aberta + chave one-hot" para transformar cada linha de uma matriz de estado 128x128 do DeltaNet em uma célula de memória.
- O checkpoint tem 466,6 milhões de parâmetros, mas só 9,3 milhões são diferentes de zero, por isso o arquivo compacta para 3,3 MB.
- A engine mais rápida roda a 1.650 tokens por segundo; um NES real precisaria de cerca de 700.000 tokens por segundo para tempo real.
- O valor prático está em DevOps↳DevOps29 conteúdosHabilite o Código de Segurança Azure DevOpsDevSecOps · jun 2025O que é DevOps – minha experiência como executivo nessa frenteDev (Back & Front) · abr 2026DevOps: a automação de processos de TI como estratégia de eficiência operacionalDev (Back & Front) · set 2024Ver tudo em DevSecOps → de pesquisa de arquiteturas lineares (DeltaNet, RWKV, Mamba), não em rodar jogos.
- 9,3 milhõesde 466,6 milhões de parâmetros do checkpoint são diferentes de zero
- 1.650 tokens por segundovelocidade máxima da engine mais rápida (numba), contra os 700.000 que o NES real exigiria
- 283.610posições da sequência de boot verificadas com exatidão contra o emulador de referência
- 3,3 MBtamanho do checkpoint compactado, apesar da estrutura de um Qwen3.5 inteiro
1. O que o compilador faz, exatamente
O nesformer, de dbreunig, pega três coisas: o núcleo 6502 (dentro do chip 2A03 do NES), os 2 KB de RAM de trabalho do console e os 32 KB de ROM de um cartucho, e as transforma em pesos de um checkpoint Qwen3_5ForCausalLM. Segundo o README do projeto, "nobody trained these weights; a compiler computed every one" (ninguém treinou esses pesos; um compilador calculou cada um deles).
Isso redefine o que "modelo" significa neste contexto. Não existe dataset, gradiente ou função de perda. Existe um compilador que traduz um circuito digital, porta lógica por porta lógica, em matrizes de atenção e MLPs de uma arquitetura Transformer já existente. O resultado joga Super Mario Bros., Donkey Kong e Excitebike de verdade, prevendo o próximo token do log de execução da CPU a cada passo.
2. Onde mora a RAM dentro de uma rede neural
O truque vem do projeto anterior Qwenputer, de Divyansh Agrawal, que compilou primeiro um CHIP-8 e depois um núcleo RISC-V dentro de um Qwen3.5-4B. O nesformer reaproveita o compilador do Qwenputer, chamado chipformer, e sua ideia central: usar o estado do Gated DeltaNet como memória endereçável.
Segundo o blog de Agrawal, cada cabeça de DeltaNet mantém uma matriz de estado de 128 x 128 que a regra delta atualiza a cada token. Com o portão (gate) fixado em 1, a força de escrita (beta) também fixada em 1, e uma chave codificada como one-hot, cada escrita sobrescreve exatamente uma linha dessa matriz, e uma consulta one-hot lê essa linha de volta. Cada linha vira, assim, uma célula de memória exata, ao contrário do comportamento padrão do Qwen 3.5, que não mantém valores exatos no DeltaNet.
É nessas linhas que moram o cartucho, a RAM de trabalho e os registradores do 6502. O DeltaNet não está "aprendendo" a jogar o game: está sendo usado como uma tabela de memória endereçável, e o compilador decide manualmente o que cada camada e cabeça de atenção guarda.
3. A divisão entre pesos e programa host
O checkpoint tem uma fronteira clara entre o que mora no modelo e o que mora no programa host (nesformer/host.py), escrito em Python↳Python56 conteúdosVSCode + Python + Alexa: Desenvolva e teste skills para alexa localmente com pythonDev (Back & Front) · out 2025Dominando decoradores em Python: um guia completo com exemplosDev (Back & Front) · jan 2025Desenvolvimento de software: diferenças entre Python, JavaScript e JavaGestão Dev & TI · nov 2024Ver tudo em Dev (Back & Front) → comum.
Tabela 1. O que fica nos pesos e o que fica no host
| Fica nos pesos (modelo + estado DeltaNet) | Fica no host (nesformer/host.py) |
|---|---|
| Núcleo 6502 completo: 151 opcodes oficiais, modos de endereçamento, flags, pilha, BRK e entrada de NMI | Renderizador de vídeo (PPU), scanline a scanline, e a paleta de cores |
| 2 KB de RAM de trabalho | Controles e registradores de áudio (escritos, mas ignorados) |
| 32 KB de PRG-ROM, guardados em duas cópias (uma para busca de instrução, outra para leitura de dado) | Timing de NMI no vblank, injetado como token |
| Leituras de DMA de OAM (os 256 bytes aparecem como tokens DM) | Respostas de leituras de I/O, injetadas como tokens IN |
Fonte: README do projeto nesformer, nov/2026
Essa divisão segue o mesmo padrão do CHIP-8 compilado no Qwenputer, cujo host também injeta ticks de temporizador e desenha a tela a partir do trace. O host nunca vê os registradores ou a RAM diretamente, só através do trace de tokens que o modelo gera.
4. Anatomia do checkpoint: muito grande, quase tudo zero
O checkpoint é uma pasta Hugging Face comum, que carrega com Qwen3_5ForCausalLM.from_pretrained sem código customizado. Ele usa as dimensões de cabeça de DeltaNet do Qwen3.5-4B (16 cabeças de chave, 32 de valor, dimensão 128) e a largura de MLP (9.216), com 7 camadas Gated DeltaNet, que implementam o circuito, mais uma camada de atenção totalmente zerada, que existe só porque o cache do Hugging Face exige.
Em números: 466,6 milhões de parâmetros em bf16 (933 MB), dos quais apenas 9,3 milhões são diferentes de zero, o que permite ao arquivo compactado caber em 3,3 MB. O hidden size é 768 e o vocabulário tem 263.808 tokens, cada um representando um evento específico do processador: uma instrução decodificada, uma leitura de I/O, uma escrita de DMA.
O arquivo nesformer.json registra exatamente qual camada e qual cabeça guarda cada parte da máquina, numa espécie de mapa de memória do circuito.
python -m nesformer build
python -m nesformer info
O primeiro comando compila o circuito e escreve a pasta weights/ (cerca de 10 segundos); o segundo descreve o checkpoint resultante.
5. Os números que provam, e não escondem, a trapaça
O repositório não se limita a afirmar que funciona: publica a verificação. Segundo o README, a CPU de referência bate com o log padrão do nestest em 3.348 instruções e com o emulador py65 em 5,7 milhões de instruções de jogo real. O circuito exato, avaliado com checagem de exatidão em bf16, prevê corretamente todos os tokens de referência, incluindo 283.610 posições da sequência de boot de dois jogos.
Rodando livre, sem forçar o próximo token correto, os resultados batem frame a frame com um emulador convencional.
Tabela 2. Execuções do nesformer e verificação contra um emulador convencional
| Execução | Tokens gerados | Frames | Tempo de NES simulado | Resultado |
|---|---|---|---|---|
| nestest (opcodes oficiais) | 4.586 | não informado | não informado | idêntico, termina no HALT esperado |
| Thwaite, modo check | 700.000 | 271 | 4,5 s | trace e frames idênticos |
| Thwaite, modo run | 1.916.527 | 600 | 10,0 s | todos os 300 frames salvos batem |
| Full Game, modo run | 2.645.885 | 420 | 7,0 s | todos os 210 frames salvos batem |
Fonte: README do projeto nesformer, nov/2026
6. Velocidade: 1.650 tokens por segundo contra 700 mil
Este é o ponto que separa curiosidade de produto. Segundo o README, a engine padrão, compilada com numba, roda a cerca de 1.650 tokens por segundo em um núcleo de CPU. A engine em numpy puro faz cerca de 210 tokens/s, e rodar o checkpoint na biblioteca transformers padrão (via --engine hf) cai para aproximadamente 10 tokens/s.
Tabela 3. Velocidade de geração por engine, contra o que o NES exigiria em tempo real
| Engine | Tokens por segundo |
|---|---|
| fast (numba) | 1.650 |
| numpy puro | 210 |
| hf (transformers padrão) | 10 |
| NES real (tempo real) | 700.000 |
Fonte: README do projeto nesformer, nov/2026
Mesmo na configuração mais rápida, o nesformer roda entre 150 e 290 vezes mais devagar que o console original de 1983. O próprio README admite isso sem rodeio: uma execução de 600 frames, ou 10 segundos de jogo, leva cerca de 25 minutos para ser gerada. O comando que dispara uma dessas sessões é simples:
python -m nesformer run roms/smb.nes --frames 600 --show \
 --buttons "start@60-65,right@200-600,a@250-265+300-315+360-375+420-435+480-495+540-555"
Esse script liga o jogo, anda com Mario para a direita e pula cerca de uma vez por segundo. O host carrega a ROM no estado do modelo na inicialização, então os mesmos pesos rodam qualquer jogo NROM sem precisar recompilar nada.
7. O que o projeto não faz
As limitações estão documentadas e são específicas, não genéricas:
- Só roda cartuchos NROM (mapper 0 do padrão iNES), porque a CPU só endereça 32 KB de ROM de cada vez, guardados numa tabela fixa dentro do modelo. Jogos maiores usam chips de bank switching (mappers como MMC1 ou MMC3) que o compilador ainda não implementa.
- Só opcodes oficiais do 6502: um opcode não documentado gera HALT.
- Código precisa rodar a partir da ROM do cartucho; um salto para dentro da RAM também gera HALT.
- Não há IRQs de APU ou DMC; só BRK e NMI funcionam.
- O PPU e o APU não estão nos pesos: a renderização é feita scanline por scanline pelo host, efeitos no meio de uma scanline não são reproduzidos, e não há som.
8. O que isso vale além da curiosidade
Vale separar o que o nesformer prova do que ele não prova. Ele não é evidência de que modelos pequenos resolvem, por raciocínio, tarefas que hoje exigem GPU cara: não há inferência semântica acontecendo, e o resultado é, na prática, um emulador de 6502 extremamente ineficiente, escrito à mão em forma de pesos de rede neural↳Deep learning9 conteúdosRedes neurais roots – Parte 01Dev (Back & Front) · abr 2019Redes neurais roots – Parte 02: treinamentoDev (Back & Front) · mai 2019Redes neurais roots – Parte 03: show me the codeDev (Back & Front) · mai 2019Ver tudo em AI →.
O que o projeto demonstra de concreto é outra coisa, relevante para quem acompanha arquiteturas de atenção linear: o estado de um Gated DeltaNet pode funcionar como memória endereçável de propósito geral, gravável e legível por chave one-hot, com a mesma disciplina de um array convencional. O blog de Agrawal já havia mostrado isso com um núcleo RISC-V completo (RV32IM mais extensão Zba), que passou nos testes oficiais riscv-tests, bateu com o qemu e rodou 18 milhões de instruções livres sem erro, chegando a 3.200 tokens de CPU por segundo em um L4. A análise teórica de capacidade de memória da atenção, de Guangxuan Xu, ajuda a explicar por que esse truque funciona: a atenção linear tem capacidade O(d), que escala de forma proporcional à dimensão do estado, o que é suficiente para endereçar de forma exata um número limitado e conhecido de células, como as que um 6502 precisa.
Para quem mexe com DeltaNet, RWKV, Mamba ou qualquer state space model em produção, o valor prático está no arquivo nesformer.json e no plano de camadas documentado no repositório: eles mostram, com granularidade de bits, como compilar um estado determinístico dentro de uma arquitetura recorrente linear, algo que normalmente fica escondido atrás de treinamento. O código está sob licença MIT, roda com pip install numpy scipy numba pillow e os testes (python -m pytest -q tests) reproduzem toda a cadeia de verificação descrita no README.
Onde as fontes discordam
Sobre o significado mais amplo desse tipo de compilação de circuitos em pesos, há divergência. Um comentário no Hacker News sobre o projeto irmão Qwenputer (publicado no r/RISCV) argumenta que o resultado tem pouca relevância específica para a arquitetura escolhida: segundo o usuário brucehoult, "se tivesse implementado ARMv2 ou 6502 não haveria essencialmente diferença nas conclusões", sugerindo que o valor está na técnica de compilação, não no circuito-alvo. Já outro ângulo, representado pelo artigo sobre Weight-Space Programming (MIT CSAIL, com o modelo GPT-6 Astra), defende que o caminho mais promissor é o oposto do nesformer: não compilar circuitos manualmente em pesos, mas fazer um LLM de uso geral ler e editar pesos de outro modelo diretamente, sem compilador e sem gradiente. Críticos desse segundo trabalho, como o engenheiro Sean Goedecke e o criador do spaCy Matthew Honnibal, contestam se isso é de fato uma capacidade nova do modelo ou um resultado que qualquer pesquisador competente reproduziria manualmente, e apontam que os experimentos com modelos de linguagem reais dependeram de ferramentas externas (Python, lotes de prática), diferente da leitura pura de pesos usada nos testes com redes pequenas.
O que fazer agora
- Se o objetivo é entender DeltaNet ou outro mecanismo de atenção linear em profundidade, leia o
nesformer.jsone a tabela de camadas do README junto com o blog do Qwenputer: eles mostram exatamente que operação de chave e valor one-hot sustenta cada parte do circuito. - Se o objetivo é rodar o projeto localmente para inspecionar o comportamento, use a engine
fast(numba) por padrão, e reserve--engine hfsó para depurar com ferramentas padrão de transformers, aceitando a queda para cerca de 10 tokens por segundo. - Se o interesse é aplicar a ideia de memória endereçável em um projeto próprio de modelo recorrente linear (DeltaNet, RWKV, Mamba), comece pelo caso mais simples documentado, o CHIP-8 do Qwenputer, antes de tentar reproduzir a escala do 6502 completo do nesformer.
- Se a dúvida é se isso substitui emuladores tradicionais em produção, não: a diferença de velocidade, de 150 a 290 vezes mais lento que o NES original mesmo na configuração mais rápida, torna o uso prático restrito a pesquisa e demonstração, não a jogos reais.
Fontes: Hacker News · GitHub (README do projeto nesformer, dbreunig) · Reddit r/RISCV (repost de divagr.com sobre Qwenputer) · arXiv (Gated DeltaNet-2) · Divyansh Agrawal (blog pessoal, Qwenputer) · alphaXiv (Sparks of Weight-Space Programming) · Wikipedia (Weight-space programming) · guangxuanx.com (The Memory Capacity of Attention)
Highlights
- Nesformer compila NES inteiro em pesos do Qwen3.5 sem treino, rodando Super Mario token por token
- Usa o Gated DeltaNet como RAM exata: 128x128, gate=1, beta=1, chave one-hot endereça cada linha
- CPUs de 151 opcodes, 2KB RAM, 32KB ROM viram 9,3M pesos não-zero em 3,3 MB compactado
- Motor numba roda 1.650 tokens/s, mas NES real precisa 700 mil, então jogo fica 150 vezes mais lento
- Prova que atenção linear pode funcionar como memória endereçável exata em produção, não que pequenos modelos raciocinam
Para fazer no seu projeto 0 de 3 feitas
Para ir além
- Repositórionesformer/README.md at mainDocumenta o layout exato de camadas e cabeças, os comandos de build e run, e os números de verificação citados no texto
- ArtigoQwenputer: a fully functioning, deterministic RISC-V CPU inside Qwen3.5Explica em detalhe o mecanismo de memória endereçável no Gated DeltaNet que o nesformer reutiliza, com números de acurácia e velocidade do núcleo RISC-V
- EstudoGated DeltaNet-2: Decoupling Erase and Write in Linear AttentionContextualiza tecnicamente o mecanismo de porta e escrita do Gated DeltaNet usado como base de memória no compilador
- ArtigoThe Memory Capacity of AttentionDá a base teórica de por que a atenção linear consegue endereçar um número limitado de células com exatidão, relevante para entender os limites do truque do nesformer
Fontes cruzadas 7 fontes, na ordem em que entram
- GitHub (README do projeto nesformer, dbreunig)Fonte principal: arquitetura do checkpoint, divisão modelo/host, números de verificação e velocidadeLer a fonte
- Reddit r/RISCV (repost de divagr.com sobre Qwenputer)Fonte da seção de discordância, comentário de brucehoult sobre a relevância da arquitetura-alvoLer a fonte
- arXiv (Gated DeltaNet-2)Contextualização técnica do mecanismo de porta e escrita do Gated DeltaNetLer a fonte
- Divyansh Agrawal (blog pessoal, Qwenputer)Explicação original do truque de memória endereçável via DeltaNet e números do núcleo RISC-VLer a fonte
- alphaXiv (Sparks of Weight-Space Programming)Contraponto sobre edição direta de pesos por LLMs, usado na seção de discordânciaLer a fonte
- Wikipedia (Weight-space programming)Fonte das críticas de Sean Goedecke e Matthew Honnibal citadas na seção de discordânciaLer a fonte
- guangxuanx.com (The Memory Capacity of Attention)Base teórica sobre capacidade O(d) da atenção linear, usada para explicar por que o truque de memória funcionaLer a fonte
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

CRA da União Europeia transforma supply chain security em obrigação de código para quem exporta pro bloco
Um podcast da InfoQ com o CTO da OpenSSF detalha como ferramentas como Scorecard e SLSA viraram caminho prático para cumprir o Cyber Resilience Act, a lei europeia que já afeta quem exporta software para o bloco.