GitHub redesenha o armazenamento do Git para suportar 5.000 agentes de IA simultâneos
O GitHub reconstruiu a camada de armazenamento que guarda cada repositório, sustentando em testes internos 5.000 agentes de IA escrevendo ao mesmo tempo em um único repositório, a 7.200 pushes por segundo.

- Leitura
- 9 min
- Fontes
- 1
O GitHub reconstruiu a camada de armazenamento que guarda cada repositório, sustentando em testes internos 5.000 agentes de IA↳Agentes de IA42 conteúdosOpera passa a integrar ChatGPT, Claude e outros agentes de IADev (Back & Front) · mar 2026Operações mais inteligentes, decisões mais rápidas: o impacto da IA agêntica na rotina de TIAI · abr 2026Adobe aposta em orquestração de agentes de IA: o que muda para devsDev (Back & Front) · abr 2026Ver tudo em AI → escrevendo ao mesmo tempo em um único repositório, a 7.200 pushes por segundo.
O GitHub reconstruiu a camada de armazenamento que guarda cada repositório, sustentando em testes internos 5.000 agentes de IA escrevendo ao mesmo tempo em um único repositório, a 7.200 pushes por segundo.
O gargalo que agentes de IA expuseram no Git
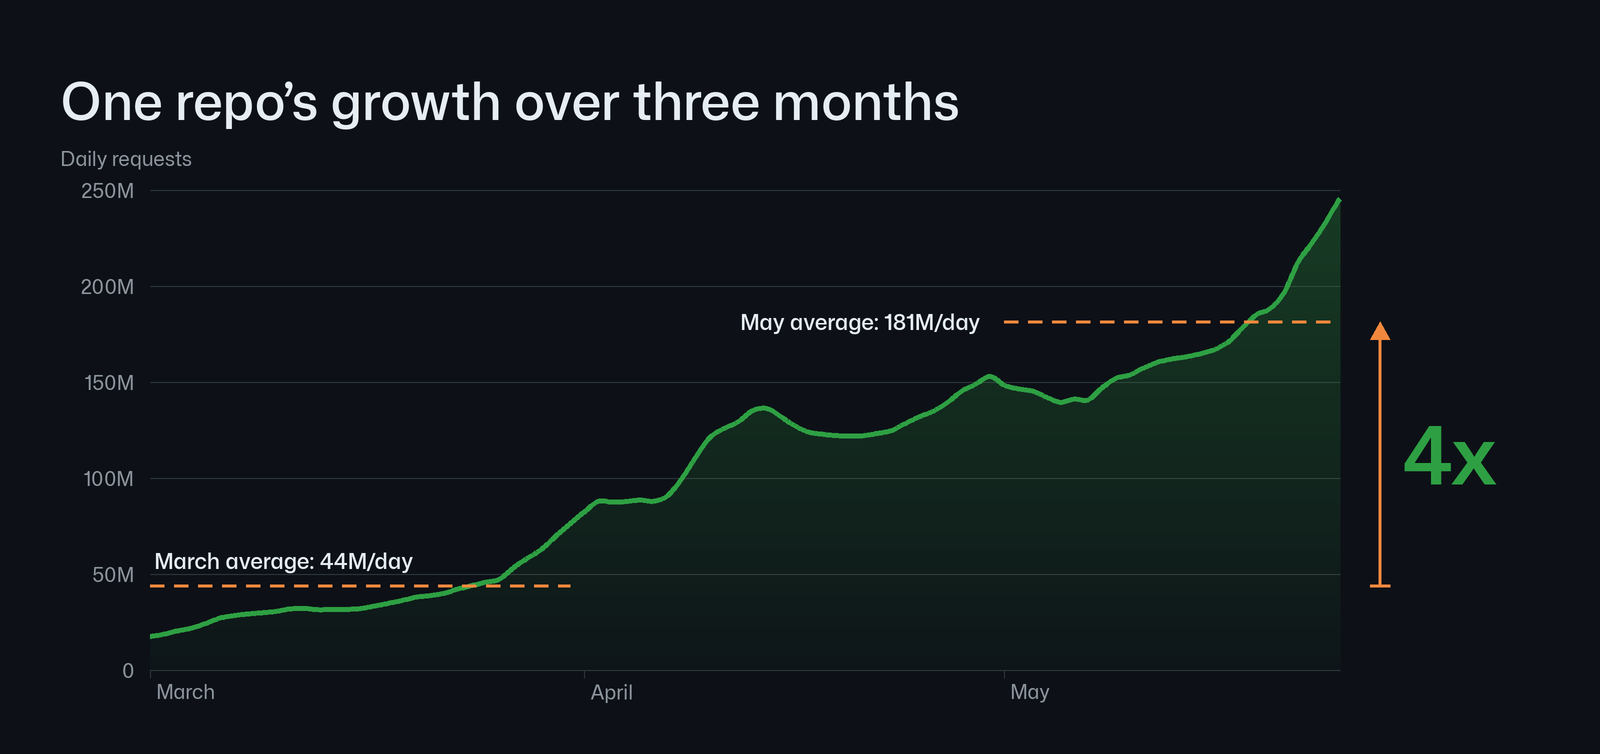
Hoje, os repositórios mais movimentados do GitHub recebem no máximo algumas dezenas de escritas por segundo, em rajadas curtas. Segundo o GitHub, à medida que mais desse trabalho passa a ser feito por agentes rodando em paralelo e 24 horas por dia, a empresa espera que essas rajadas se tornem uma taxa sustentada ao longo do próximo ano. Um repositório específico, mostrado pelo GitHub em gráfico interno, teve o tráfego diário multiplicado por 4 entre março e maio, e a curva seguiu crescendo de forma exponencial depois disso.
O problema não é só o volume de git push. Cada push gera leituras em cascata: pipelines de CI disparam, sistemas de deploy puxam o novo commit, e outros agentes buscam o código para ter contexto antes de continuar trabalhando. Esse efeito de amplificação faz o tráfego de leitura crescer junto com o de escrita, multiplicando a pressão sobre a infraestrutura que guarda e serve os repositórios.
Foi esse cenário que levou o GitHub a redesenhar, debaixo do capô e com a plataforma no ar, a camada de armazenamento que sustenta todo repositório Git do site. O anúncio saiu na GitHub Universe, na semana anterior ao post publicado em 5 de novembro de 2026 no blog de engenharia da empresa, assinado por Karthik Raman e Brian Celenza (fonte).
Project Rubicon: dois princípios, uma reconstrução em produção
O trabalho começou em maio de 2026, logo depois de o GitHub concluir a migração de 99,99999% dos repositórios para o Azure↳Azure76 conteúdosDeploy de Azure Stream Analytics job com CI/CD usando Azure PipelinesDevSecOps · mai 2019Azure – Como criar uma base de dados SQL no Microsoft Azure pronta para ser utilizadaData · abr 2019Azure Static Web Apps com Vue.js e Visual Studio CodeDevSecOps · out 2023Ver tudo em DevSecOps →, etapa coberta num post anterior da mesma série. A equipe batizou o projeto de "Rubicon".
Chamamos esse projeto de "Rubicon", uma referência ao ponto sem volta que a indústria cruzou com o desenvolvimento orientado a agentes.
Karthik Raman e Brian Celenza, GitHub EngineeringWe called it "Rubicon," a nod to the point of no return the industry crossed with agentic development.
Dois princípios guiaram o design. O primeiro é minimizar coordenação: como objetos Git são imutáveis e nomeados pelo próprio conteúdo, dois escritores podem gravá-los ao mesmo tempo sem precisar concordar em nada. Só a atualização da referência, o ponteiro que diz onde uma branch está, exige acordo entre escritores, e essa parte é minúscula perto do resto de um push.
O segundo princípio é desacoplar armazenamento de computação. Guardar dados, servir requisições e fazer manutenção do repositório deixam de estar amarrados na mesma máquina e passam a escalar cada um por conta própria.
Como fica a arquitetura: Spokes, réplicas virtuais e Ref-CAS
Na ponta de entrada, nada muda para quem usa Git: as requisições de clientes Git, da API e da interface web continuam chegando pelo Spokes, que faz roteamento e balanceamento de carga. A camada de dados abaixo dele é que foi reconstruída.
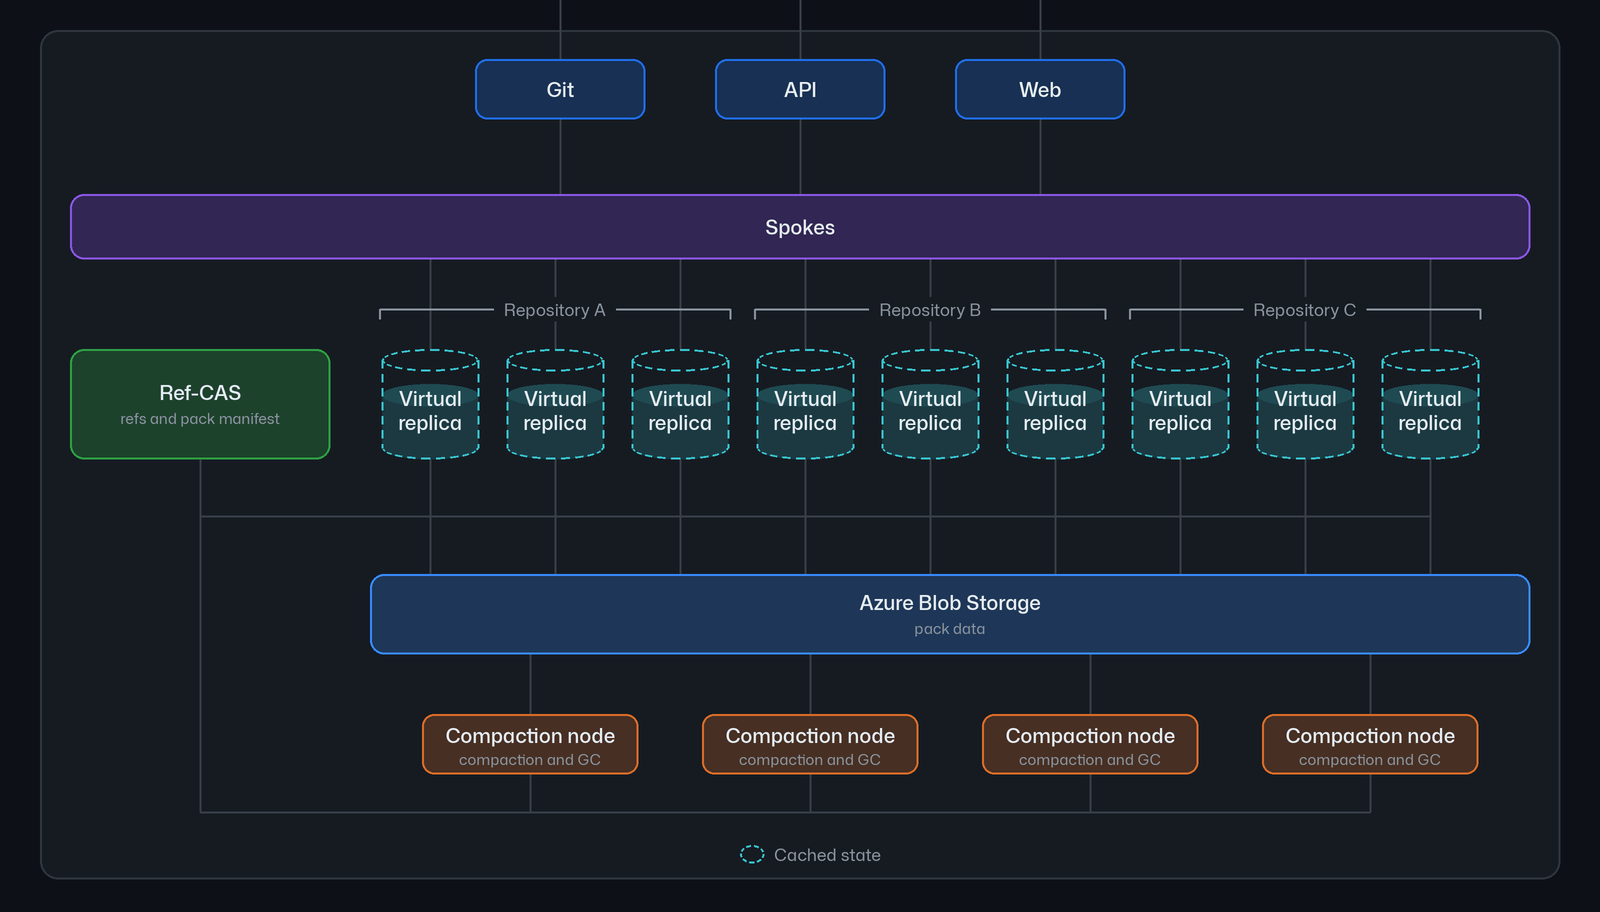
O Spokes roteia cada requisição para uma de um pequeno grupo de réplicas virtuais designadas àquele repositório. Réplicas virtuais são uma frota única de computação descartável: o disco local de cada uma funciona como cache, reconstruível a qualquer momento, e pode servir leituras, escritas, ou as duas coisas.
O estado durável do repositório vive em dois lugares separados:
- Objetos Git (packs e dados auxiliares de aceleração de leitura) ficam no Azure Blob Storage.
- Referências e o manifesto de packs (a lista de packs que compõem o repositório) ficam num serviço de log replicado dedicado, batizado de Ref-CAS ("Reference Compare-and-Swap").
No fluxo de escrita, uma réplica virtual indexa o pack recebido, sobe ele para o Blob Storage e só então registra uma transação no Ref-CAS, que lista o pack no manifesto e atualiza as referências. No fluxo de leitura, a réplica confere a versão da referência com o Ref-CAS, baixa do Blob Storage só os packs que faltam no cache, e serve a resposta dali.
Por que o Git precisou de um serviço só para referências
A escolha mais contraintuitiva do projeto foi não deixar tudo no Blob Storage, apesar de o serviço de objetos ser barato, durável e escalar bem quando o tráfego se espalha por muitas chaves. O problema é o padrão de acesso das referências: numa branch concorrida, várias escritas competem para atualizar o mesmo ponteiro ao mesmo tempo, e isso não é o forte de armazenamento de objetos.
O GitHub testou duas abordagens antes de chegar ao Ref-CAS. A primeira indexava todas as referências de um repositório num único blob, com cada atualização sendo uma escrita condicional contra ele: correta e barata para leitura, mas o teto de escrita ficava em uma gravação por vez contra aquele blob só, o que na prática travava o throughput na casa das centenas de escritas por segundo.
A segunda abordagem dividia as referências em vários blobs de segmento, cada referência caindo num segmento por hash. Isso elevava o teto de escrita, mas trocava o problema de lugar: toda leitura passava a precisar checar todos os segmentos, e ficava tão lenta quanto o segmento mais devagar, justamente quando leituras superam escritas em ordens de grandeza.
Nenhuma das duas atendia a todos os requisitos, e foi daí que nasceu o Ref-CAS: um serviço de log replicado dedicado a referências, com cada atualização sendo um compare-and-swap confirmado por quorum. Uma transação trava só as referências que toca, confere se cada uma ainda tem o valor esperado pelo escritor, e só fica visível depois que a maioria das réplicas do log a registrar. Como agentes majoritariamente escrevem nas próprias branches, a maior parte das atualizações não disputa a mesma referência e replica em paralelo.
Cada commit no Ref-CAS ganha um número de sequência de log (LSN), e a versão do repositório é o LSN do commit mais recente. Numa leitura, a réplica virtual manda a versão que já tem: se ainda é a atual, a resposta não carrega referência nenhuma, e um repositório sem mudanças custa uma única comparação. Com isso, o GitHub diz conseguir transacionar estado de referência sozinho na casa das dezenas de milhares de operações por segundo.
Compactação fora do caminho de quem está lendo
Escalar escrita cria um problema de segunda ordem: cada push adiciona um pack novo ao Blob Storage, e, embora o Git sirva um repositório a partir de vários packs, cada pack a mais torna as buscas um pouco mais caras. Na arquitetura antiga do GitHub, a compactação rodava nas mesmas réplicas que atendiam tráfego, e precisava rodar em todas elas.
Na arquitetura nova, a compactação roda inteiramente em segundo plano, em nós dedicados que trabalham direto contra o armazenamento durável, usando o Ref-CAS para avisar as réplicas virtuais sobre o estado atualizado. Isso libera CPU e memória das réplicas virtuais quase inteiramente para servir requisições.
Cada nó de compactação assume, via lease, a posse de um subconjunto (shard) dos packs de um repositório, o que permite escalar a compactação horizontalmente. O nó acumula os packs novos de um shard num "segmento aberto" até bater um limite de quantidade, tamanho ou idade; aí ele sela o segmento, combina os packs num conjunto menor e maior, confere que os pacotes novos contêm exatamente os mesmos objetos dos originais, publica o resultado e só depois remove os packs antigos do manifesto.
O processo roda em paralelo para muitos shards ao mesmo tempo, então adicionar shards e nós aumenta a capacidade de compactação. O resultado, segundo o GitHub, é uma contagem de packs praticamente estável mesmo com o volume de pushes subindo.
Os números do teste interno
Em testes internos, o GitHub diz ter sustentado 5.000 agentes simultâneos trabalhando num único repositório, enviando 7.200 pushes por segundo, mantendo ao mesmo tempo latência de leitura consistentemente baixa. É um salto de pelo menos duas ordens de grandeza em relação às dezenas de escritas por segundo que hoje definem um repositório movimentado no GitHub.com, e foi esse o alvo de capacidade que a empresa definiu antes de desenhar o Rubicon: não planejar o próximo incremento, mas dar conta de um cenário cem vezes maior que o atual.
O que muda para quem desenvolve
Para quem só usa o GitHub pela CLI ou pela interface, o Git continua Git: git push, git fetch, git branch funcionam do mesmo jeito, com as mesmas proteções de branch e revisão de sempre. A mudança relevante não é de comando, é de garantia: repositórios que hoje sofrem com fila de CI ou commits atrasando por contenção de escrita têm, na proposta do GitHub, um teto de throughput muito mais alto pela frente, sem precisar de nenhuma migração especial.
Isso importa principalmente para times que já rodam agentes de IA abrindo PR, revisando código ou automatizando merges em paralelo num mesmo repositório, o cenário que motivou a reconstrução. Um projeto pequeno hoje pode, nas palavras do próprio GitHub, "pegar uma frota de agentes da noite para o dia" sem precisar de tratamento especial para aguentar. Vale também para monorepos grandes que concentram múltiplos serviços e times num único repositório: é exatamente nesse tipo de repositório que a contenção de escrita e o acúmulo de packs mais pesam na arquitetura antiga.
O que ainda está em aberto
O post do GitHub lista três frentes futuras: evoluir mais a arquitetura (ler só o objeto necessário em vez do pack inteiro, réplicas parciais, réplicas globais com staleness limitada, escalar a zero quando o repositório fica inativo), tornar operações de agente mais baratas (trabalhar sem clone completo, API de commit atômico multi-arquivo, streams de eventos em tempo real) e continuar contribuindo para o próprio Git upstream (clones parciais mais leves, remoção de gargalos de escala que ainda existem no código do Git, buscas de histórico mais rápidas via commit-graph).
Nenhuma dessas frentes tem data de entrega anunciada, e o GitHub não divulgou, neste post, quando a nova arquitetura passa a atender 100% dos repositórios do GitHub.com.
Fonte 1: The Github Blog (https://github.blog/engineering/architecture-optimization/inside-githubs-new-git-storage-architecture/)
Inside GitHub's new Git storage architecture - The GitHub Blog
Karthik Raman & Brian Celenza
November 5, 2026
|
16 minutes
Share:
Fonte: The Github Blog
Highlights
- GitHub suporta 5.000 agentes simultâneos em um repositório, com 7.200 pushes por segundo mantendo latência baixa
- Projeto Rubicon reconstruiu camada de armazenamento com dois princípios: minimizar coordenação e desacoplar armazenamento de computação
- Serviço Ref-CAS dedicado a referências resolve gargalo de escrita com compare-and-swap por quorum, sustentando dezenas de milhares de operações por segundo
- Para desenvolvedores, Git continua Git: mesmo git push, git fetch, git branch, mas com teto de throughput cem vezes maior
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Presidente da OpenAI diz que empresa pode estar pronta para IPO em 2027
Greg Brockman afirmou em conferência do Wall Street Journal que a OpenAI poderia fazer uma oferta pública em 2027, citando a virada do negócio enterprise em 2026. O timing interessa a quem levanta capital para IA no Brasil.