Ripple-65B Preview iguala modelos fechados em coding agentic com um décimo do custo

- Leitura
- 10 min
- Tabelas
- 1
- Fontes
- 1
A Ricursive Intelligence lançou o Ripple-65B Preview, modelo open-weight que bate concorrentes muito maiores no TerminalBench 2.1 e roda em hardware local como a DGX Spark da NVIDIA.
A Ricursive Intelligence, laboratório de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → que constrói sistemas autoaprimoráveis para projetar chips, lançou o Ripple-65B Preview. É a versão de uso geral do modelo proprietário que já roda internamente na plataforma de design de chips da empresa, segundo o anúncio oficial. O modelo tem 65 bilhões de parâmetros, foi pré-treinado com 12 trilhões de tokens e suporta até 1 milhão de tokens de contexto.
O motivo do destaque não é o tamanho, e sim o resultado: segundo a Ricursive, o Ripple-65B Preview atinge o estado da arte entre modelos open-weight americanos em coding agentic, superando concorrentes muitas vezes maiores. Para quem desenvolve no Brasil e hoje depende de APIs fechadas para tarefas de agente de código, isso abre uma rota diferente: um modelo que cabe em hardware menor e pode ser auditado, ajustado e hospedado sem depender de um provedor único.
Os números do TerminalBench 2.1
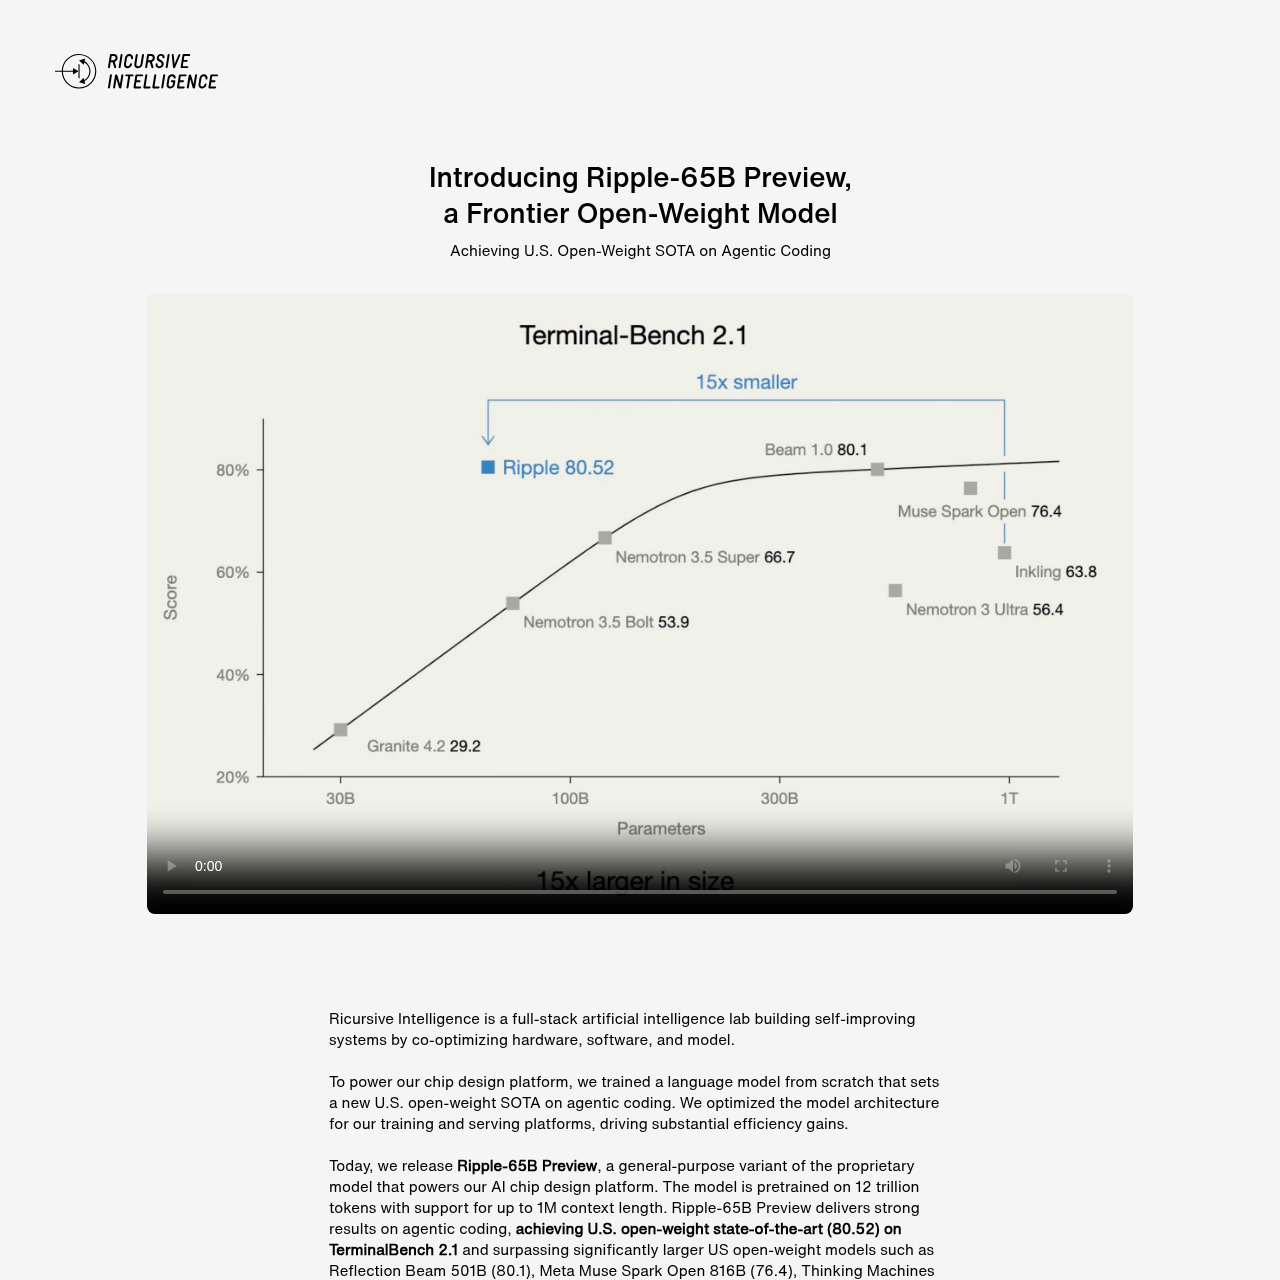
A métrica central do anúncio é o TerminalBench 2.1, benchmark que avalia modelos executando tarefas de agente em um terminal real. O Ripple-65B Preview marcou 80,52 pontos, o que a Ricursive classifica como SOTA open-weight nos Estados Unidos. A comparação com outros modelos abertos, todos substancialmente maiores, é o ponto central do release:
| Modelo | Parâmetros | TerminalBench 2.1 |
|---|---|---|
| Ripple-65B Preview | 65B | 80,52 |
| Reflection Beam | 501B | 80,1 |
| Meta Muse Spark Open | 816B | 76,4 |
| Thinking Machines Inkling | 975B | 63,8 |
| NVIDIA Nemotron 3 Ultra | 550B | 56,4 |
Ou seja: um modelo com um oitavo dos parâmetros do Reflection Beam entregou pontuação ligeiramente superior na mesma avaliação. Isso muda o cálculo de quem escolhe modelo pela relação entre capacidade e custo de inferência, não só pela nota no benchmark.
Treinar gastando um décimo
O ponto mais chamativo do anúncio é financeiro. A Ricursive diz ter desenvolvido e treinado o Ripple-65B Preview por US$ 32 milhões, cifra que inclui todo o ciclo de P&D: desenvolvimento da escada de pré-treinamento, mistura de dados, avaliações, geração de dados sintéticos, receita de pós-treinamento e a rodada final de treinamento. A empresa estima que esse valor seja um décimo do custo do SOTA open-weight anterior.
Para contextualizar a escala do setor, o anúncio cita declarações públicas de executivos do setor: em 2023, o CEO da OpenAI, Sam Altman, afirmou que o treinamento do GPT-4 custou mais de US$ 100 milhões; no ano seguinte, Dario Amodei, da Anthropic, projetou que modelos de fronteira chegariam a custar US$ 1 bilhão, com previsão de US$ 10 a 100 bilhões só em pré-treinamento até 2026-2027. Uma nota de rodapé do post menciona que concorrentes como a Reflection teriam se comprometido a pagar US$ 150 milhões por mês em computação no supercluster Colossus da SpaceX, com o Beam levando quatro semanas de pré-treinamento e mais quatro de pós-treinamento.
A eficiência aparece também na etapa de reforço: a Ricursive diz ter chegado aos 80,5 pontos no TerminalBench 2.1 com apenas 1,4 milhão de rollouts, cerca de 70 vezes menos do que o Reflection Beam precisou. Em vez de comprar dados de pós-treinamento, a empresa construiu seus próprios pipelines sintéticos, com filtragem de qualidade e métricas de cobertura, usando técnicas como truncated importance sampling e score centering.
Arquitetura dense, não MoE
Diferente da tendência recente de usar Mixture-of-Experts (MoE) para escalar modelos, a Ricursive optou por um Transformer dense modernizado. A decisão reduziu a complexidade de infraestrutura de treino e serving, segundo a empresa, que manteve MFU de 40% ao longo de todo o pré-treinamento e pós-treinamento, mesmo com sharding simples, sem kernels customizados e sem quantização.
O Ripple-65B Preview usa proporção thin-and-deep: d_model estreito de 5.120 e 80 camadas no total. Para compensar a profundidade e melhorar o raciocínio, a arquitetura superprovisiona cabeças de atenção, ajusta a proporção entre camadas de atenção local (SWA) e global, e reduz a janela do SWA. Outras técnicas somadas incluem FFN activation clipping, gated attention, NoPE global e value residuals.
A empresa também detalha o processo de laddering: partiu da escada de modelos do Olmo 3 (projeto aberto do Allen Institute for AI) e testou intervenções em escala pequena até consolidar uma receita que, segundo a Ricursive, melhora a eficiência de computação para código em até 16 vezes na escala de 4B parâmetros, comparada à escada original do Olmo 3.
Onde rodar, e por que isso importa aqui
O Ripple-65B Preview já está disponível no Hugging Face, na Together AI, na GMI Cloud e na OpenRouter; a Fireworks entrou no ar ainda no dia do anúncio. Para quem trabalha com infraestrutura de IA no Brasil, o dado mais prático é outro: o modelo foi desenhado para rodar com eficiência em dispositivos locais como a NVIDIA DGX Spark, hardware com FLOPs de computação altos mas largura de banda de memória menor do que aceleradores de datacenter.
Isso é relevante porque muitos times brasileiros enfrentam dois gargalos ao tentar hospedar modelos de agente de código: o custo de GPUs de datacenter e a latência de depender de uma API externa para tarefas intensivas, como agentes que leem e editam repositórios inteiros. Um modelo dense de 65B parâmetros, com footprint de memória menor que modelos de centenas de bilhões de parâmetros, é mais viável de rodar em workstations locais ou clusters menores, reduzindo a dependência de contratos de nuvem em dólar.
O custo de treinamento do GPT-4 superou US$ 100 milhões
No original: GPT-4 training costs exceeded $100 million
 Fonte: Hacker NewsFoto: 首相官邸ホームページ / Office of the Prime Minister of Japan Official Website, CC BY 4.0
O que ainda fica em aberto
O anúncio é da própria Ricursive e os números de benchmark, de custo e de rollouts vêm da empresa, sem validação independente publicada até o momento. O post também não detalha a licença de uso comercial dos pesos, nem publica pesos de todos os checkpoints citados na escada de experimentos (como as variantes v1.0 a v1.6). Para quem avalia adotar o modelo em produção, vale acompanhar se laboratórios terceiros reproduzem o resultado no TerminalBench 2.1 e se a Ricursive detalha a licença completa junto com os pesos no Hugging Face.
Fonte 1: Hacker News (https://www.ricursive.com/ripple)
Recursive Self-Improvement via AI for Chip Design & Chip Design for AI - Ricursive Intelligence
Introducing Ripple-65B Preview, a Frontier Open-Weight Model Achieving U.S. Open-Weight SOTA on Agentic Coding Ricursive Intelligence is a full-stack artificial intelligence lab building self-improving systems by co-optimizing hardware, software, and model.
To power our chip design platform, we trained a language model from scratch that sets a new U.S. open-weight SOTA on agentic coding. We optimized the model architecture for our training and serving platforms, driving substantial efficiency gains.
Today, we release Ripple-65B Preview , a general-purpose variant of the proprietary model that powers our AI chip design platform. The model is pretrained on 12 trillion tokens with support for up to 1M context length. Ripple-65B Preview delivers strong results on agentic coding, achieving U.S. open-weight state-of-the-art (80.52) on TerminalBench 2.1 and surpassing significantly larger US open-weight models such as Reflection Beam 501B (80.1), Meta Muse Spark Open 816B (76.4), Thinking Machines Inkling 975B (63.8), and NVIDIA Nemotron 3 Ultra 550B (56.4).
Ripple’s dense model architecture provides strong reasoning performance with low-latency token generation. The model’s small parameter envelope also enables it to run efficiently on local devices such as NVIDIA DGX Spark, which feature high compute FLOPs with low memory bandwidth relative to datacenter accelerators.
Ripple-65B Preview is available on Hugging Face , Together AI , GMI Cloud , and OpenRouter . Fireworks goes live later today. Achieving U.S. Open-Weight Frontier at One-Tenth Cost LLM pretraining is legendarily expensive. In 2023, OpenAI CEO Sam Altman said that GPT-4 training costs exceeded $100 million . In the following year, Dario Amodei said that frontier AI models can cost up to $1 billion to train, projecting that costs would rise to $10-100B by 2026 to 2027 for pretraining alone.
In contrast, we developed and trained Ripple-65B Preview for only $32M, which is one-tenth the cost of the previous open-weight SOTA on agentic coding , as estimated to the best of our knowledge. ¹ Note that $32M is our full R&D cost starting from scratch, including pretraining ladder development, data mixing, evals, debugging, synthetic data generation, posttraining recipe development, and the final hero pretraining and posttraining run.
Steep Ascent Reinforcement Learning Rather than investing in a brute-force RL climb, we carefully iterated on our SFT and RL recipes with a focus on compute efficiency. We opted not to buy any posttraining data, instead devising our own synthetic data pipelines, quality filtering, and coverage metrics.
Our mixed RL recipe uses truncated importance sampling , score centering , and linear length penalty with high-quality long-horizon synthetic environments. The RL tasks are tuned for our model capabilities, and we continuously added harder tasks as the model improved.
Modelos de IA de fronteira podem custar até US$ 1 bilhão para treinar, projetando que custos subirão para US$ 10-100B de 2026 a 2027 apenas em pré-treinamento
No original: frontier AI models can cost up to $1 billion to train, projecting that costs would rise to $10-100B by 2026 to 2027 for pretraining alone
 Fonte: Hacker NewsFoto: TechCrunch, CC BY 2.0
The end result was a steep RL climb from a strong initial SFT checkpoint. We reached a TerminalBench 2.1 score of 80.5 with only 1.4M rollouts, roughly 70x fewer rollouts than Reflection Beam, the prior SOTA. A Co-Designed Model Architecture Ripple-65B Preview’s architecture was designed to be trained and served efficiently on NVIDIA hardware.
A key objective was to make design decisions which reduce pretraining and posttraining infrastructure complexity while still enabling strong reasoning and agentic performance. Therefore, we chose to train a modernized dense Transformer model rather than use Mixture-of-Experts (MoE) like other labs. This decision quickly paid off, and we were able to train a strong model from scratch while maintaining a solid MFU (40%) throughout pretraining and posttraining, even with simple sharding, no custom kernels, and no quantization.
Ripple-65B Preview uses a thin-and-deep model aspect ratio, with a narrow d_model (5120) and 80 total layers. To improve reasoning performance, we overprovision the number of attention heads while increasing the SWA-to-global layer ratio and reducing SWA window size to compensate for the increased cost. In addition, we added FFN activation clipping , gated attention , global NoPE , and value residuals . Careful Model Laddering Led to Large Improvements We optimized Ripple’s pretraining recipe through a series of careful model laddering experiments.
Our starting point was Olmo 3’s model ladder , from which we tested interventions at small scale with a focus on improving coding capabilities. Our v1.0 ladder implemented StepFun batch size and learning rate scaling laws, and v1.1 implemented our new ladder which smoothly scales architectural dimensions and model depth. Ladder v1.2 switched from the post-norm baseline to pre+post norm, which was neutral at small scale but showed improvements starting at 4B.
Ladder v1.3 implemented sigmoid gated attention . Ladder v1.4 (2-stream mHC ) showed good results at smaller scale but did not improve at 4B scale, and was therefore rejected. Ladder v1.5 switched to global NoPE and added a final LR cooldown to zero, and ladder v1.6 added value residuals . In the final version, we switched to our custom pretraining dataset with substantially upsampled code.
Together, the compounded changes improved compute efficiency on code as measured by dolma_stack CE by up to 16x at 4B model scale. In other words, our final Ripple model ladder can be used to achieve similar code performance to the Olmo 3 ladder with 16x less compute .
Note that the slope of the Olmo 3 ladder baseline is shallower than ladder v1.0+, which shows that the compute efficiency improvement will increase with additional scale. Conclusion We built Ripple-65B Preview to begin closing the loop between models and the hardware that fuels them. An internal variant of this model powers our AI chip design platform, and we look forward to seeing the capabilities that emerge as we scale toward the frontier.
We were fortunate to build on top of existing open-source contributions, including those from the Olmo team at the Allen Institute for AI (AI2), Prime Intellect, RadixArk, and NVIDIA. A strong open-source ecosystem is also self-improving, where contributors strengthen the ecosystem, which in turn draws more contributors.
At Ricursive, we are selectively hiring exceptional researchers and engineers as we push the frontier of full-stack AI from model to silicon. If you’re interested, check out https://www.ricursive.com/careers . ¹ U.S. open-weight players like Reflection were reported to commit to $150M per month for compute at SpaceX Colossus to train their models. Reflection reported that Beam took 4 weeks to pretrain and 4 weeks to posttrain.
Fonte: Hacker News
Highlights
- Ripple-65B Preview atinge 80,52 no TerminalBench 2.1, superando Reflection Beam 501B com um oitavo dos parâmetros
- Ripple custou US$ 32 milhões para treinar, um décimo do anterior SOTA open-weight em coding agentic
- Modelo dense alcançou 80,5 pontos com apenas 1,4 milhão de rollouts, 70 vezes menos que Reflection Beam
- Disponível no Hugging Face, Together AI, GMI Cloud, OpenRouter e Fireworks desde o anúncio
- Mantém MFU de 40% ao longo do pré-treinamento sem kernels customizados ou quantização
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Canva corta 22% da equipe e reorganiza produto em meio à pressão por IA
Em carta aos funcionários, a CEO Melanie Perkins anunciou o primeiro grande corte de pessoal da história da empresa e uma reestruturação que funde times de produto, growth e plataforma.