Estudo do Ai2 mostra que LLMs falham ao avaliar se uma ideia de pesquisa é original
Um estudo do Allen Institute for AI testou seis modelos como
- Leitura
- 7 min
- Tabelas
- 1
- Fontes
- 1
Um estudo do Allen Institute for AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → testou seis modelos como
O padrão conhecido como LLM-as-judge virou peça comum em qualquer pipeline que usa IA para avaliar outra IA: notas de qualidade em RAG, triagem de pull requests, detecção de conteúdo duplicado, ranking de respostas de agentes. Um estudo publicado pelo Allen Institute for AI (Ai2) no blog do Hugging Face em 27 de outubro de 2026, assinado pelo jornalista Kyle Wiggers em nome da equipe do instituto, testa esse padrão num domínio específico, mas com implicações que vão muito além dele: será que um LLM consegue julgar com confiabilidade se uma ideia de pesquisa é original?
O artigo, chamado "Old Ideas, Novel Problems", nasce de um problema prático do próprio Ai2. O instituto desenvolve sistemas como o DataVoyager, o AutoDiscovery e o Theorizer, que ajudam pesquisadores a explorar dados, gerar hipóteses e sintetizar literatura científica. Para que esses sistemas sirvam de algo, as ideias que eles produzem precisam ser genuinamente novas, não apenas reembalagens de trabalho existente. Esse julgamento normalmente é delegado a outro LLM, o chamado "juiz de novidade" (novelty judge), e é exatamente essa peça que o estudo decidiu auditar.
Como o benchmark foi montado
A equipe construiu um pipeline automatizado em cima das revisões por pares da ICLR 2026, mas evitou usar aceitação do artigo como proxy de novidade (um paper pode ser aceito sem ser particularmente original, se for forte em outros aspectos). Em vez disso, minerou as próprias revisões em busca de trechos onde avaliadores discutiam explicitamente a originalidade da contribuição.
Daí saíram dois conjuntos: um pool de alta novidade com 154 ideias de artigos aceitos no top 10% de sua área, com revisores que elogiaram a novidade sem contestação; e um pool de baixa novidade com 145 ideias de artigos rejeitados no fundo do ranking, com revisores que questionaram a originalidade sem nenhuma defesa. Esses dois grupos formam o cenário Human-Only, que testa se um juiz LLM distingue ideias humanas com evidência forte de maior ou menor novidade.
Mas juízes de novidade são cada vez mais usados para avaliar ideias geradas por IA, não só por humanos. Por isso a equipe criou um segundo cenário, Human+Generated, pareando as mesmas 154 ideias humanas validadas com 154 ideias produzidas por um gerador de LLM simples, sem busca de literatura, ferramentas ou iteração. Um especialista revisou 30 desses pares manualmente e preferiu a ideia humana nos 30 casos, sem considerar nenhuma ideia gerada como novidade.
Uma troca de palavras no prompt derruba a precisão pela metade
O resultado mais chamativo do estudo não é sobre qual modelo é melhor, é sobre o quanto a avaliação depende de como a pergunta é feita. A equipe testou seis juízes (GPT-5.1, GPT-5.2, GPT-5.4, Claude Sonnet 4.5, Claude Opus 4.5 e Claude Opus 4.6) variando um fator de cada vez: prompt, orçamento de raciocínio, acesso a artigos relacionados, formato das ideias e quantas avaliações eram combinadas no veredito final.
No experimento mais extremo, o GPT-5.4 avaliou os mesmos pares Human+Generated com dois prompts diferentes. Um dizia ao modelo que revisores já haviam identificado qual das duas ideias era novidade e pedia para ele achar qual; o outro simplesmente perguntava qual ideia era mais nova. A troca derrubou a precisão de 93,5% para 40,9%, abaixo do acaso, e o modelo mudou de veredito em mais da metade dos pares que antes havia acertado.
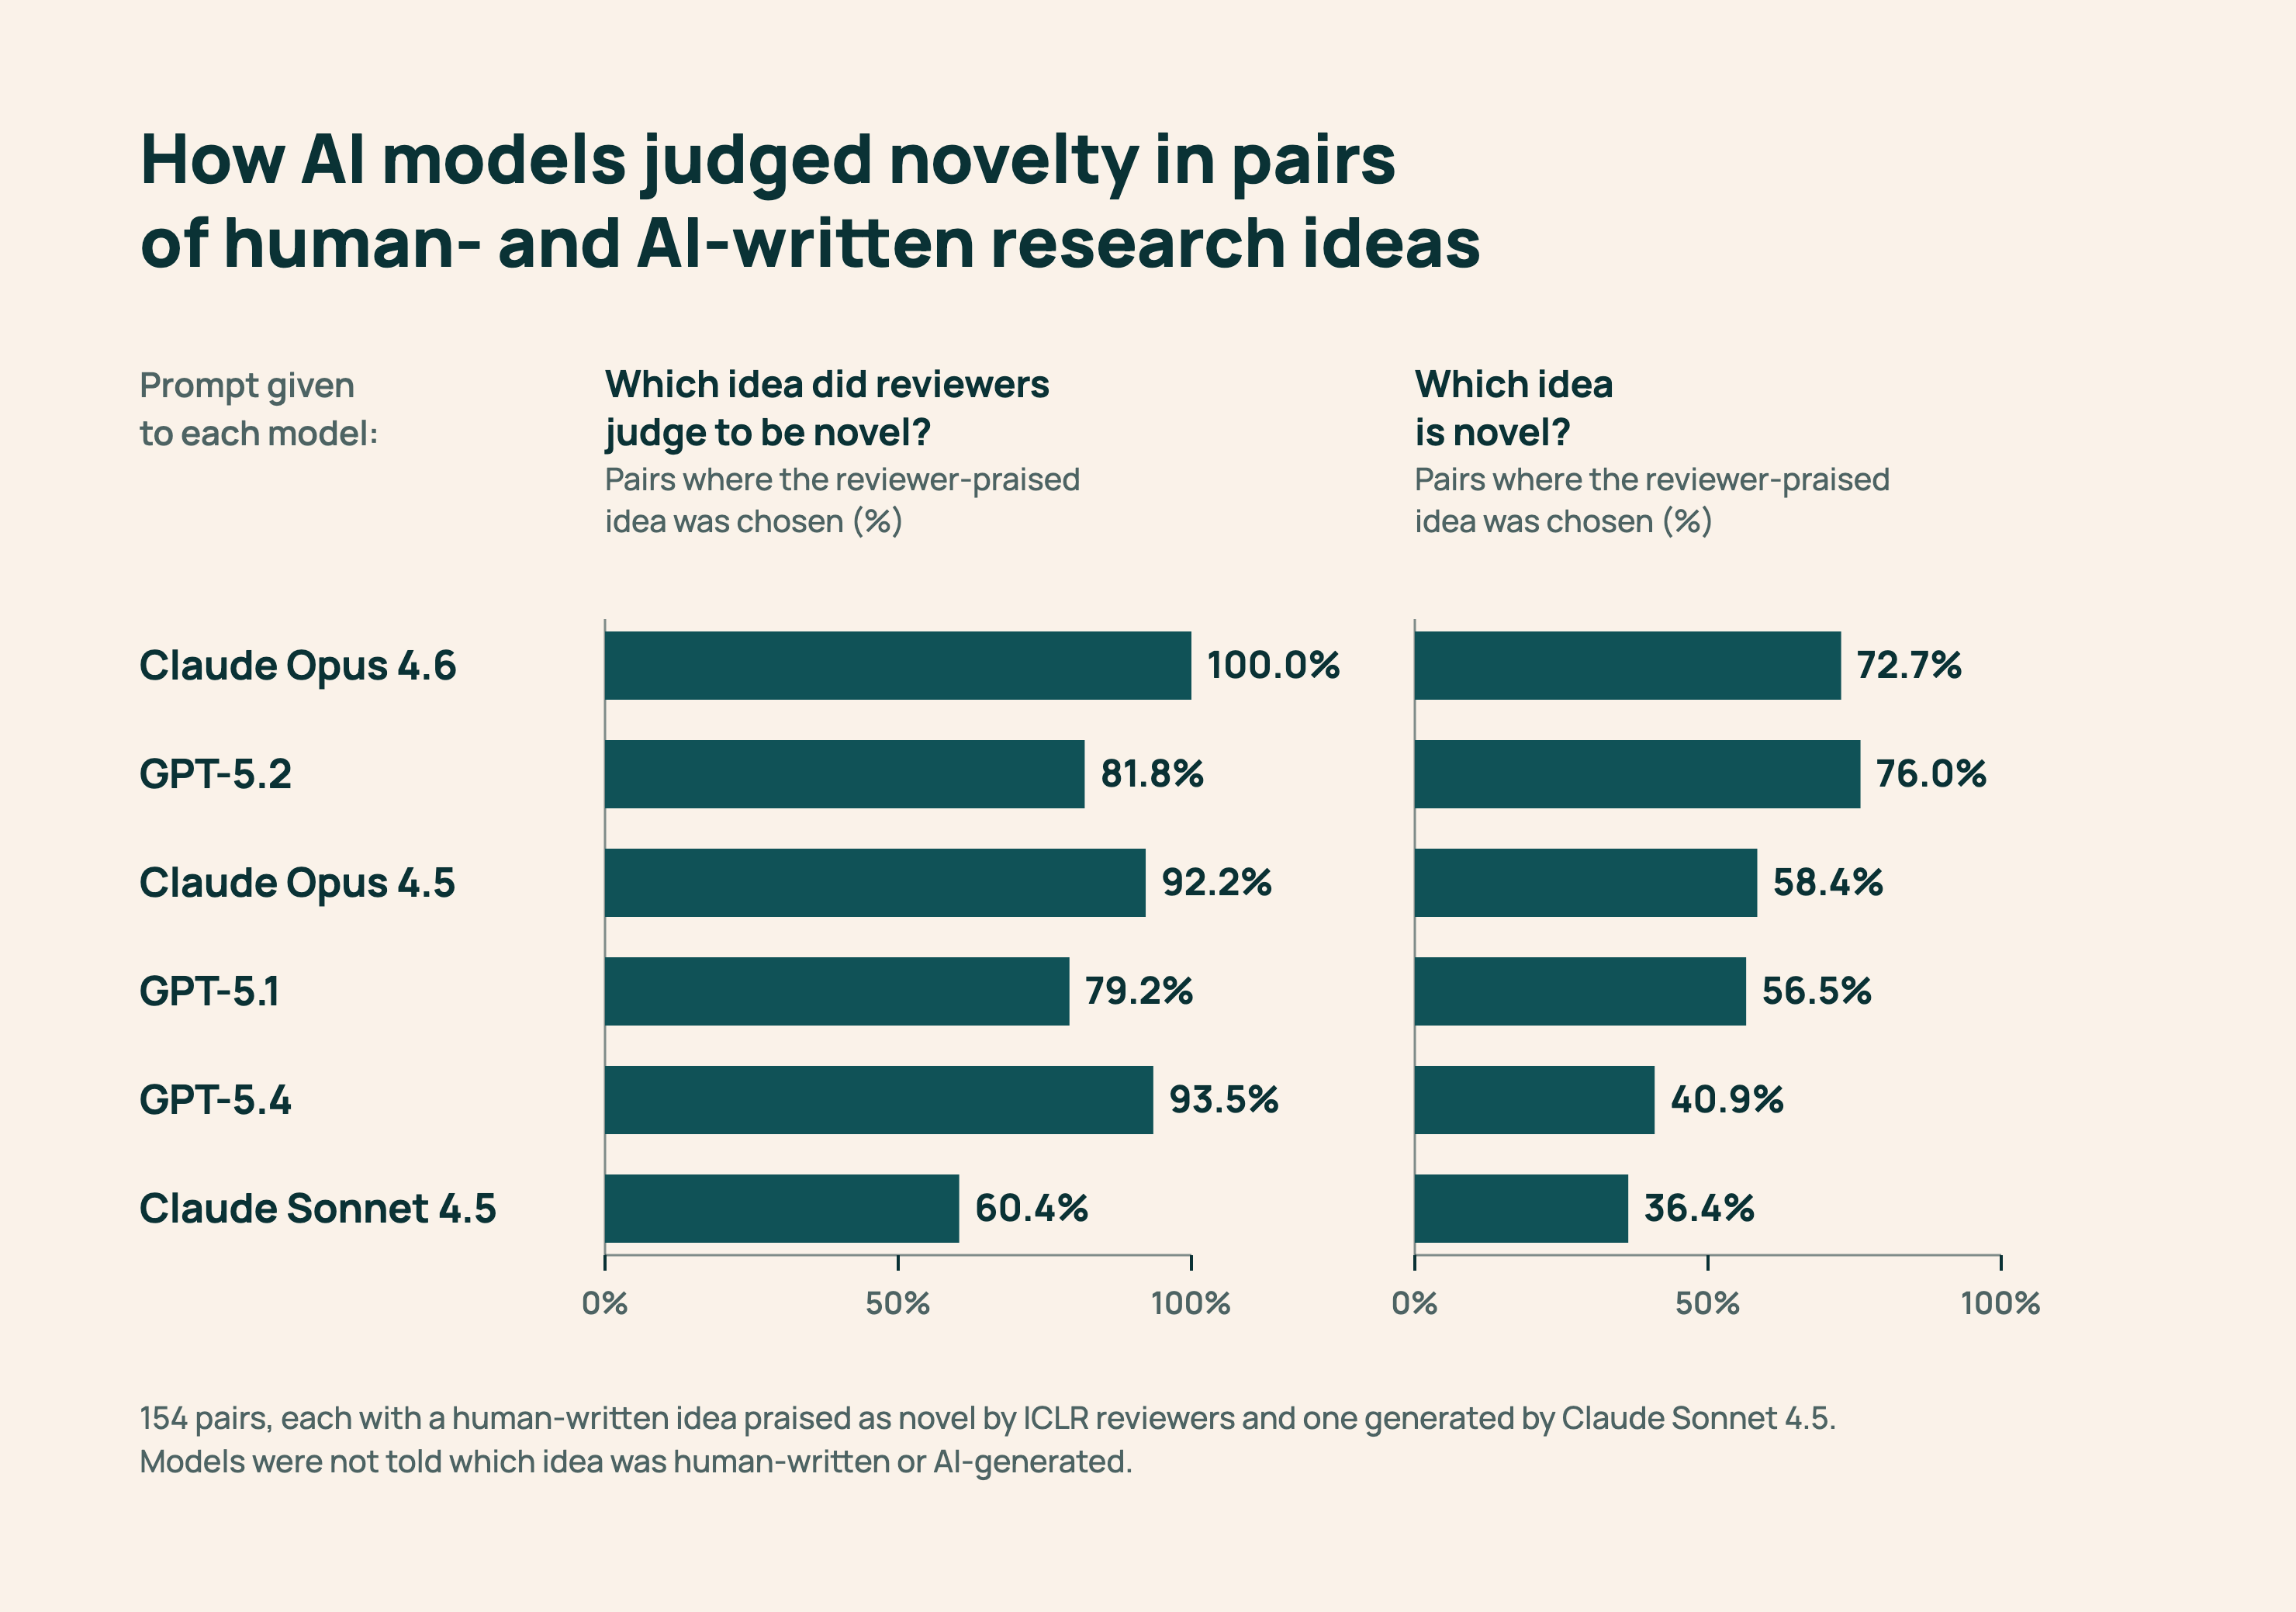
No cenário Human-Only, a mesma troca de prompt moveu a precisão em apenas cerca de 7 pontos percentuais, embora o Claude Opus 4.6 tenha oscilado 21 pontos nesse mesmo conjunto. Ou seja, um juiz que parece estável ao avaliar pesquisa escrita por humanos pode se comportar de forma completamente diferente diante de ideias geradas por IA, que é justamente o caso de uso que mais importa para quem está automatizando descoberta científica.
Se a IA vai desempenhar um papel maior na descoberta científica, precisamos de formas mais confiáveis de saber se ela está de fato propondo algo novo.
Equipe Ai2, autores do estudo "Old Ideas, Novel Problems"If AI is going to play a larger role in scientific discovery, we need more dependable ways to tell whether it is actually proposing something new.
Não existe um prompt universalmente melhor. Remover uma instrução que avisava o juiz para não tratar contribuições triviais como novidade melhorou a precisão de alguns modelos e piorou a de outros. Um prompt afinado para um modelo simplesmente não transfere para o próximo, o que é um problema sério para quem constrói avaliação automatizada pensando em trocar de modelo no futuro.
Mais busca e mais raciocínio não ajudaram
A hipótese óbvia seria que dar ao juiz acesso à literatura e mais orçamento de raciocínio resolveria o problema. O estudo testou exatamente isso: um juiz agêntico baseado em GPT-5.6 Sol, com orçamento de raciocínio extra-alto e busca iterativa ao vivo restrita ao arXiv, foi comparado com juízes de recuperação padrão que recebiam cinco resumos pré-selecionados.
O resultado inverteu a expectativa. O juiz agêntico atingiu 0,78 de macro-F1, 11 pontos atrás do Claude Opus 4.6 (0,89), e na mesma faixa de configurações mais simples com Claude Opus 4.5 e GPT-5.4, só que custando cerca de 10 vezes mais por decisão nos preços de API vigentes.
O mesmo padrão se repetiu ao comparar sistemas especializados contra uma linha de base simples:
| Avaliador | Macro-F1 | Custo por avaliação |
|---|---|---|
| Claude Opus 4.6, prompt simples, 3 votos | 0,854 | $2,59 |
| Idea Novelty Checker (recuperação + reranking) | 0,642 | $30,66 |
| Avaliador de novidade do AI Scientist (Sakana AI) | 0,772 | $82,05 |
A linha de base mais barata venceu os dois sistemas construídos especificamente para julgar novidade, por uma margem considerável e com cerca de um trigésimo do custo do concorrente mais caro. Para quem decide infraestrutura de avaliação em produção, isso é um dado duro: complexidade de pipeline não é proxy de qualidade de julgamento.
O que isso muda para quem usa LLM-as-judge no dia a dia
Esse estudo fala de novidade científica, mas o padrão que ele desmonta é o mesmo usado em avaliação de RAG, triagem automática de PRs duplicados, scoring de respostas de agentes e qualquer pipeline de CI que usa um LLM para decidir se uma saída é "boa" ou "nova" o suficiente. Três lições dão para transportar direto para esse contexto.
Primeiro, o prompt do juiz precisa ser validado contra um conjunto de verdade conhecida antes de entrar em produção, e revalidado toda vez que o modelo por trás muda. Um prompt que funciona com o Claude Opus 4.6 pode não funcionar com o GPT-5.4, e a diferença não aparece até alguém testar os dois lado a lado com dados rotulados.
Segundo, dar mais ferramentas ao juiz (busca, raciocínio estendido, agentes) não é garantia de mais precisão, e definitivamente não é garantia de custo-benefício melhor. Antes de pagar 10 vezes mais por uma configuração agêntica, vale medir se ela realmente supera um prompt simples com múltiplas chamadas e votação por maioria, que no estudo do Ai2 foi a opção mais eficiente.
Terceiro, o juiz precisa ser testado no tipo de conteúdo que ele vai realmente avaliar. Validar um avaliador só com exemplos escritos por humanos, quando ele vai julgar principalmente conteúdo gerado por IA (como no caso de PRs feitos com assistência de copiloto, ou de respostas geradas por outro modelo), é o mesmo erro metodológico que o estudo aponta: a estabilidade observada num cenário não se transfere para o outro.
Onde esse julgamento ainda não deve ser automático
O Ai2 disponibilizou benchmark, dados e código do pipeline junto com o paper, abertos para quem quiser reproduzir o teste em outras comunidades científicas ou treinar juízes mais robustos. Mas o próprio texto é claro ao dizer que a avaliação de novidade por LLM "continua sendo um problema aberto importante", e que a instabilidade medida não desaparece com mais escala de modelo ou mais busca.
Para qualquer time que hoje usa um LLM como juiz final de qualidade, originalidade ou duplicidade sem um conjunto de validação próprio por trás, o recado é direto: a confiança nesse veredito não deveria vir do nome do modelo, e sim de testes explícitos de sensibilidade a prompt, feitos com os dados que o sistema vai realmente encontrar em produção.
Fonte: Hugging Face Blog
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
MCP 2025-06-18 traz elicitation e saída estruturada para servidores em produção
A revisão 2025-06-18 do Model Context Protocol, publicada em junho de 2025, formalizou elicitation, saída estruturada e resource links, mas também removeu o batching de JSON-RPC. Quem já tem servidor MCP rodando precisa revisar transporte e autenticação antes de atualizar o SDK.