TABLESAMPLE no PostgreSQL amostra endereços, não linhas: por que isso pode distorcer sua query analítica
TABLESAMPLE promete respostas rápidas em tabelas gigantes, mas trabalha sobre endereços físicos de página, não sobre as linhas em si. Entender essa diferença evita contagens, médias e amostras de teste erradas.
TABLESAMPLE promete respostas rápidas em tabelas gigantes, mas trabalha sobre endereços físicos de página, não sobre as linhas em si. Entender essa diferença evita contagens, médias e amostras de teste erradas.
TABLESAMPLE promete respostas rápidas em tabelas gigantes, mas trabalha sobre endereços físicos de página, não sobre as linhas em si. Entender essa diferença evita contagens, médias e amostras de teste erradas.
Uma pergunta exploratória como "quantos pedidos foram enviados" não deveria custar uma varredura completa, mas sem índice sobre a coluna é exatamente isso que o PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → faz. Um artigo técnico publicado no blog boringSQL e republicado no agregador Planet PostgreSQL usa uma tabela orders de dois milhões de linhas para mostrar o custo disso: EXPLAIN (ANALYZE, BUFFERS) aponta leitura de 18.085 páginas (141 MB) só para contar linhas com status = 'shipped'. Numa tabela de 1 TB, isso significa ler 134 milhões de páginas do disco inteiras, mesmo que a resposta interesse apenas "aproximadamente".
O padrão SQL tem uma saída para esse tipo de pergunta: TABLESAMPLE. A cláusula entra logo depois do nome da tabela no FROM, e o resto da consulta roda apenas sobre o subconjunto de páginas escolhido.
SELECT id, status, created_at, amount
FROM orders TABLESAMPLE SYSTEM (1) REPEATABLE (7)
LIMIT 5;
O valor entre parênteses é uma porcentagem, não um número fixo de linhas: no material do autor, cinco sementes diferentes devolveram entre 18.107 e 20.416 linhas para o mesmo 1. Quem precisa de um número exato de linhas pode recorrer à extensão tsm_system_rows do contrib, que adiciona o método SYSTEM_ROWS(n). E como o cálculo roda sobre a amostra, count(*) e sum() precisam ser multiplicados de volta (por 100, no caso de 1%); médias, razões e extremos são lidos como vêm.
O que TABLESAMPLE realmente escolhe
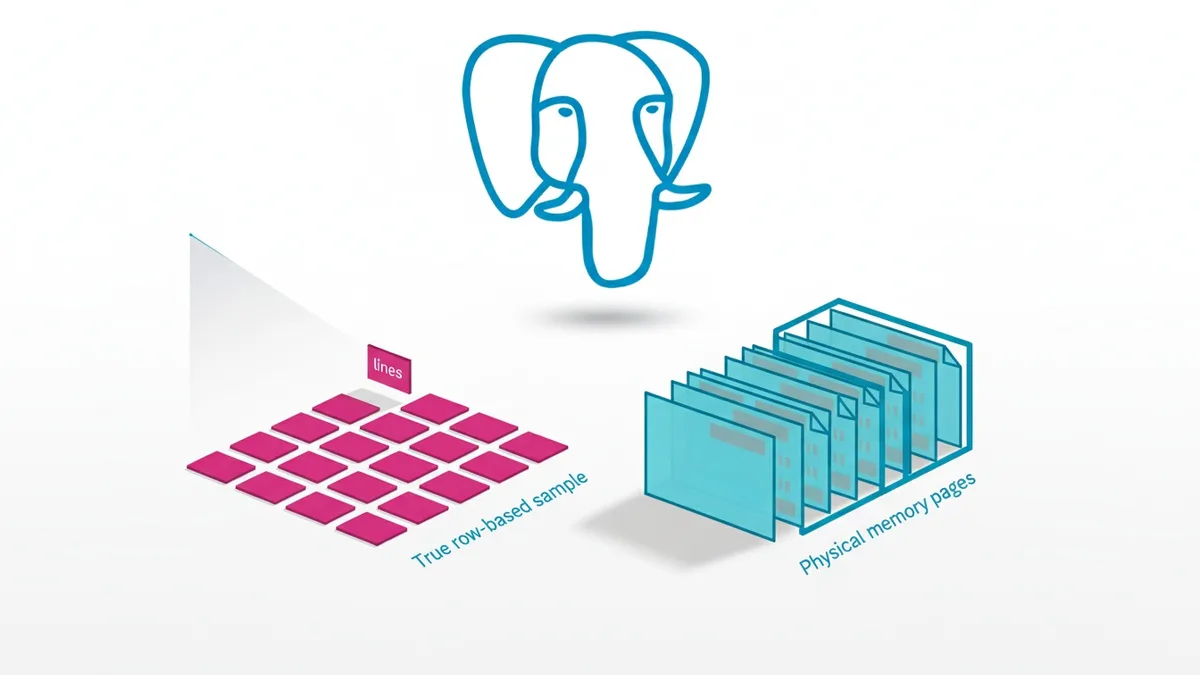
O ponto central do artigo, e o motivo de este texto merecer atenção de quem lida com Postgres em produção, é que nenhum dos dois métodos nativos escolhe linhas. Cada página de 8 kB guarda, logo após o cabeçalho, um array de ponteiros de linha (um por registro), e a dupla número da página + número do ponteiro forma o ctid daquela linha. SYSTEM e BERNOULLI fazem hash de partes diferentes desse endereço:
SYSTEM: faz hash apenas do número da página mais a semente. Se o hash cai abaixo do corte, a página inteira entra na amostra. Um "cara ou coroa" por página, nada por linha.BERNOULLI: faz hash do número da página, do ponteiro de linha e da semente. Um "cara ou coroa" por linha, o que obriga o PostgreSQL a abrir toda página para contar quantos ponteiros ela tem.
Essa diferença de mecanismo explica o custo observado no artigo: na tabela de teste, SYSTEM respondeu em 1,2 ms e BERNOULLI em 10,4 ms. SYSTEM é rápido porque decide por página inteira; BERNOULLI é mais caro porque sempre visita toda página, mesmo as que descarta quase por completo.
Por que a contagem funciona e o mínimo não
Refazendo a contagem de pedidos enviados com TABLESAMPLE SYSTEM (1), o plano de execução lê 177 páginas em vez de 18.085, e o resultado escalado (492 mil) fica próximo do real (500 mil). Até aqui, TABLESAMPLE cumpre a promessa.
O problema aparece quando a coluna amostrada tem relação com a ordem física das linhas. Na tabela de teste, os registros foram inseridos em ordem de created_at, um por segundo, de modo que cada página de aproximadamente 107 linhas corresponde a 107 segundos consecutivos. Pedir min(created_at) a uma amostra SYSTEM (1) seis vezes devolveu respostas entre 44 minutos e quase cinco horas de distância do valor real (2024-01-01 00:00:01), porque a amostra não é composta por 20 mil segundos espalhados: é cerca de 200 trechos curtos e contínuos da linha do tempo, um por página sorteada.
O autor também mostra que esse viés desaparece quando a tabela é embaralhada fisicamente (um CREATE TABLE ... AS SELECT * FROM orders ORDER BY random()): com cada página contendo segundos espalhados pelas três semanas inteiras, a mesma consulta volta a ficar a poucos minutos da verdade em toda repetição. BERNOULLI na tabela original, ordenada por tempo, também não sofre o mesmo problema, porque um cara ou coroa por ponteiro de linha nunca agrupa nada.
Em resumo: SYSTEM é mais rápido, mas qualquer coluna correlacionada com a ordem física de inserção (timestamp crescente, id sequencial, dados carregados em lote) sai distorcida. Para colunas sem relação com a posição física, como um valor monetário aleatório, as duas abordagens convergem para o mesmo resultado.
REPEATABLE fixa o endereço, não a linha
REPEATABLE (42) fixa a semente, o que fixa o hash e, portanto, os endereços sorteados. O que acontece com as linhas que ocupavam aqueles endereços depende do que a tabela sofre depois, e o artigo testa isso contra uma sequência de operações de manutenção:
| Operação | SYSTEM manteve | BERNOULLI manteve |
|---|---|---|
| Inserir 200 mil linhas | 17.595 de 17.595 | 19.800 de 19.800 |
| Apagar metade das linhas | 8.795 de 8.795 | 10.003 de 10.003 |
VACUUM | 8.795 de 8.795 | 10.003 de 10.003 |
UPDATE em toda linha | 8.740 de 8.795 | 109 de 10.003 |
VACUUM FULL | 113 de 8.795 | 113 de 10.003 |
CLUSTER com índice invertido | 0 de 8.795 | 95 de 10.003 |
Inserções e exclusões não movem linhas sobreviventes, então nada muda. VACUUM marca ponteiros mortos como livres e compacta os dados dentro da página, mas nunca renumera um ponteiro que ainda aponta para uma linha viva. VACUUM FULL e CLUSTER reconstroem a tabela inteira; todo endereço muda, e as duas amostras são praticamente refeitas do zero.
O caso do UPDATE é o mais revelador para quem lida com cargas de escrita intensas. O PostgreSQL nunca sobrescreve uma linha no lugar: grava uma nova versão e, quando a página tem espaço e nenhuma coluna indexada mudou, essa é uma HOT update, que não toca em nenhum índice. Como a nova versão fica na mesma página, SYSTEM nem percebe a troca. Mas a nova versão ganha um ponteiro de linha novo, e esse ponteiro é uma nova jogada de moeda para BERNOULLI, que descarta quase todas as linhas atualizadas e sorteia outras no lugar.
Quando a estabilidade importa, hasheie a chave
Para quem precisa de um subconjunto de desenvolvimento ou de teste que permaneça igual dia após dia, um endereço não serve essa garantia, porque atualizações e reconstruções movem linhas. Uma chave primária não se move, então o caminho é fazer hash da chave diretamente, fora do TABLESAMPLE:
SELECT * FROM orders
WHERE (hashint8extended(id, 42) & 1023) < 10;
hashint8extended faz hash de um bigint com uma semente; manter 10 de 1.024 baldes devolve cerca de 0,98% das linhas. No teste do artigo, essa abordagem manteve toda linha sobrevivente em cada etapa (9.916 de 9.916 depois de exclusão, UPDATE, VACUUM FULL e CLUSTER incluídos), e sua dispersão em 200 sementes sobre avg(created_at) ficou igual à de BERNOULLI, sem o viés de agrupamento por página.
O custo é uma varredura completa, já que o hash precisa ser calculado para toda linha: 44,4 ms de forma serial, 21,5 ms com dois workers paralelos no material testado. Para um subconjunto consultado com frequência, um índice de expressão sobre (hashint8extended(id, 42) & 1023) (14 MB na tabela de teste) transforma isso num bitmap scan de 8,5 ms, com a semente fixada na própria definição do índice.
Joins: a amostra não se propaga
TABLESAMPLE se aplica a uma única tabela do FROM; não é possível aplicá-lo sobre um join ou uma subquery (é erro de sintaxe). Amostrar apenas o lado orders de um join com customers acelera o scan daquela tabela (202 páginas em vez de 18.085), mas o hash sobre customers ainda lê suas 222 páginas inteiras, porque TABLESAMPLE só encolhe a tabela em que está escrito.
No exemplo do artigo, a consulta completa ficou 3,3 vezes mais rápida, não 90 vezes, porque o restante do custo está na tabela que a amostra nunca tocou. O scan de amostra também roda sempre no processo líder: o plano perde o paralelismo, por maior que seja a tabela.
Amostrar as duas pontas do join ao mesmo tempo parece a saída óbvia, mas o autor mostra que é quase inútil: de um join real de dois milhões de linhas, amostrar orders e customers com SYSTEM (1) independentemente manteve apenas 288 pares, porque uma linha sorteada só encontra seu par quando as duas amostras de página coincidem para aquele registro. Quando um par de tabelas amostradas precisa continuar unível por chave estrangeira, fazer hash da chave estrangeira dos dois lados, como na técnica da seção anterior, é o caminho que preserva o relacionamento.
Qual usar, e quando não usar nenhum
O artigo resume a escolha em três linhas de decisão, e vale reproduzi-las porque cobrem a maioria dos casos reais:
SYSTEM: para um número rápido sobre uma coluna sem relação com a ordem física de inserção.BERNOULLI: quando pode haver essa relação e ler a tabela inteira uma vez é aceitável.- Chave com hash (fora do
TABLESAMPLE): quando o subconjunto precisa ser o mesmo amanhã, ou precisa manter chaves estrangeiras íntegras entre tabelas.
Nenhuma das três serve para um subconjunto filtrado: a amostra é escolhida antes do WHERE rodar, então o filtro só recorta um sorteio que já foi feito, o que explica por que count(DISTINCT customer_id) sobre uma amostra de 1% nunca recupera clientes cujos pedidos caíram todos em páginas perdedoras. Vale lembrar também que o próprio ANALYZE constrói as estatísticas de pg_stats a partir de um amostrador de blocos com semente que o usuário não controla, o que explica por que planos mudam de leve entre execuções mesmo sem alteração nos dados.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
PostgreSQL trata kill -9 em uma conexão como se fosse um crash geral
Um post publicado em 9 de outubro de 2026 por Shridhar Khanal explica por que um sinal enviado a um único processo filho do PostgreSQL derruba todas as conexões e dispara recuperação de WAL, mesmo sem ninguém reiniciar o serviço.