PostgreSQL e NUMA na nuvem: por que huge pages e CAP_SYS_NICE decidem a performance
- Leitura
- 7 min
- Tabelas
- 1
- Fontes
- 1
Série de quatro artigos do consultor Chris Travers, da Stormatics, mostra como a arquitetura NUMA continua afetando o PostgreSQL mesmo dentro de VMs e containers, e por que ignorar isso custa latência em produção.
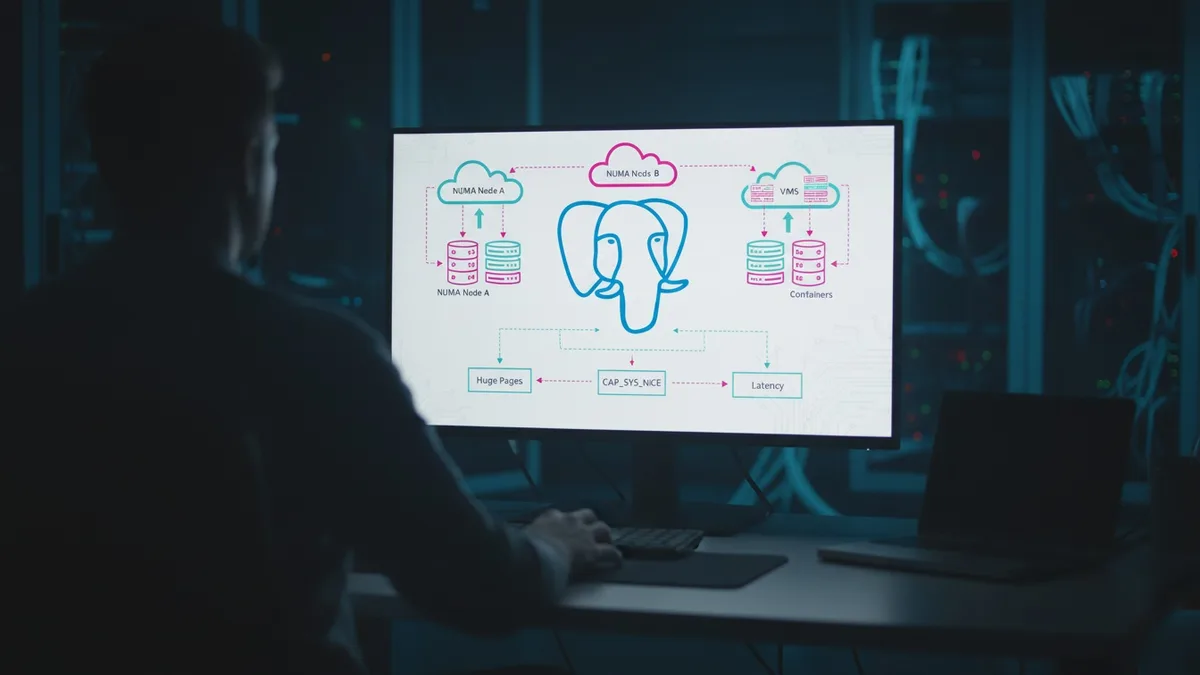
O consultor Chris Travers, da Stormatics, publicou em 6 de novembro de 2026 o quarto e último artigo de uma série dedicada a um problema que a maioria dos times descobre tarde demais: como o PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → se comporta em sistemas NUMA, especialmente quando esses sistemas estão escondidos atrás de uma VM de cloud ou de um container Kubernetes↳Kubernetes18 conteúdosGerenciamento de infraestrutura multicloud com Kubernetes proporciona otimização e economiaDevSecOps · set 2021Azure Kubernetes Services – AKS: referências gratuitas e dicas para solução de problemas comunsDevSecOps · abr 2019Kubernetes em produção: o que ninguém te conta e você aprende tarde demaisDev (Back & Front) · abr 2026Ver tudo em DevSecOps →. Segundo o autor, é comum que equipes gastem meses aprendendo os fundamentos de NUMA na marra, no meio de um incidente de performance. Este último texto fecha a série tratando exatamente do cenário que a maior parte dos bancos em produção hoje enfrenta: Postgres rodando dentro de virtualização, não em hardware nu.
Para quem administra banco de dados no Brasil, isso é relevante porque praticamente nenhuma instância relevante de PostgreSQL roda mais direto sobre metal. Está em uma VM da AWS, do Azure ou do GCP, ou dentro de um pod Kubernetes rodando sobre essa VM. A camada de virtualização não elimina o problema de NUMA: ela só o torna menos visível e mais fácil de errar.
O detalhe de página que a maioria ignora
Travers recapitula um ponto técnico que já havia trabalhado nos artigos anteriores da série: nós NUMA dividem a memória do sistema entre controladores físicos, e um núcleo que acessa memória fora do seu nó local paga o preço de uma requisição ao controlador secundário. O Linux, por padrão, aloca memória em páginas de 4 KB; huge_pages usa páginas de 2 MB. O PostgreSQL, por sua vez, usa páginas de shared buffer de 8 KB, a menos que seja compilado com opções diferentes.
A consequência prática: sem huge pages, uma única página de shared buffer do Postgres pode ficar dividida entre duas páginas do sistema operacional e, se essas alocações forem intercaladas, entre dois nós NUMA diferentes. O escalonador do Linux até tenta mover processos para perto da memória que eles mais acessam (ou vice-versa), mas isso tem custo e não é garantia. O PostgreSQL 18 trouxe otimizações específicas para sistemas NUMA, mas a fonte é direta: elas só entregam ganho real quando combinadas com huge pages habilitadas.
O hypervisor decide o que a VM enxerga, não o hardware real
Em ambientes virtualizados, a VM não vê necessariamente a topologia física da máquina hospedeira. Hypervisors como o KVM mapeiam dinamicamente o hardware subjacente e podem apresentar à VM uma configuração NUMA arbitrária, que não corresponde ao arranjo real dos controladores de memória.
Travers aponta um padrão comum entre provedores de cloud: VMs grandes costumam expor múltiplos nós NUMA para a aplicação (neste caso, o Postgres) poder fazer suas próprias otimizações. Em resumo: VMs pequenas normalmente enxergam um único nó NUMA, mas isso não significa que o acesso à memória seja sempre local, porque o escalonador por trás continua podendo mover alocações e processos sem aviso.
Isso derruba uma suposição comum em times de infraestrutura: a de que, se a VM só mostra um nó NUMA, o problema simplesmente não existe. Ele existe no nível físico, só não é visível nem controlável de dentro da VM.
Em teoria isso é bastante seguro, já que o namespacing deve impedir que o container veja processos externos, mas representa um ponto adicional de ataque possível caso existam outras vulnerabilidades.
No original: In theory this is pretty safe since namespacing should prevent the container from seeing outside processes, but it does represent an additional possible security attack point should other vulnerabilities exist.
Containers dividem kernel, não hardware
A segunda camada de virtualização discutida no artigo é a de containers. Diferente de um hypervisor, tecnologias como Docker e Kubernetes não virtualizam hardware: elas virtualizam o sistema operacional, usando cgroups e namespaces do Linux para dar a cada container a ilusão de um sistema de arquivos e um conjunto de recursos próprios.
O ponto central aqui é de segurança, e ele tem implicação direta para quem quer habilitar otimizações de NUMA dentro de um container: como todos os containers compartilham o mesmo kernel em execução, dar acesso irrestrito de root a um container é um risco de escape e comprometimento do host inteiro. Por isso, orquestradores de container restringem por padrão o que o usuário root pode fazer lá dentro.
De onde vem essa restrição
Travers conta a origem técnica da restrição, que remonta à série 2.2 do kernel Linux, no fim dos anos 1990. Até então, o usuário root era tratado como caso especial, isento das limitações impostas a usuários comuns.
- A partir da série 2.2, o kernel passou a usar o sistema de
capabilitiesdo POSIX em vez de tratar root como exceção; - Root passou a receber todas as capabilities por convenção, mas elas podem ser retiradas dele ou concedidas a outros usuários;
- A capability relevante para NUMA é
CAP_SYS_NICE, que permite definir afinidade de CPU, políticas de alocação NUMA e funções de gerenciamento de memória relacionadas; - Em sistemas Illumos e SmartOS, o conceito equivalente se chama "privileges", não "capabilities".
Sem CAP_SYS_NICE, um processo dentro de um container Docker ou de um pod Kubernetes simplesmente não consegue aplicar as otimizações de afinidade que o PostgreSQL 18 foi desenhado para aproveitar.
O trade-off entre performance e superfície de ataque
Habilitar CAP_SYS_NICE resolve o problema de afinidade, mas não é gratuito do ponto de vista de segurança. Na avaliação do próprio Travers:
Em teoria isso é bastante seguro, já que o namespacing deve impedir que o container veja processos externos, mas representa um ponto adicional de ataque possível caso existam outras vulnerabilidades.
Chris Travers, StormaticsIn theory this is pretty safe since namespacing should prevent the container from seeing outside processes, but it does represent an additional possible security attack point should other vulnerabilities exist.
Essa é a decisão real que recai sobre times de plataforma: aceitar uma capability adicional habilitada em produção, com todo o escrutínio de segurança que isso exige, em troca de ganho mensurável de latência. Não é uma troca que se faz por padrão em todo workload; é uma troca que se avalia caso a caso, dependendo de quão sensível o banco é a latência e de quão crítico é o ambiente multi-tenant do cluster.
Boas práticas por camada
A fonte organiza as recomendações em dois níveis, o da VM e o do container, e vale reproduzi-las separadas porque elas resolvem problemas diferentes:
| Camada | Recomendação | Por quê |
|---|---|---|
| VM (cloud) | Sempre habilitar huge_pages | Reduz o risco de uma página de shared buffer ficar dividida entre nós NUMA, compensando a dificuldade do hypervisor em garantir localidade |
| VM (cloud) | Checar se a VM expõe múltiplos nós NUMA | VMs grandes costumam expor; tratá-las como qualquer sistema NUMA físico, já que em geral estão fixadas (pinned) a nós específicos |
| Container | Considerar pinning a nós NUMA específicos | Em Kubernetes ou Docker com múltiplos bancos na mesma VM, fixar cada um a um nó garante a melhor performance possível se memória e processos couberem ali |
| Container | Considerar habilitar CAP_SYS_NICE | Necessário para a aplicação (o Postgres) definir afinidade de CPU e política de memória por conta própria |
No nível de container, a ativação é direta: via flag --cap-add em docker run, via lista cap_add no arquivo de docker compose, ou especificando a capability adicional no manifesto do Kubernetes.
O que isso muda para quem roda Postgres em produção aqui
Para uma operação típica no Brasil, com banco em uma VM gerenciada de cloud ou em um cluster Kubernetes gerenciado (EKS, AKS, GKE ou equivalente on-premises), a lição prática da série de Travers é checar três coisas antes de escalar verticalmente para resolver um problema de latência: se huge_pages está de fato habilitado no Postgres, se a instância de VM contratada expõe topologia NUMA (instâncias maiores tendem a expor, as menores não necessariamente ajudam mesmo quando dizem que sim) e se os containers que rodam o banco têm CAP_SYS_NICE quando pinning for a estratégia escolhida.
Em resumo: quando a aplicação já está sofrendo com p99 de latência alto ou timeouts intermitentes em um banco grande, vale revisar a configuração NUMA antes de assumir que o problema é índice, query ou hardware insuficiente. É exatamente o tipo de causa raiz que passa despercebida porque fica entre duas camadas: a VM não mostra a topologia real, e o DBA não necessariamente pensa em capabilities de container.
Isso não é uma recomendação universal. Em VMs pequenas, workloads que não são sensíveis a latência de cauda, ou ambientes de desenvolvimento e homologação, o ganho de mexer em pinning NUMA e liberar CAP_SYS_NICE dificilmente compensa a complexidade operacional e o aumento de superfície de ataque que isso introduz. A análise de plano de execução e de índice continua sendo o primeiro passo antes de qualquer ajuste de infraestrutura; NUMA é a camada seguinte, não a primeira, e só vale a pena investigar quando o gargalo já foi isolado no nível de query e ainda assim persiste.
Fonte: Planet PostgreSQL
Highlights
- PostgreSQL 18 traz otimizações NUMA que só funcionam com huge pages habilitadas
- Sem huge pages, uma página de shared buffer pode ficar dividida entre nós NUMA diferentes, aumentando latência
- VMs pequenas em cloud mostram um nó NUMA, mas não garantem acesso local à memória
- CAP_SYS_NICE em containers permite aplicar afinidade de CPU, mas amplia superfície de ataque
- Revisar configuração NUMA antes de assumir que problema é índice, query ou hardware insuficiente
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Thermocline propõe tiering como alternativa a sharding em réplica MongoDB sem memória
Prova de conceito da Percona testa uma camada de tiering na frente de um replica set MongoDB saturado, sem mudar a aplicação, e mede ganhos de até 5,2x em operações por segundo.