UUIDv4 como chave primária derruba inserts em até 38% no Postgres, revela teste com 100 milhões de linhas
Teste publicado por Nikolay Samokhvalov compara UUIDv4, UUIDv7 e bigint como chave primária em três tabelas idênticas no Postgres e mede o custo real de cada uma em inserts, WAL e tamanho de índice.
- Leitura
- 8 min
- Código
- 1
- Fontes
- 1
Teste publicado por Nikolay Samokhvalov compara UUIDv4, UUIDv7 e bigint como chave primária em três tabelas idênticas no Postgres↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → e mede o custo real de cada uma em inserts, WAL e tamanho de índice.
O Postgres 18 trouxe a função uuidv7() nativa, que gera identificadores ordenáveis conforme a RFC 9562. Mesmo assim, boa parte das tabelas em produção ainda define id uuid default gen_random_uuid(), ou seja, UUIDv4: 122 bits aleatórios sem nenhuma relação com a ordem de inserção. A pergunta que todo modelador de dados deveria fazer antes de aceitar esse default é simples: uma chave primária aleatória realmente importa?
Um teste conduzido por Nikolay Samokhvalov, publicado no blog da PostgresAI e discutido com Kirk Wolak no episódio 194 do podcast Postgres.FM, responde com números. A conclusão central: enquanto o índice cabe em memória, a diferença é irrelevante. Quando ele não cabe mais, o custo aparece em três frentes distintas, e cada uma delas tem implicação prática para quem desenha o schema.
Como o teste foi montado
A metodologia evita o erro clássico de comparar chaves em servidores diferentes sem controlar variáveis. Foram criadas três versões da mesma tabela events, idênticas exceto pela chave primária: UUIDv4, UUIDv7 e bigint (via generated always as identity). Cada uma recebeu os mesmos índices secundários em user_id e created_at, a mesma carga via pgbench com 16 clientes rodando um INSERT por transação, e synchronous_commit = on.
O ambiente rodou Postgres 18.6 sob cgroup com memória limitada (1,5 GiB ou 3 GiB, dividida entre shared_buffers e cache de página), justamente para forçar o índice a ultrapassar a memória disponível sem precisar esperar uma tabela na casa do terabyte. Sete execuções em servidores de nuvem, com cada hipótese escrita antes da primeira linha inserida, segundo o autor.
Em memória, a chave não importa
Enquanto o índice da chave primária cabe em shared_buffers, o tipo de chave não muda a taxa de inserção: UUIDv4 rodou entre 0,95 e 1,10 vezes a taxa de UUIDv7 em quatro servidores diferentes. Isso explica por que tantos benchmarks rápidos, feitos com poucos milhões de linhas, concluem que "UUIDv4 é tranquilo". O gargalo nesse regime é o flush do commit, compartilhado entre os 16 clientes, não o índice.
O problema aparece depois. No teste, UUIDv4 começou a cair por volta de 26 milhões de linhas, exatamente o ponto em que seu índice ultrapassa 1 GiB de shared_buffers. A queda é acentuada até cerca de 65 milhões de linhas, quando os índices de chave aleatória somados ultrapassam o limite de 3 GiB de cache, e depois se estabiliza em declínio lento.
O número que importa: 0,62 a 0,69
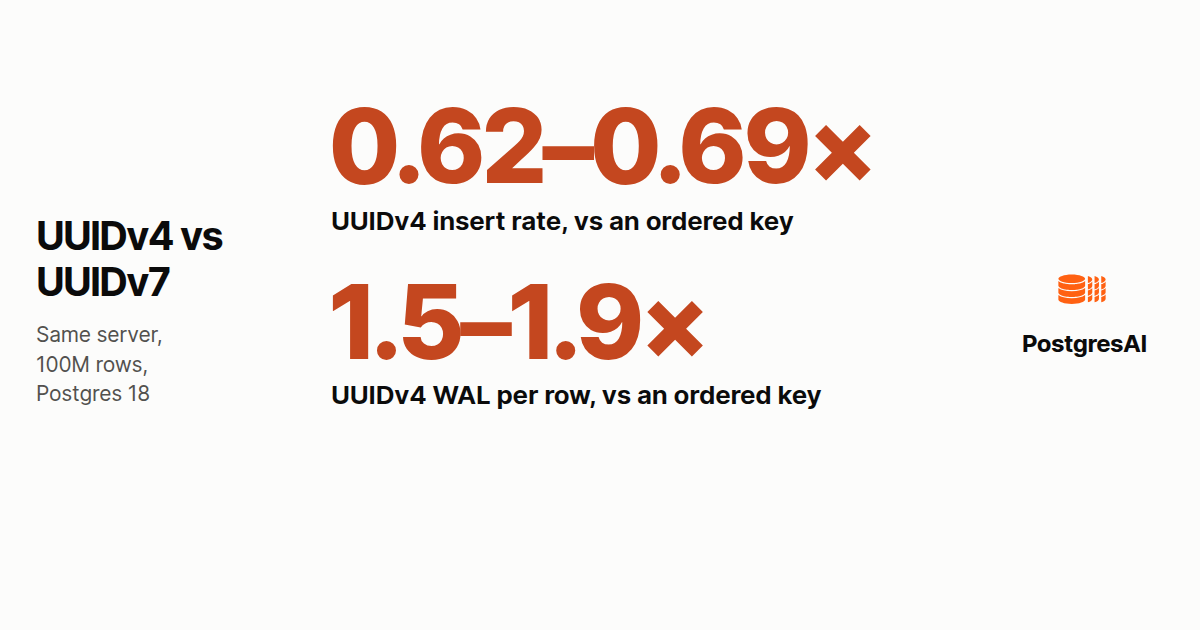
No patamar de 100 milhões de linhas, já fora da memória, UUIDv4 inseriu a uma taxa de 0,62 a 0,69 em relação à chave ordenada no mesmo servidor: 0,64 a 0,69 contra UUIDv7 e 0,62 contra bigint. Em português direto: até 38% mais lento para gravar a mesma linha, só porque a chave primária é aleatória.
A razão é estrutural. Um B-tree mantém as chaves em ordem, então uma chave nova vai para a folha onde ela se encaixa. Com UUIDv7 ou bigint, toda inserção cai na folha mais à direita, que nunca sai da memória. Com UUIDv4, a inserção pode cair em qualquer folha do índice inteiro, o que transforma o índice completo no working set da tabela.
Na prática, cada insert de UUIDv4 fora do cache custa uma leitura de página e, frequentemente, a escrita de uma página suja despejada antes, e é o próprio backend↳Back-end49 conteúdosIntegração front-end com backend: 7 decisões que evitam caos entre APIs, BFF e GraphQLDev (Back & Front) · abr 2026Como criar uma FAKE API REST para testes — JSONPlaceholderDev (Back & Front) · set 2025Construindo um aplicativo de bate-papo de IA simples com Spring AI e AngularDev (Back & Front) · jul 2025Ver tudo em Dev (Back & Front) → do cliente que faz esse trabalho enquanto a transação espera. Samokhvalov mediu essa divisão: em um servidor, metade do tempo extra de UUIDv4 foi gasto no flush do commit e a outra metade em I/O do arquivo de dados.
Kirk Wolak resumiu o debate sobre como chamar esse efeito no gráfico, que no desenho parece mais uma rampa do que um degrau:
Uma colina de performance.
Kirk Wolak, no episódio 194 do podcast Postgres.FMA performance hill.
Mas ele mesmo completou que, para quem deixava de entregar o trabalho a tempo e passa a não entregar mais, o efeito prático continua sendo o de um precipício.
O WAL paga a conta duas vezes
A segunda frente de custo é o WAL, e ela não depende de memória, e sim de quantas folhas do índice cada ciclo de checkpoint toca. Com full_page_writes = on, a primeira mudança em uma página depois de um checkpoint grava uma imagem completa dela no WAL; mudanças seguintes até o próximo checkpoint gravam apenas registros pequenos.
UUIDv7 e bigint seguem tocando a mesma folha mais à direita: pagam uma imagem completa e depois inserem muitas linhas nela de graça. UUIDv4 espalha as inserções por quase todas as folhas tocadas no ciclo, então cada imagem completa é amortizada por poucas linhas. Resultado medido entre 90 e 100 milhões de linhas: UUIDv4 escreveu de 1,5 a 1,9 vez mais WAL por linha do que a chave de referência, no mesmo servidor.
Isso tem consequência direta para quem opera standbys ou paga por armazenamento de I/O em nuvem:
- Um ciclo de checkpoint mais longo (de 5 para 30 minutos, no teste) reduziu o WAL por linha de UUIDv4 em 39%, mas não mudou a razão entre UUIDv4 e UUIDv7 de forma perceptível
wal_compression = lz4ajudou pouco (7% de redução), porque uma folha cheia de UUIDs aleatórios comprime mal- Em uma simulação de Aurora Standard a 1.000 inserts/s, aplicada sobre os contadores medidos, a leitura extra de UUIDv4 custaria entre 457 e 486 dólares a mais por mês depois que o índice ultrapassa o cache da instância
- Em um standby, replay de WAL pausado e depois retomado mostrou UUIDv4 2,4 vezes mais lento por linha antes do limite de memória do primário, e 5,5 vezes mais lento depois
Índice maior, mesmo com a mesma quantidade de chaves
UUIDv4 e UUIDv7 ocupam o mesmo espaço por entrada no índice, 28 bytes contra 20 bytes de um bigint. A diferença de tamanho total vem do preenchimento das folhas: uma inserção aleatória em uma folha cheia a divide ao meio, e as duas metades ficam parcialmente vazias. No teste, as folhas de UUIDv4 ficaram em média 68% cheias (perto do clássico ln 2 para inserções aleatórias em B-tree), contra o fillfactor padrão de 90% em UUIDv7 e bigint.
O resultado prático: um índice de UUIDv4 que cresceu organicamente fica 33% maior do que um índice equivalente de UUIDv7. Um REINDEX devolve o tamanho de UUIDv7, mas novas inserções aleatórias voltam a dividir as folhas compactadas.
UUIDv7 também tem custo, e isso importa para modelagem
Adotar UUIDv7 sem entender suas particularidades é trocar um problema por outro, menor mas real:
- Vaza a hora de criação: os primeiros 48 bits são um timestamp em milissegundos, e o Postgres 18 ainda adiciona uma fração de submilissegundo. Quem decodifica os bits sabe quando aquela linha foi criada
- Tem menos entropia: um valor de
uuidv7()no Postgres 18 carrega 62 bits aleatórios (64 em builds de macOS e Windows), contra 122 do UUIDv4. Não use como segredo ou token em URL que concede acesso - Deleção aleatória também causa bloat: apagar 30% das linhas mais antigas e recarregar não cresceu o índice, mas apagar 30% de linhas aleatórias deixou a chave primária 1,30 vez maior, porque novas chaves nunca reocupam folhas antigas
- Skew de relógio entre clientes degrada a ordenação: com clientes cujos relógios variavam ±60 segundos entre si, o índice ficou com apenas 69% de preenchimento e 45% das folhas fora de ordem. A recomendação do autor é gerar
uuidv7()no servidor, não na aplicação
Um ganho que compensa boa parte disso é o particionamento por tempo mantendo a busca por id. Como o timestamp está embutido na chave, uma tabela particionada por RANGE em id permite que o planejador faça partition pruning mesmo em uma busca simples por id = $1: o teste mediu 41 mil buscas por segundo contra 2,6 mil em uma tabela UUIDv4 particionada por created_at, que precisa visitar todas as partições.
Migrar uma tabela existente
Como o tipo de coluna continua sendo uuid, trocar o gerador de uma tabela já em produção não exige reescrita: é um ALTER TABLE sobre o default, que pega um lock ACCESS EXCLUSIVE por pouco tempo. Para não travar atrás de uma transação longa, o autor recomenda lock_timeout baixo com retentativa:
set lock_timeout = '500ms'; -- aumente se precisar
alter table events alter column id set default uuidv7();
Isso só funciona se os inserts dependem do default da coluna; se a aplicação gera o id explicitamente, é ela que precisa mudar. Os valores antigos continuam sendo UUIDv4, e uuid_extract_timestamp() retorna NULL para eles, então qualquer código que leia a hora a partir do id precisa tratar as duas versões (uuid_extract_version() diferencia uma da outra).
Quando não compensa trocar
Em tabelas pequenas, cujo índice jamais vai sair de shared_buffers, a troca de UUIDv4 para UUIDv7 não entrega ganho perceptível, segundo os próprios números do teste. Em aplicações que já geram id no cliente antes de qualquer validação no banco, trocar o gerador sem resolver o problema de skew de relógio pode anular boa parte do benefício. E onde o id é exposto publicamente como token de acesso, a redução de entropia de UUIDv7 é um motivo real para manter UUIDv4, ou migrar para um esquema de token separado da chave primária.
Fora desses casos, o teste sustenta uma recomendação de modelagem concreta: em tabelas que crescem além de algumas dezenas de milhões de linhas, uma chave primária aleatória não é só uma escolha estética de identificador, é uma decisão de desempenho de I/O e de WAL que se paga, ou se cobra, conforme a tabela cresce.
Fonte: Planet PostgreSQL
Highlights
- UUIDv4 inseriu a 0.62-0.69x a velocidade de chaves ordenadas em 100 milhões de linhas no Postgres 18.6
- Teste de Nikolay Samokhvalov usou cgroup para limitar memória e forçar índice além do cache
- UUIDv4 escreveu 1.5-1.9x mais WAL por linha que UUIDv7 entre 90-100 milhões de linhas
- Índice de UUIDv4 cresceu 33% maior que UUIDv7 equivalente por espalhamento em folhas
- Adotar UUIDv7 requer gerar no servidor Postgres, não na aplicação, para evitar skew de relógio
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Polar Proxy divide transação aberta no PostgreSQL entre primária e réplica
Um artigo técnico do blog da Awide Labs detalha como o Polar Proxy manda leituras de uma transação PostgreSQL aberta pra réplica sem perder snapshot, locks ou a consistência de read committed.